[ZooKeeper] 2 – ZooKeeper 服务 和 内部工作原理

本章节内容:

  • 理解 ZooKeeper 架构

  • 认识 ZooKeeper 的数据模型

  • ZooKeeper 的操作

    • 数据操作
    • ACL 权限控制
    • Watch 监控
  • 理解 ZooKeeper 的内部工作原理


其中,数据模型是最重要的,很多 ZooKeeper 中典型的应用场景都是利用这些基础模块实现的。比如我们可以利用数据模型中的临时节点和 Watch 监控机制来实现一个发布订阅的功能。


ZooKeeper Service

ZooKeeper 作为一个分布式一致性协调框架,给出了在分布式环境下一致性问题的工业解决方案,目前流行的很多开源框架技术背后都有 ZooKeeper 的身影。开发中我们应该如何使用 ZooKeeper?在这之前,我们先要对 ZooKeeper 的基础知识进行全面的掌握。


ZooKeeper 以高可用的集群方式提供集中服务, ZooKeeper 集群被称为 Ensemble(合唱团).

img

The members of the ensemble are aware of each other's state. This means that the current in-memory state, transaction logs, and the point-in-time copies of the state of the service are stored in a durable manner in the local data store by the individual hosts that together form the ensemble.


ZooKeeper 数据模型

下面部署一个开发测试环境,并在上面做一些简单的操作。来探索 ZooKeeper 的数据模型:

配置文件

tickTime=2000
dataDir=/var/lib/zookeeper
clientPort=2181

操作 Zookeeper


启动 Zookeeper

$ bin/zkServer.sh start

完整的写法bin/zkServer.sh conf/zoo.cfg

默认使用zoo.cfg作为配置文件


查看进程是否启动

$ jps
4020 Jps
4001 QuorumPeerMain

查看状态:

$ bin/zkServer.sh status
ZooKeeper JMX enabled by default
Using config: /opt/module/zookeeper-3.4.10/bin/../conf/zoo.cfg
Mode: standalone

启动客户端:

$ bin/zkCli.sh

完整的写法: bin/zkCli.sh -server 127.0.0.1:2181


退出客户端:

[zk: localhost:2181(CONNECTED) 0] quit

停止 Zookeeper

$ bin/zkServer.sh stop

配置参数解读

Zookeeper 中的配置文件 zoo.cfg 中参数含义解读如下:

  • tickTime =2000:通信心跳数,Zookeeper 服务器与客户端心跳时间,单位毫秒

    Zookeeper 使用的基本时间,服务器之间或客户端与服务器之间维持心跳的时间间隔,也就是每个 tickTime 时间就会发送一个心跳,时间单位为毫秒。它用于心跳机制,并且设置最小的 session 超时时间为两倍心跳时间。(session 的最小超时时间是 2*tickTime)

  • initLimit =10:LF 初始通信时限

    集群中的 Follower 跟随者服务器与 Leader 领导者服务器之间初始连接时能容忍的最多心跳数(tickTime 的数量),用它来限定集群中的 Zookeeper 服务器连接到 Leader 的时限。


  • syncLimit =5:LF 同步通信时限

    集群中 Leader 与 Follower 之间的最大响应时间单位,假如响应超过 syncLimit * tickTime,Leader 认为 Follwer 死掉,从服务器列表中删除 Follwer。

  • dataDir:数据文件目录+数据持久化路径

    主要用于保存 Zookeeper 中的数据。

  • dataLogDir:日志文件目录Zookeeper 保存日志文件的目录

    zoo-sample.cfg 中没有, 需要额外添加

  • clientPort =2181:客户端连接端口

    监听客户端连接的端口。


这样单机版的开发环境就已经构建完成了,接下来我们通过 ZooKeeper 提供的 create 命令来创建几个节点,分别是:“/locks”,“/servers”,“/works”:

create /locks
create /servers
create /works

ZooKeeper 命名空间的层级结构

最终在 ZooKeeper 服务器上会得到一个具有层级关系的数据结构,非常像 Linux 中的文件系统,有一个根目录,下面还有很多子目录。如下图所示:

w:12em

ZooKeeper 的数据模型有一个根节点(/),根节点下可以创建子节点,并在子节点下可以继续创建下一级节点。ZooKeeper 树中的每一层级用斜杠(/)分隔开,且只能用绝对路径(如“get /work/task1”)的方式查询 ZooKeeper 节点,而不能使用相对路径。


为什么 ZooKeeper 客户端的操作中不支持使用相对路径呢?

因为 ZooKeeper 在底层实现的时候,用节点的完整路径来作为 key 缓存节点数据以提高性能。如果使用相对路径,那么就需要在客户端进行路径拼接,这样会增加客户端的开销,降低性能。


znode 节点类型与特性

知道了 ZooKeeper 的数据模型是一种树形结构,就像在 MySQL 中数据是存在于数据表中,ZooKeeper 中的数据是由多个数据节点最终构成的一个层级的树状结构,和我们在创建 MySOL 数据表时会定义不同类型的数据列字段,ZooKeeper 中的数据节点也分为持久节点、临时节点、有序节点三种类型:


1、持久节点 persistent

我们第一个介绍的是持久节点,这种节点也是在 ZooKeeper 最为常用的,几乎所有业务场景中都会包含持久节点的创建。之所以叫作持久节点是因为一旦将节点创建为持久节点,该数据节点会一直存储在 ZooKeeper 服务器上,即使创建该节点的客户端与服务端的会话关闭了,该节点依然不会被删除。如果我们想删除持久节点,就要显式调用 delete 函数进行删除操作。


2、临时节点 ephemeral

接下来我们来介绍临时节点。从名称上我们可以看出该节点的一个最重要的特性就是临时性。所谓临时性是指,如果将节点创建为临时节点,那么该节点数据不会一直存储在 ZooKeeper 服务器上。当创建该临时节点的客户端会话因超时或发生异常而关闭时,该节点也相应在 ZooKeeper 服务器上被删除。同样,我们可以像删除持久节点一样主动删除临时节点。


h:12em

在平时的开发中,我们可以利用临时节点的这一特性来做服务器集群内机器运行情况的统计,将集群设置为“/servers”节点,并为集群下的每台服务器创建一个临时节点“/servers/host”,当服务器下线时该节点自动被删除,最后统计临时节点个数就可以知道集群中的运行情况。如图所示.


3、有序节点 sequential

最后我们再说一下有序节点,其实有序节点并不算是一种单独种类的节点,而是在之前提到的持久节点和临时节点特性的基础上,增加了一个节点有序的性质。所谓节点有序是说在我们创建有序节点的时候,ZooKeeper 服务器会自动使用一个单调递增的数字作为后缀,追加到我们创建节点的后边。例如一个客户端创建了一个路径为 works/task- 的有序节点,那么 ZooKeeper 将会生成一个序号并追加到该节点的路径后,最后该节点的路径为 works/task-1, 以后重复创建时序号将递增。通过这种方式我们可以直观的查看到节点的创建顺序。


h:12em

实际有序节点的编号从 works/task-0000000000 开始, 并递增


zookeeper 3.5.x 中新引入了 container 节点 和 ttl 节点

  1. container 节点用来存放子节点,如果 container 节点中的子节点为 0 ,则 container 节点在未来(60s 后)会被服务器删除。
  2. ttl 节点默认禁用,需要通过配置开启, 如果 ttl 节点没有子节点,或者 ttl 节点在 指定的时间内没有被修改则会被服务器删除。

上述这几种数据节点虽然类型不同,但 ZooKeeper 中的每个节点都维护有这些内容:一个二进制数组(byte data[]),用来存储节点的数据、ACL 访问控制信息、子节点数据(`因为临时节点不允许有子节点,所以其子节点字段为 null),除此之外每个数据节点还有一个记录自身状态信息的字段 stat。下面我们详细说明节点的状态信息。


节点的状态结构

每个节点都有属于自己的状态信息,这就很像我们每个人的身份信息一样,我们打开之前的客户端,执行 stat /zk_test,可以看到控制台输出了一些信息,这些就是节点状态信息。


每一个节点都有一个自己的状态属性,记录了节点本身的一些信息,


bg fit


数据节点的版本

这里我们重点讲解一下版本相关的属性,在 ZooKeeper 中为数据节点引入了版本的概念,每个数据节点有 3 种类型的版本信息,对数据节点的任何更新操作都会引起版本号的变化。ZooKeeper 的版本信息表示的是对节点数据内容、子节点信息或者是 ACL 信息的修改次数。


ZooKeeper API 操作

ZooKeeper's API:

Operation Description
create Creates a znode in a specified path of the ZooKeeper namespace
delete Deletes a znode from a specified path of the ZooKeeper namespace
exists Checks if a znode exists in the path
getChildren Gets a list of children of a znode
getData Gets the data associated with a znode
setData Sets/writes data into the data field of a znode
getACL Gets the ACL of a znode
setACL Sets the ACL in a znode
sync Synchronizes a client's view of a znode with ZooKeeper

ZooKeeper 还支持通过名为 multi 的操作批量更新 znodes。这一组批量操作要么全部成功,要么全部失败。

ZooKeeper APIs 中的更新操作,如delete或setData,必须指定要更新的 znode 的版本号。(设置为-1 则不对版本进行校验)

版本号可以通过 exists()调用返回的状态信息中获取。


Read and Write operation in ZooKeeper

h:16em


  • 读请求:在客户端当前连接的 ZooKeeper 服务器本地处理。

  • 写请求: These are forwarded to the leader and go through majority consensus before a response is generated.

    • majority consensus(多数共识): 一般情况下,ZooKeeper 集群中的服务器数量为奇数,这样可以保证 majority consensus 的一致性。例如,当 ZooKeeper 集群中有 3 台服务器时,只要有 2 台服务器同意,就可以保证 majority consensus 的一致性。当 ZooKeeper 集群中有 5 台服务器时,只要有 3 台服务器同意,就可以保证 majority consensus 的一致性。(超过半数)

ZooKeeper Watch 操作

现在让我们来学习 ZooKeeper 又一关键技术——Watch 监控机制,并用它实现一个发布订阅功能。


发布订阅: 订阅者订阅某个主题,当主题有更新时,订阅者会收到通知。如:

  • 订阅者订阅了某个新闻网站的新闻,当网站有新闻更新时,订阅者会收到通知。
  • 订阅者订阅了某个电商网站的商品,当网站有商品更新时,订阅者会收到通知。
  • 订阅者订阅了某个微博用户的动态,当用户有动态更新时,订阅者会收到通知。
  • 订阅者订阅了某个微信公众号的文章,当公众号有文章更新时,订阅者会收到通知。
  • 订阅者订阅了某个微信群的消息,当群里有消息更新时,订阅者会收到通知。

Watch(监听器) 是一种简单的机制,让客户端获得关于 ZooKeeper 集合中变化的通知。客户端可以在读取特定 znode 上设置的监听。对于 znode(客户端在其上注册了监听器)的任何更改,监听器都会向已注册的客户端发送通知。


Znode 的更改事件包括:

  • Znode 本身的数据变化
  • 以及其下的子节点变化。

设置的监听器一经触发就会移除。因此如果客户端希望再次收到通知,则必须重新设置监听。

另外当连接会话过期时,客户端将与服务器断开连接,相关的监听器也将被删除。


对于在指定 znode 上注册的监听器, 会触发事件通知的操作有:

  • 对 znode 数据的任何更改,例如使用 setData 操作将新数据写入 znode 的数据字段时。

  • 对 znode 子节点的任何更改。例如,使用 delete 操作删除 znode 的子节点。

  • 创建或删除当前的 znode。


监听和通知机制

h:16em


Watch 机制如何实现

正如我们可以通过点击视频网站上的”收藏“按钮来订阅我们喜欢的内容,ZooKeeper 的客户端也可以通过 Watch 机制来订阅当服务器上某一节点的数据或状态发生变化时收到相应的通知,我们可以通过向 ZooKeeper 客户端的构造方法中传递 Watcher 参数的方式实现:

new ZooKeeper(String connectString, int sessionTimeout, Watcher watcher)

上面代码定义了一个了 ZooKeeper 客户端对象实例,并传入三个参数:

  • connectString 服务端地址
  • sessionTimeout:超时时间
  • Watcher:监控事件

这个 Watcher 将作为整个 ZooKeeper 会话期间的上下文 ,一直被保存在客户端 ZKWatchManager 的 defaultWatcher 中。

除此之外,ZooKeeper 客户端也可以通过 getData、exists 和 getChildren 三个接口来向 ZooKeeper 服务器注册 Watcher,从而方便地在不同的情况下添加 Watch 事件:etData(String path, Watcher watcher, Stat stat)


知道了 ZooKeeper 添加服务器监控事件的方式,下面我们来讲解一下触发通知的条件。ZooKeeper 的 znode 相关的状态和事件包括有:


Watch 机制的底层原理

ZooKeeper 的 Watch 机制是通过 ZKWatchManager 来实现的,它是 ZooKeeper 类的内部类,负责管理所有的 Watcher。


ZKWatchManager 中有三个 HashMap,分别用于存储数据 Watcher、子节点 Watcher 和存在 Watcher。

  • dataWatches:用于存储所有的数据 Watcher,它是一个 HashMap,key 是 znode 的路径,value 是一个 WatcherSet,它是一个 HashSet,用于存储对该 znode 的所有数据 Watcher。

  • childWatches:用于存储所有的子节点 Watcher,它也是一个 HashMap,key 是 znode 的路径,value 是一个 WatcherSet,它是一个 HashSet,用于存储对该 znode 的所有子节点 Watcher。

  • existWatches:用于存储所有的存在 Watcher,它也是一个 HashMap,key 是 znode 的路径,value 是一个 WatcherSet,它是一个 HashSet,用于存储对该 znode 的所有存在 Watcher。


从设计模式角度出发来分析其底层实现:


Watch 机制理解为是分布式环境下的观察者模式。所以接下来我们就以观察者模式的角度点来看看 ZooKeeper 底层 Watch 是如何实现的。

h:14em


实现观察者模式最核心或者说关键的代码就是创建一个列表来存放观察者。
而在 ZooKeeper 中则是在客户端和服务器端分别实现两个存放观察者列表,即:ZKWatchManager 和 WatchManager。其核心操作就是围绕着这两个展开的


客户端 Watch 注册实现过程

我们先看一下客户端的实现过程,在发送一个 Watch 监控事件的会话请求时,ZooKeeper 客户端主要做了两个工作:

  1. 标记该会话是一个带有 Watch 事件的请求
  2. 将 Watch 事件存储到 ZKWatchManager

我们以 getData 接口为例。当发送一个带有 Watch 事件的请求时,客户端首先会把该会话标记为带有 Watch 监控的事件请求,之后通过 DataWatchRegistration 类来保存 watcher 事件和节点的对应关系:

public byte[] getData(final String path, Watcher watcher, Stat stat){
  ...
  WatchRegistration wcb = null;
  if (watcher != null) {
    wcb = new DataWatchRegistration(watcher, clientPath);
  }
  RequestHeader h = new RequestHeader();
  request.setWatch(watcher != null);
  ...
  GetDataResponse response = new GetDataResponse();
  ReplyHeader r = cnxn.submitRequest(h, request, response, wcb);
  }

之后客户端向服务器发送请求时,是将请求封装成一个 Packet 对象,并添加到一个等待发送队列 outgoingQueue 中:

public Packet queuePacket(RequestHeader h, ReplyHeader r,...) {
    Packet packet = null;
    ...
    packet = new Packet(h, r, request, response, watchRegistration);
    ...
    outgoingQueue.add(packet);
    ...
    return packet;
}

最后,ZooKeeper 客户端就会向服务器端发送这个请求,完成请求发送后。调用负责处理服务器响应的 SendThread 线程类中的 readResponse 方法接收服务端的回调,并在最后执行 finishPacket()方法将 Watch 注册到 ZKWatchManager 中:

private void finishPacket(Packet p) {
        int err = p.replyHeader.getErr();
        if (p.watchRegistration != null) {
            p.watchRegistration.register(err);
        }
       ...
}

服务端 Watch 注册实现过程

Zookeeper 服务端处理 Watch 事件基本有 2 个过程:

  1. 解析收到的请求是否带有 Watch 注册事件
  2. 将对应的 Watch 事件存储到 WatchManager

FinalRequestProcessor 类中的 processRequest 函数:
当 getDataRequest.getWatch() 值为 True 时,表明该请求需要进行 Watch 监控注册。并通过 zks.getZKDatabase().getData 函数将 Watch 事件注册到服务端的 WatchManager 中。

public void processRequest(Request request) {
  ...
  byte b[] = zks.getZKDatabase().getData(
      getDataRequest.getPath(), stat,
      getDataRequest.getWatch() ? cnxn : null
  );

  rsp = new GetDataResponse(b, stat);
  ..
}

服务端 Watch 事件的触发过程

以 setData 接口即“节点数据内容发生变更”事件为例。在 setData 方法内部执行完对节点数据的变更后,会调用 WatchManager.triggerWatch 方法触发数据变更事件。

public Stat setData(String path, byte data[], ...){
        Stat s = new Stat();
        DataNode n = nodes.get(path);
        ...
        dataWatches.triggerWatch(path, EventType.NodeDataChanged);
        return s;
    }

下面我们进入 triggerWatch 函数内部。

  1. 首先,封装了一个具有会话状态、事件类型、数据节点 3 种属性的 WatchedEvent 对象。
  2. 查询该节点注册的 Watch 事件,如果为空说明该节点没有注册过 Watch 事件。如果存在 Watch 事件则添加到定义的 Wathers 集合中,并在 WatchManager 管理中删除。
  3. 最后,通过调用 process 方法向客户端发送通知。

 Set<Watcher> triggerWatch(String path, EventType type...) {
        WatchedEvent e = new WatchedEvent(type,
                KeeperState.SyncConnected, path);
        Set<Watcher> watchers;
        synchronized (this) {
            watchers = watchTable.remove(path);
            ...
            for (Watcher w : watchers) {
                Set<String> paths = watch2Paths.get(w);
                if (paths != null) {
                    paths.remove(path);
                }
            }
        }
        for (Watcher w : watchers) {
            if (supress != null && supress.contains(w)) {
                continue;
            }
            w.process(e);
        }
        return watchers;
    }

客户端回调的处理过程

客户端使用 SendThread.readResponse() 方法来统一处理服务端的响应。

if (replyHdr.getXid() == -1) { // -1 means notification
    ...
    WatcherEvent event = new WatcherEvent();
    event.deserialize(bbia, "response");
    ...
    if (chrootPath != null) { // chroot path is set
        String serverPath = event.getPath();
        if(serverPath.compareTo(chrootPath)==0)
            event.setPath("/");
            ...
            event.setPath(serverPath.substring(chrootPath.length()));
            ...
    }
    WatchedEvent we = new WatchedEvent(event);
    ...
    eventThread.queueEvent( we ); // queue the event
}

  1. 首先反序列化服务器发送请求头信息 replyHdr.deserialize(bbia, "header"),并判断相属性字段 xid 的值为 -1,表示该请求响应为通知类型。

  2. 在处理通知类型时,首先将己收到的字节流反序列化转换成 WatcherEvent 对象。接着判断客户端是否配置了 chrootPath 属性,如果为 True 说明客户端配置了 chrootPath 属性。需要对接收到的节点路径进行 chrootPath 处理。最后调用 eventThread.queueEvent( )方法将接收到的事件交给 EventThread 线程进行处理.


接下来我们来看一下 EventThread.queueEvent() 方法内部的执行逻辑。

public Set<Watcher> materialize(...)
{
  Set<Watcher> result = new HashSet<Watcher>();
  ...
  switch (type) {
    ...
  case NodeDataChanged:
  case NodeCreated:
      synchronized (dataWatches) {
          addTo(dataWatches.remove(clientPath), result);
      }
      synchronized (existWatches) {
          addTo(existWatches.remove(clientPath), result);
      }
      break;
    ....
  }
  return result;
}

首先按照通知的事件类型,从 ZKWatchManager 中查询注册过的客户端 Watch 信息。客户端在查询到对应的 Watch 信息后,会将其从 ZKWatchManager 的管理中删除。


public void run() {
  try {
    isRunning = true;
    while (true) {
       Object event = waitingEvents.take();
       if (event == eventOfDeath) {
          wasKilled = true;
       } else {
          processEvent(event);
       }
       if (wasKilled)
          synchronized (waitingEvents) {
             if (waitingEvents.isEmpty()) {
                isRunning = false;
                break;
             }
          }
    }
     ...
}

获取到对应的 Watcher 信息后,将查询到的 Watcher 存储到 waitingEvents 队列中,调用 EventThread 类中的 run 方法会循环取出在 waitingEvents 队列中等待的 Watcher 事件进行处理。


最后调用 processEvent(event) 方法来最终执行实现了 Watcher 接口的 process()方法。

private void processEvent(Object event) {
  ...
  if (event instanceof WatcherSetEventPair) {

      WatcherSetEventPair pair = (WatcherSetEventPair) event;
      for (Watcher watcher : pair.watchers) {
          try {
              watcher.process(pair.event);
          } catch (Throwable t) {
              LOG.error("Error while calling watcher ", t);
          }
      }
  }
}

使用 ZooKeeper 实现发布订阅模式

在系统开发的过程中会用到各种各样的配置信息,如数据库配置项、第三方接口、服务地址等,这些配置操作在我们开发过程中很容易完成,但是放到一个大规模的集群中配置起来就比较麻烦了。

我们可以利用 ZooKeeper 的发布订阅功能实现自动完成服务器配置信息的维护。


我们可以把诸如数据库配置项这样的信息存储在 ZooKeeper 数据节点中。如图中的 /confs/data_item1。

h:6em

服务器集群客户端对该节点添加 Watch 事件监控,当集群中的服务启动时,会读取该节点数据获取数据配置信息。而当该节点数据发生变化时,ZooKeeper 服务器会发送 Watch 事件给各个客户端,集群中的客户端在接收到该通知后,重新读取节点的数据库配置信息。


在前面我们使用 Watch 机制实现了一个分布式环境下的配置管理功能,通过对 ZooKeeper 服务器节点添加数据变更事件,实现当数据库配置项信息变更后,集群中的各个客户端能接收到该变更事件的通知,并获取最新的配置信息。要注意一点是,我们提到 Watch 具有一次性,所以当我们获得服务器通知后要再次添加 Watch 事件。因此如果要继续保持监听, 需要重新注册 Watch 事件。


对于 watch,ZooKeeper 提供了这些保障:

  • Watch 与其他事件、其他 watch 以及异步回复都是有序的。 ZooKeeper 客户端库保证所有事件都会按顺序分发。
  • 客户端会保障它在看到相应的 znode 的新数据之前接收到 watch 事件。//这保证了在 process()再次利用 zk client 访问时数据是存在的
  • 从 ZooKeeper(客户端)接收到的 watch 事件顺序一定和 ZooKeeper 服务所看到的事件顺序是一致的。

关于 Watch 的一些值得注意的事情

  1. Watch 是一次性触发器,如果得到了一个 watch 事件,而希望在以后发生变更时继续得到通知,应该再设置一个 watch。
  2. 因为 watch 是一次性触发器,而获得事件再发送一个新的设置 watch 的请求这一过程会有延时,所以无法确保看到了所有发生在 ZooKeeper 上的 一个节点上的事件。所以请处理好在这个时间窗口中可能会发生多次 znode 变更的这种情况。(可以不处理,但至少要意识到这一点)。//也就是说,在 process()中如果处理得慢而没有注册 new watch 时,在这期间有其它事件出现时是不会通知!!
    那么这个问题如何解决?
    可以在客户端添加 Watch 事件时,同时指定一个版本号,</br>当 ZooKeeper 服务器发送通知时,会将该节点的最新版本号一并发送给客户端,</br>客户端在收到通知后,可以根据版本号判断该通知是否已经处理过,</br>如果已经处理过则忽略该通知,否则继续处理该通知。这样就能保证客户端能够收到所有的通知。
    

  1. 一个 watch 对象或一个函数/上下文对,为一个事件只会被通知一次。比如,如果同一个 watch 对象在同一个文件上分别通过 exists 和 getData 注册了两次,而这个文件之后被删除了,这时这个 watch 对象将只会收到一次该文件的 deletion 通知。//同一个 watch 注册同一个节点多次只会生成一个 event。
  2. 当从一个服务器上断开时(比如服务器出故障了),在再次连接上之前,将无法获得任何 watch。请使用这些会话事件来进入安全模式:在 disconnected 状态下将不会收到事件,所以程序在此期间应该谨慎行事。

移除 Watch 事件

在前面我们介绍了如何添加 Watch 事件,那么如何移除 Watch 事件呢?ZooKeeper 提供了两种方式来移除 Watch 事件:

  • 通过调用 ZooKeeper 的 removeWatches() 方法来移除 Watch 事件。

  • 通过调用 ZooKeeper 的 exists()、getData()、getChildren() 等方法来移除 Watch 事件。具体的移除方式是在调用这些方法时,将 watch 参数设置为 null。


使用 ZooKeeper 实现锁

学习了 ZooKeeper 的数据模型和数据节点的相关知识,下面我们通过实际的应用进一步加深理解。

设想这样一个情景:一个购物网站,某个商品库存只剩一件,客户 A 搜索到这件商品并准备下单,但在这期间客户 B 也查询到了该件商品并提交了购买,于此同时,客户 A 也下单购买了此商品,这样就出现了只有一件库存的商品实际上卖出了两件的情况。为了解决这个问题,我们可以在客户 A 对商品进行操作的时候对这件商品进行锁定从而避免这种超卖的情况发生。


实现锁的方式有很多中,这里我们主要介绍两种:悲观锁、乐观锁。


悲观锁

悲观锁认为进程对临界区的竞争总是会出现,为了保证进程在操作数据时,该条数据不被其他进程修改。数据会一直处于被锁定的状态。
我们假设一个具有 n 个进程的应用,同时访问临界区资源,我们通过进程创建 ZooKeeper 节点 /locks 的方式获取锁。


线程 a 通过成功创建 ZooKeeper 节点“/locks”的方式获取锁后继续执行,如下图所示:

h:16em


这时进程 b 也要访问临界区资源,于是进程 b 也尝试创建“/locks”节点来获取锁,因为之前进程 a 已经创建该节点,所以进程 b 创建节点失败无法获得锁。

h:14em


这样就实现了一个简单的悲观锁,不过这也有一个隐含的问题,就是当进程 a 因为异常中断导致 /locks 节点始终存在,其他线程因为无法再次创建节点而无法获取锁,这就产生了一个死锁问题。针对这种情况我们可以通过将节点设置为临时节点的方式避免。并通过在服务器端添加监听事件来通知其他进程重新获取锁。


乐观锁

乐观锁认为,进程对临界区资源的竞争不会总是出现,所以相对悲观锁而言。加锁方式没有那么激烈,不会全程的锁定资源,而是在数据进行提交更新的时候,对数据的冲突与否进行检测,如果发现冲突了,则拒绝操作。

乐观锁基本可以分为读取、校验、写入三个步骤。

CAS(Compare-And-Swap),即比较并替换,就是一个乐观锁的实现。CAS 有 3 个操作数,内存值 V,旧的预期值 A,要修改的新值 B。当且仅当预期值 A 和内存值 V 相同时,将内存值 V 修改为 B,否则什么都不做。


在 ZooKeeper 中的 version 属性就是用来实现乐观锁机制中的“校验”的,ZooKeeper 每个节点都有数据版本的概念,在调用更新操作的时候,假如有一个客户端试图进行更新操作,它会携带上次获取到的 version 值进行更新。而如果在这段时间内,ZooKeeper 服务器上该节点的数值恰好已经被其他客户端更新了,那么其数据版本一定也会发生变化,因此肯定与客户端携带的 version 无法匹配,便无法成功更新,因此可以有效地避免一些分布式更新的并发问题。


在 ZooKeeper 的底层实现中,当服务端处理 setDataRequest 请求时,首先会调用 checkAndIncVersion 方法进行数据版本校验。ZooKeeper 会从 setDataRequest 请求中获取当前请求的版本 version,同时通过 getRecordForPath 方法获取服务器数据记录 nodeRecord, 从中得到当前服务器上的版本信息 currentversion。如果 version 为 -1,表示该请求操作不使用乐观锁,可以忽略版本对比;如果 version 不是 -1,那么就对比 version 和 currentversion,如果相等,则进行更新操作,否则就会抛出 BadVersionException 异常中断操作。

w:28em


总结

本节课主要介绍了 ZooKeeper 的基础知识点——数据模型。并深入介绍了节点类型、stat 状态属性等知识,并利用目前学到的知识解决了集群中服务器运行情况统计、悲观锁、乐观锁等问题。这些知识对接下来的课程至关重要,请务必掌握。

Views: 512

[ZooKeeper] 1 – ZooKeeper 和 分布式

本章节内容:

  • 确定 Apache ZooKeeper 的重要性
  • 了解 ZooKeeper 及其功能
  • 了解分布式系统及其挑战
  • 安装和配置 ZooKeeper 单机环境

随着业务规模和系统复杂度的提升,很多系统会历经从单一架构到垂直架构,再到分布式架构的技术发展过程。

面对大流量高并发的用户访问,以及随之产生的海量数据处理等诸多挑战下,如何能为用户提供稳定可靠的服务,成为目前很多互联网大公司面临的技术问题。


比如,常见的高并发场景有:

  • 购物节
  • 春运购票
  • 秒杀系统
  • 抖音

购物节的支付系统要想要在高并发的场景下实现五个 9(99.999%)的高可用性,保证支付率,还要保证秒杀场景下单位时间内成交的订单数更多,仅靠单一架构是不能做到的。


如果采用集群的垂直架构,随着业务的发展和系统复杂度的提生,要会出现越来越多的子项目,维护和部署也变更复杂,很难方便的扩展。


因此越来越多的公司采用分布式架构:

将一个系统横向分成若干子系统或服务,实现服务性能的动态扩容。
这样不但大幅提高服务处理能力, 而且降低大一程序的开发维护以及部署难度。

整体来看系统和复杂度和部署难度是整体上升的, 但是可以通过 CI/CD 即持续集成和持续部署手段将繁杂的测试部署等环节尽可能自动化.

Reference


bg fit


分布式系统的主要特征:

  • 资源共享(ResourceSharing):

    • 这是指可以在任何地方使用系统中的资源,例如存储空间,计算能力,数据和服务等。
  • 可扩展性(Extendibillity):

    • 从硬件和软件的角度来看,这是指逐步扩展和改进系统的可能性。
  • 并发(Concurency) :

    • 这指的是多个用户同时使用以完成相同任务或不同任务的系统能力。
  • 性能和可扩展性(Performance and Scalability) :

    • 这样可以确保系统的响应时间随着总负载的增加而降低。
  • 容错能力(Fault tolerance) :

    • 这样可以确保即使某些组件出现故障或以降级模式运行,系统也始终可用。
  • 通过 API 进行抽象(Abstraction from APIs) :
    -这确保了系统的各个组件对最终用户是隐藏的,从而仅向他们显示最终服务。


  • 微服务
    • 淘宝
    • 京东
    • 抖音

bg auto


bg


因此掌握分布式开发的相关知识的 IT 从业人员是工大公司争抢的对象。
分布式系统开发工程师薪水也相对更高,在拉钩招聘平台平均起薪 25K+。

w:24em

可见学习和提高分布式系统开发能力, 是传统软件开发人员转行和提升的一个很好的方向选择。


开发一个网络文件系统(NFS)时可能遇到的的问题:

  • 网络可靠 ?
  • 网络延迟 ?
  • 网络带宽 ?
  • 网络安全 ?
  • 拓扑稳定 ?
  • 管理 ?
  • 传输成本 ?
  • 网络组件之间的协作 ?
    • 可用性/数据一致性/分区容错

学习 ZooKeeper,可以提升分布式开发和架构能力

分布式系统的本质,是分布在不同网络或计算机上的程序或组件,彼此通过信息传递来协同工作的系统,而 ZooKeeper 正是一个分布式应用协调框架.

w:24em


Apache Zookeeper是Apache开发的顶级软件,充当集中服务,用于维护命名和配置数据,并在分布式系统中提供灵活而强大的同步功能。


bg


据其架构服务,ZooKeeper主要解决以下问题:

  • 分布式共识 (Distributed Consensus)

    • 数据一致(谁说的算?)
  • 集群管理 (Group Management)

    • HA
  • 出席协议 (Presence Protocal)

    • 是通过互联网或任何IP网络提供存在服务的协议。
  • 领导人选举 (Leader Election)

    • 分布式共识

在分布式系统架构中具有广泛的应用场景,是业界首选的一致性解决方案。而其开源的特性更是为我们学习底层原理,进一步提高分布式架构设计的能力提供了很好的帮助。


ZooKeeper 可以实现分布式系统下的配置管理、命名服务、分布式同步(lock and barrier)、集群成员管理(领导选举, 动态监督节点上下线)以及发布订阅等使用场景,而这些场景基本就是分布式系统中最常见的问题,因此可以说:掌握了 ZooKeeper,就是掌握了分布式系统最关键的知识。


分布式系统 CAP 理论

在分布式系统架构下,CAP 理论已经成为公认的定理,

CAP 简介

CAP 理论是计算机科学家 Eric Brewer 在 2000 年提出的理论猜想,在 2002 年被证明并成为分布式计算领域公认的定理,其理论的基本观念是,在分布式系统中不可能同时满足以下三个特性:

  • C:consistency 一致性
  • A:Availability 可用性
  • P:Partition Tolerance 分区容错性

“CAP Theorem”

Any networked shared-data system can have at most two of three desirable properties:consistency (C) equivalent to having a single up-to-date copy of the data; high availability (A) of that data (for updates); and tolerance to network partitions (P)

w:12em


C:consistency 一致性

所有节点在同一时间的数据完全一致
数据同步, 锁机制.

如果 B 操作在成功完成 A 操作之后,那么整个系统对 B 操作来说必须表现为 A 操作已经完成了或者更新的状态。


A:Availability 可用性

"reads and writes always succeed",

一般在描述一个系统可用性时,通过停机时间来计算,比如某某系统可用性可以达到 5 个 9,意思就是说该系统的可用水平是 99.999%,即全年停机时间不超过

$$(1-0.99999)36524*60 = 5.256min$$

这是一个极高的要求。一般我们说的高可用 HA 是指可用性达到 99.9%的程度.

如果只讨论可用性, 即使集群服务返回的数据不一致, 或者直接访问的节点故障但是集群有故障转移能力因此其他节点可以提供服务,我们都说系统是可用的.


P:Partition Tolerance 分区容错性

分布式系统架构下会有多个节点,为了避免遇到某节点或网络分区故障的时候,系统仍然能够对外提供满足一致性或者可用性的服务,会使用分区进行冗余.


AP VS. CP

很容易的证明 CAP 无法同时满足, 因为分布式系统需要首先保证系统的分区容错性 P,否则就不能称之为是分布式系统, 但是必须在 CP 和 AP 之间做出选择,

  • AP: 牺牲数据一致性,保证可用性,将旧的数据返回给用户。
  • CP: 牺牲可用性,保证数据一致性。阻塞等待,直到网络连接恢复,数据更新操作同步完成之后,再给用户响应最新的数据。

BASE 理论

BASE 是 Basically Available(基本可用)、Soft-state(软状态) 和 Eventually Consistent(最终一致性) 三个短语的缩写。

  • 基本可用:在分布式系统出现故障,允许损失部分可用性(服务降级、页面降级)。

  • 软状态:允许分布式系统出现中间状态。而且中间状态不影响系统的可用性。这里的中间状态是指不同的 data replication(数据备份节点)之间的数据更新可以出现延时的最终一致性。

  • 最终一致性:data replications 经过一段时间达到一致性。
    BASE 理论是对 CAP 中的一致性和可用性进行一个权衡的结果,理论的核心思想就是:我们无法做到强一致,但每个应用都可以根据自身的业务特点,采用适当的方式来使系统达到最终一致性。


ZooKeeper 支持一主(Leader 节点)多从(Follower 节点)集群形式
可以保证 CP 即一致性和分区容错性.


如何才能学好 ZooKeeper?

  1. 官网文档
  2. 使用技巧
  3. 阅读源码
  4. 使用场景

课程设置:

  • 第一章, ZooKeeper 和分布式系统介绍
    • 介绍,安装,配置,集群搭建
  • 第二章, ZooKeeper 服务和工作原理
    • 数据类型,节点操作,监听机制,事务
  • 第三章, ZooKeeper 的编程和开发
    • Java APIs 使用,HA 部署等
  • 第四章, 介绍分布式系统下的使用场景
    • 选举机制,锁,二阶段提交算法,分布式锁,服务注册和发现等.
  • 第五章, ZooKeeper 集群的配置,管理和监控
  • 第六章, 更好用的客户端 Apache Curator

本课程能够使你快速入门分布式开发技术, 有丰富的案例和使用场景的介绍, 带领大家全面系统的了解 ZooKeeper 的应用,架构和底层实现,从而对解决工作中多变的现实问题打下坚实的基础。


Linux 安装 ZooKeeper

zookeeper 下载地址为: https://zookeeper.apache.org/releases.html

h:10em


选择一稳定版本,本教程使用的 release 版本为3.4.14,下载并安装。

打开网址 https://www.apache.org/dyn/closer.lua/zookeeper/zookeeper-3.4.14/zookeeper-3.4.14.tar.gz,


看到如下界面:


选择一个下载地址,使用 wget 命令下载并安装:
Zookeeper 下载安装

$ wget https://mirror.bit.edu.cn/apache/zookeeper/zookeeper-3.4.14/zookeeper-3.4.14.tar.gz
$ tar -zxvf zookeeper-3.4.14.tar.gz
$ cd zookeeper-3.4.14
$ cd conf/
$ cp zoo_sample.cfg zoo.cfg
$ cd ..
$ cd bin/
$ sh zkServer.sh start

执行后,服务端启动成功:


查看服务端状态(启动单机节点):


启动客户端:

$ sh zkCli.sh

帮助命令:

ZooKeeper -server host:port cmd args
        stat path [watch]
        set path data [version]
        ls path [watch]
        delquota [-n|-b] path
        ls2 path [watch]
        setAcl path acl
        setquota -n|-b val path
        history 
        redo cmdno
        printwatches on|off
        delete path [version]
        sync path
        listquota path
        rmr path
        get path [watch]
        create [-s] [-e] path data acl
        addauth scheme auth
        quit 
        getAcl path
        close 
        connect host:port

Windows 下安装 ZooKeeper

zookeeper 下载地址为: https://zookeeper.apache.org/releases.html

选择一个地址点击版本

h:10em


下载后解压:


将 conf 目录下的 zoo_sample.cfg 文件,复制一份,重命名为 zoo.cfg


在安装目录下面新建一个空的 data 文件夹和 log 文件夹:


修改 zoo.cfg 配置文件,将dataDir=/tmp/zookeeper 修改成 zookeeper 安装目录所在的 data 文件夹,再添加一条添加数据日志的配置(需要根据自己的安装路径修改)。


双击 zkServer.cmd , 控制台显示如下内容表示服务端启动成功!

bind to port 0.0.0.0/0.0.0.0:2181

w:35em


双击zkCli.cmd 启动客户端, 出现

Welcome to Zookeeper!

表示我们成功启动客户端。

w:35em


谢谢

Views: 535

使用Redisson和Zookeeper实现分布式锁模拟模拟抢红包业务

使用Redisson和Zookeeper实现分布式锁模拟模拟抢红包业务

业务场景

模拟1000人在10秒内抢10000(或1000)元红包,金额在1-100不等;

使用的框架或软件:

  • Springboot(基础框架)
  • Redisson(实现分布式锁)
  • Zookeeper(实现分布式锁方案)
  • Ngnix(负载均衡)
  • Redis(红包数据存取数据库)

系统或软件:

  • Linux服务器
  • Jmeter(模拟并发请求)

Jmeter 下载和运行

官方网站:http://jmeter.apache.org/

解压后, 运行 “bin/jmeter.bat”

Jmeter 是支持中文的, 启动Jmeter 后, 点击 Options -> Choose Language 来选择语言

测试需求

以获取城市的天气数据为例

第一步: 获取城市的城市代号

发送request到http://toy1.weather.com.cn/search?cityname=上海

从这个请求的 response 中获取到上海的城市代码. 比如:

上海的地区代码是101020100

上海动物园的地区代码是: 10102010016A

第二步: 得到该城市的天气数据

发送request 到: http://www.weather.com.cn/weather2d/101020100.shtml

测试步骤

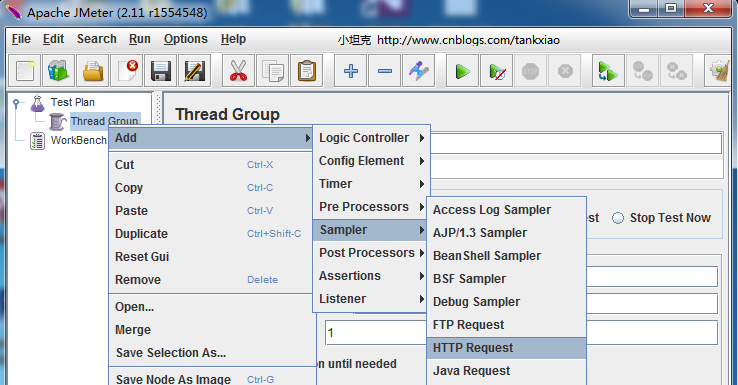
步骤一: 新建一个Thread Group

必须新建一个Thread Group, jmeter的所有任务都必须由线程处理,所有任务都必须在线程组下面创建。

img

第二步:新建一个 HTTP Request

img

比如我要发送一个Get 方法的http 请求: http://toy1.weather.com.cn/search?cityname=上海

可以按照下图这么填

img

第三步 添加HTTP Head Manager

选中上一步新建的HTTP request. 右键,新建一个Http Header manager. 添加一个header

img

img

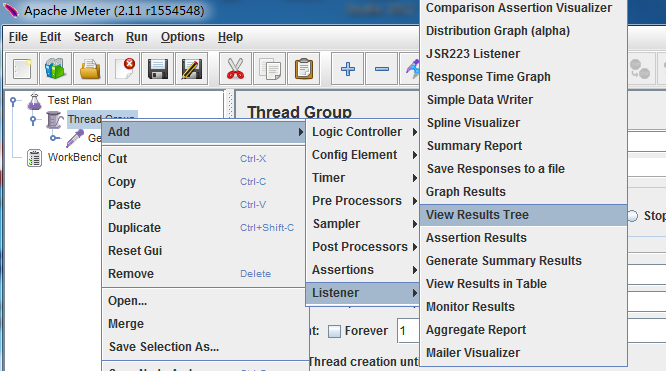
第四步: 添加View Results Tree

View Results Tree 是用来看运行的结果的

img

第五步:运行测试,查看结果

img

img

模拟抢红包业务开发

情况1 - 单机服务——没有任何线程安全考虑

@GetMapping("/get/money")
public String getRedPackage(){

    Map map = new HashMap();
    Object o = redisTemplate.opsForValue().get(KEY_RED_PACKAGE_MONEY);
    int remainMoney = Integer.parseInt(String.valueOf(o));
    if(remainMoney <= 0 ){
        map.put("result","红包已抢完");
        return ReturnModel.success(map).appendToString();
    }
    int randomMoney = (int) (Math.random() * 100);
    if(randomMoney > remainMoney){
        randomMoney = remainMoney;
    }
    int newRemainMoney = remainMoney-randomMoney;
    redisTemplate.opsForValue().set(KEY_RED_PACKAGE_MONEY,newRemainMoney);
    String result = "原有金额:" + remainMoney + " 红包金额:" + randomMoney + " 剩余金额:" + newRemainMoney;
    System.out.println(result);
    map.put("result",result);

    return ReturnModel.success(map).appendToString();
}

输出数据有异常:

原有金额:1000 红包金额:49 剩余金额:951
原有金额:1000 红包金额:62 剩余金额:938
原有金额:1000 红包金额:61 剩余金额:939
原有金额:1000 红包金额:93 剩余金额:907
原有金额:1000 红包金额:73 剩余金额:927
原有金额:939 红包金额:65 剩余金额:874
原有金额:939 红包金额:16 剩余金额:923
原有金额:939 红包金额:30 剩余金额:909

情况2 - 单机服务, 使用Lock锁

public static Lock lock = new ReentrantLock();

@GetMapping("/get/money/lock")
public String getRedPackageLock(){
    Map map = new HashMap();
    lock.lock();
    try{
        Object o = redisTemplate.opsForValue().get(KEY_RED_PACKAGE_MONEY);
        int remainMoney = Integer.parseInt(String.valueOf(o));
        if(remainMoney <= 0 ){
            map.put("result","红包已抢完");
            return ReturnModel.success(map).appendToString();
        }
        int randomMoney = (int) (Math.random() * 100);
        if(randomMoney > remainMoney){
            randomMoney = remainMoney;
        }
        int newRemainMoney = remainMoney-randomMoney;
        redisTemplate.opsForValue().set(KEY_RED_PACKAGE_MONEY,newRemainMoney);
        String result = "原有金额:" + remainMoney + " 红包金额:" + randomMoney + " 剩余金额:" + newRemainMoney;
        System.out.println(result);
        map.put("result",result);
        return ReturnModel.success(map).appendToString();
    }finally {
        lock.unlock();
    }
}

Lock在单服务器是线程安全的, 此时输出数据正常:

原有金额:1000 红包金额:11 剩余金额:989
原有金额:989 红包金额:48 剩余金额:941
原有金额:941 红包金额:17 剩余金额:924
原有金额:924 红包金额:89 剩余金额:835
原有金额:835 红包金额:63 剩余金额:772
原有金额:772 红包金额:77 剩余金额:695
原有金额:695 红包金额:76 剩余金额:619
原有金额:619 红包金额:8 剩余金额:611
原有金额:611 红包金额:67 剩余金额:544
原有金额:544 红包金额:9 剩余金额:535
原有金额:535 红包金额:78 剩余金额:457
......

情况3.1 - 两台服务器, 使用Lock锁

数据异常(代码情况2一样);

Lock在镀钛服务器下是非线程安全的

负载均衡配置

使用Nginx配置负载均衡,部署两个服务分别是8001和8002端口,Nginx暴露8080端口,转发请求到8001和8002;

img

nginx配置

http {
    include       mime.types;
    default_type  application/octet-stream;
    sendfile        on;
    keepalive_timeout  65;
    ##定义负载均衡真实服务器IP:端口号 weight表示权重
    upstream myserver{
        server   XX.XX.XX.XX:8001 weight=1;
        server   XX.XX.XX.XX:8002 weight=1;
     }
    server {
        listen   8080;
        location  / {
            proxy_pass   http://myserver;
            proxy_connect_timeout 10;
        }
    }  
}

情况3.2 - 两台服务器 使用Redisson分布式锁

<dependency>
    <groupId>io.netty</groupId>
    <artifactId>netty-all</artifactId>
    <version>4.1.31.Final</version>
</dependency>
<dependency>
    <groupId>org.redisson</groupId>
    <artifactId>redisson</artifactId>
    <version>3.6.5</version>
</dependency>
@Configuration
public class RedissonConfig {

    @Value("${spring.redis.host}")
    private String host;

    @Value("${spring.redis.port}")
    private String port;

    @Value("${spring.redis.password}")
    private String password;

    @Bean
    public RedissonClient getRedisson(){

        Config config = new Config();
        config.useSingleServer().setAddress("redis://" + host + ":" + port).setPassword(password);
        return Redisson.create(config);
    }

}
@Autowired
private RedissonClient redissonClient;

//3-抢红包-redisson
@GetMapping("/get/money/redisson")
public String getRedPackageRedison(){
    RLock rLock = redissonClient.getLock("secKill");
    rLock.lock();
    Map map = new HashMap();
    try{
        Object o = redisTemplate.opsForValue().get(KEY_RED_PACKAGE_MONEY);
        int remainMoney = Integer.parseInt(String.valueOf(o));
        if(remainMoney <= 0 ){
            map.put("result","红包已抢完");
            return ReturnModel.success(map).appendToString();
        }
        int randomMoney = (int) (Math.random() * 100);
        if(randomMoney > remainMoney){
            randomMoney = remainMoney;
        }
        int newRemainMoney = remainMoney-randomMoney;
        redisTemplate.opsForValue().set(KEY_RED_PACKAGE_MONEY,newRemainMoney);
        String result = "原有金额:" + remainMoney + " 红包金额:" + randomMoney + "剩余金额:" + newRemainMoney;
        System.out.println(result);
        map.put("result",result);
        return ReturnModel.success(map).appendToString();
    }finally {
        rLock.unlock();
    }
}

情况3.3 - 两台服务器——使用Zookeeper分布式锁——数据正常

@Configuration
public class ZkConfiguration {
    /**
     * 重试次数
     */
    @Value("${curator.retryCount}")
    private int retryCount;
    /**
     * 重试间隔时间
     */
    @Value("${curator.elapsedTimeMs}")
    private int elapsedTimeMs;
    /**
     * 连接地址
     */
    @Value("${curator.connectString}")
    private String connectString;
    /**
     * Session过期时间
     */
    @Value("${curator.sessionTimeoutMs}")
    private int sessionTimeoutMs;
    /**
     * 连接超时时间
     */
    @Value("${curator.connectionTimeoutMs}")
    private int connectionTimeoutMs;

    @Bean(initMethod = "start")
    public CuratorFramework curatorFramework() {
        return CuratorFrameworkFactory.newClient(
                connectString,
                sessionTimeoutMs,
                connectionTimeoutMs,
                new RetryNTimes(retryCount,elapsedTimeMs));
    }

    /**
     * Distributed lock by zookeeper distributed lock by zookeeper.
     *
     * @return the distributed lock by zookeeper
     */
    @Bean(initMethod = "init")
    public DistributedLockByZookeeper distributedLockByZookeeper() {
        return new DistributedLockByZookeeper();
    }
}
@Slf4j
public class DistributedLockByZookeeper {
    private final static String ROOT_PATH_LOCK = "myk";

    private CountDownLatch countDownLatch = new CountDownLatch(1);

    /**
     * The Curator framework.
     */
    @Autowired
    CuratorFramework curatorFramework;

    /**
     * 获取分布式锁
     * 创建一个临时节点,
     *
     * @param path the path
     */
    public void acquireDistributedLock(String path) {
        String keyPath = "/" + ROOT_PATH_LOCK + "/" + path;
        while (true) {
            try {
                curatorFramework.create()
                        .creatingParentsIfNeeded()
                        .withMode(CreateMode.EPHEMERAL)
                        .withACL(ZooDefs.Ids.OPEN_ACL_UNSAFE)
                        .forPath(keyPath);
                //log.info("success to acquire lock for path:{}", keyPath);
                break;
            } catch (Exception e) {
                //抢不到锁,进入此处!
                //log.info("failed to acquire lock for path:{}", keyPath);
                //log.info("while try again .......");
                try {
                    if (countDownLatch.getCount() <= 0) {
                        countDownLatch = new CountDownLatch(1);
                    }
                    //避免请求获取不到锁,重复的while,浪费CPU资源
                    countDownLatch.await();
                } catch (InterruptedException e1) {
                    e1.printStackTrace();
                }
            }
        }
    }

    /**
     * 释放分布式锁
     *
     * @param path the  节点路径
     * @return the boolean
     */
    public boolean releaseDistributedLock(String path) {
        try {
            String keyPath = "/" + ROOT_PATH_LOCK + "/" + path;
            if (curatorFramework.checkExists().forPath(keyPath) != null) {
                curatorFramework.delete().forPath(keyPath);
            }
        } catch (Exception e) {
            //log.error("failed to release lock,{}", e);
            return false;
        }
        return true;
    }

    /**
     * 创建 watcher 事件
     */
    private void addWatcher(String path) {
        String keyPath;
        if (path.equals(ROOT_PATH_LOCK)) {
            keyPath = "/" + path;
        } else {
            keyPath = "/" + ROOT_PATH_LOCK + "/" + path;
        }
        try {
            final PathChildrenCache cache = new PathChildrenCache(curatorFramework, keyPath, false);
            cache.start(PathChildrenCache.StartMode.POST_INITIALIZED_EVENT);
            cache.getListenable().addListener((client, event) -> {
                if (event.getType().equals(PathChildrenCacheEvent.Type.CHILD_REMOVED)) {
                    String oldPath = event.getData().getPath();
                    //log.info("上一个节点 " + oldPath + " 已经被断开");
                    if (oldPath.contains(path)) {
                        //释放计数器,让当前的请求获取锁
                        countDownLatch.countDown();
                    }
                }
            });
        } catch (Exception e) {
            log.info("监听是否锁失败!{}", e);
        }
    }

    /**
     * 创建父节点,并创建永久节点
     */
    public void init() {
        curatorFramework = curatorFramework.usingNamespace("lock-namespace");
        String path = "/" + ROOT_PATH_LOCK;
        try {
            if (curatorFramework.checkExists().forPath(path) == null) {
                curatorFramework.create()
                        .creatingParentsIfNeeded()
                        .withMode(CreateMode.PERSISTENT)
                        .withACL(ZooDefs.Ids.OPEN_ACL_UNSAFE)
                        .forPath(path);
            }
            addWatcher(ROOT_PATH_LOCK);
            log.info("root path 的 watcher 事件创建成功");
        } catch (Exception e) {
            log.error("connect zookeeper fail,please check the log >> {}", e.getMessage(), e);
        }
    }

}
    @Autowired
    DistributedLockByZookeeper distributedLockByZookeeper;
    private final static String PATH = "red_package";
    //4-抢红包-zookeeper
    @GetMapping("/get/money/zookeeper")
    public String getRedPackageZookeeper(){

        Boolean flag = false;
        distributedLockByZookeeper.acquireDistributedLock(PATH);
        Map map = new HashMap();
        try {
            Object o = redisTemplate.opsForValue().get(KEY_RED_PACKAGE_MONEY);
            int remainMoney = Integer.parseInt(String.valueOf(o));
            if(remainMoney <= 0 ){
                map.put("result","红包已抢完");
                return ReturnModel.success(map).appendToString();
            }
            int randomMoney = (int) (Math.random() * 100);
            if(randomMoney > remainMoney){
                randomMoney = remainMoney;
            }
            int newRemainMoney = remainMoney-randomMoney;
            redisTemplate.opsForValue().set(KEY_RED_PACKAGE_MONEY,newRemainMoney);
            String result = "原有金额:" + remainMoney + " 红包金额:" + randomMoney + "剩余金额:" + newRemainMoney;
            System.out.println(result);
            map.put("result",result);
            return ReturnModel.success(map).appendToString();
        } catch(Exception e){
            e.printStackTrace();
            flag = distributedLockByZookeeper.releaseDistributedLock(PATH);
            //System.out.println("releaseDistributedLock: " + flag);
            map.put("result","getRedPackageZookeeper catch exceeption");
            return ReturnModel.success(map).appendToString();
        }finally {
            flag = distributedLockByZookeeper.releaseDistributedLock(PATH);
            //System.out.println("releaseDistributedLock: " + flag);
        }
    }

附录

1- 其他配置和类

application.properties文件

server.port=80

#配置redis
spring.redis.host=XX.XX.XX.XX
spring.redis.port=6379
spring.redis.password=xuegaotest1234
spring.redis.database=0
#重试次数
curator.retryCount=5
#重试间隔时间
curator.elapsedTimeMs=5000
# zookeeper 地址
curator.connectString=XX.XX.XX.XX:2181
# session超时时间
curator.sessionTimeoutMs=60000
# 连接超时时间
curator.connectionTimeoutMs=5000

ReturnModel 类

public class ReturnModel implements Serializable{

    private int code;
    private String msg;
    private Object data;

    public static ReturnModel success(Object obj){
        return new ReturnModel(200,"success",obj);
    }

    public String appendToString(){
        return  JSON.toJSONString(this);
    }

    public ReturnModel() {
    }

    public ReturnModel(int code, String msg, Object data) {
        this.code = code;
        this.msg = msg;
        this.data = data;
    }

    public int getCode() {
        return code;
    }

    public void setCode(int code) {
        this.code = code;
    }

    public String getMsg() {
        return msg;
    }

    public void setMsg(String msg) {
        this.msg = msg;
    }

    public Object getData() {
        return data;
    }

    public void setData(Object data) {
        this.data = data;
    }
}

SeckillController类

    public final static String KEY_RED_PACKAGE_MONEY  = "key_red_package_money";

    @Autowired
    private RedisTemplate redisTemplate;

    //1-设置红包
    @GetMapping("/set/money/{amount}")
    public String setRedPackage(@PathVariable Integer amount){
        redisTemplate.opsForValue().set(KEY_RED_PACKAGE_MONEY,amount);
        Object o = redisTemplate.opsForValue().get(KEY_RED_PACKAGE_MONEY);
        Map map = new HashMap();
        map.put("moneyTotal",Integer.parseInt(String.valueOf(o)));
        return ReturnModel.success(map).appendToString();
    }

流程解析

Zookeeper分布锁

1- 在ZkConfiguration类中加载CuratorFramework时,设置参数,实例化一个CuratorFramework类; 实例化过程中,执行CuratorFrameworkImpl类中的的start(),其中CuratorFrameworkImpl类是CuratorFramework的实现类;根据具体的细节可以参考博客;

@Bean(initMethod = "start")
public CuratorFramework curatorFramework() {
    return CuratorFrameworkFactory.newClient( connectString,  sessionTimeoutMs, connectionTimeoutMs,  new RetryNTimes(retryCount,elapsedTimeMs));
}

2- 在ZkConfiguration类中加载DistributedLockByZookeeper时;执行其中的init()方法;init()方法中主要是创建父节点和添加监听

/**
 * 创建父节点,并创建永久节点
 */
public void init() {
    curatorFramework = curatorFramework.usingNamespace("lock-namespace");
    String path = "/" + ROOT_PATH_LOCK;
    try {
        if (curatorFramework.checkExists().forPath(path) == null) {
            curatorFramework.create()
                    .creatingParentsIfNeeded()
                    .withMode(CreateMode.PERSISTENT)
                    .withACL(ZooDefs.Ids.OPEN_ACL_UNSAFE)
                    .forPath(path);
        }
        addWatcher(ROOT_PATH_LOCK);
        log.info("root path 的 watcher 事件创建成功");
    } catch (Exception e) {
        log.error("connect zookeeper fail,please check the log >> {}", e.getMessage(), e);
    }
}

3- 在具体业务中调用distributedLockByZookeeper.acquireDistributedLock(PATH);获取分布式锁

/**
 * 获取分布式锁
 * 创建一个临时节点,
 *
 * @param path the path
 */
public void acquireDistributedLock(String path) {
    String keyPath = "/" + ROOT_PATH_LOCK + "/" + path;
    while (true) {
        try {
            curatorFramework.create()
                    .creatingParentsIfNeeded()
                    .withMode(CreateMode.EPHEMERAL)
                    .withACL(ZooDefs.Ids.OPEN_ACL_UNSAFE)
                    .forPath(keyPath);
            break;
        } catch (Exception e) {
            //抢不到锁,进入此处!
            try {
                if (countDownLatch.getCount() <= 0) {
                    countDownLatch = new CountDownLatch(1);
                }
                //避免请求获取不到锁,重复的while,浪费CPU资源
                countDownLatch.await();
            } catch (InterruptedException e1) {
                e1.printStackTrace();
            }
        }
    }
}

4- 业务结束时调用distributedLockByZookeeper.releaseDistributedLock(PATH);释放锁

/**
 * 释放分布式锁
 *
 * @param path the  节点路径
 * @return the boolean
 */
public boolean releaseDistributedLock(String path) {
    try {
        String keyPath = "/" + ROOT_PATH_LOCK + "/" + path;
        if (curatorFramework.checkExists().forPath(keyPath) != null) {
            curatorFramework.delete().forPath(keyPath);
        }
    } catch (Exception e) {
        return false;
    }
    return true;
}

原理图如下

img

期间碰到的问题

问题: 项目启动时:java.lang.ClassNotFoundException: com.google.common.base.Function

原因:缺少google-collections jar包;如下

<dependency>
    <groupId>com.google.collections</groupId>
    <artifactId>google-collections</artifactId>
    <version>1.0</version>
</dependency>

问题:项目启动时:org.apache.curator.CuratorConnectionLossException: KeeperErrorCode = ConnectionLoss

原因:简单说,就是连接失败(可能原因的有很多);依次排查了zookeeper服务器防火墙、application.properties配置文件;最后发现IP的写错了,更正后就好了

问题:Jemter启用多线程并发测试时:java.net.BindException: Address already in use: connect.

Views: 556

[Android] 基于位置的服务(LBS)与百度地图 SDK

基于位置的服务 (LBS)

基于位置的服务(Location Based Services,LBS),是利用各类型的定位技术来获取定位设备当前的所在位置,通过移动互联网向定位设备提供信息资源和基础服务。首先用户可利用定位技术确定自身的空间位置,随后用户便可通过移动互联网来获取与位置相关资源和信息。LBS服务中融合了移动通讯、互联网络、空间定位、位置信息、大数据等多种信息技术,利用移动互联网络服务平台进行数据更新和交互,使用户可以通过空间定位来获取相应的服务。

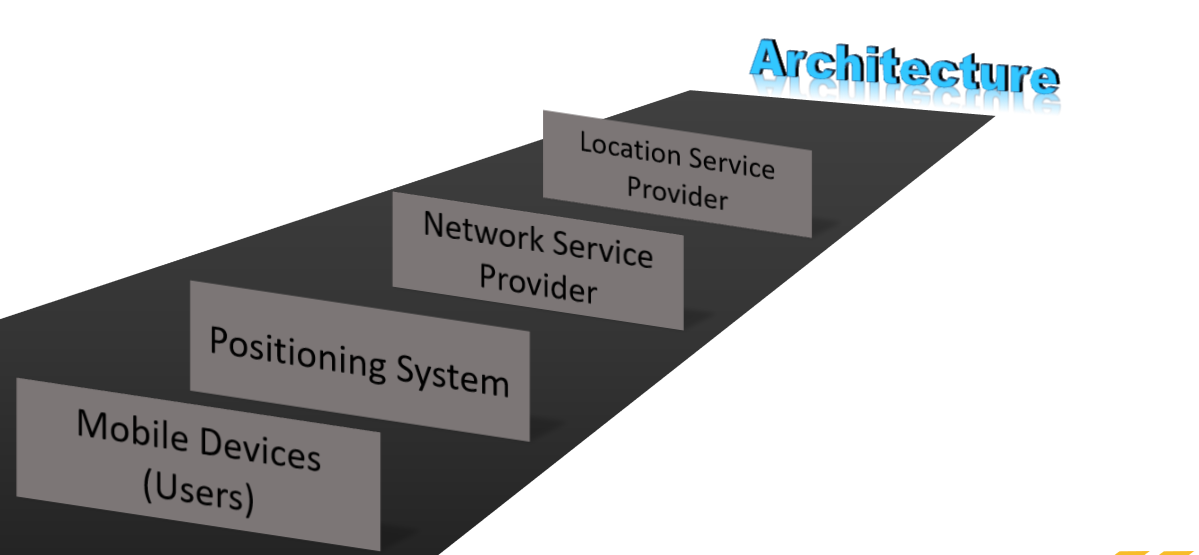
LBS系统架构

LBS系统架构包括:

  • Mobile Devices (Users) 移动设备(用户)
  • Positioning System 定位系统
  • Network Service Provider 网络服务提供商
  • Location Service Provider 定位服务提供商

1、移动设备(用户)
在LBS的体系结构中,用户通常具有定位功能的移动设备用来获得其地理位置信息,同时,用户可以通过基站或WiFi热点访问互联网来发起基于位置的服务查询请求。此外,在P2P分布式结构的隐私保护方案中,我们认为移动设备还有另一个无线网卡,可以通过各种传输协议或特定的Ad hoc网络协议(如AODV协议或LANMAR协议)自发组织成移动点对点网络,并相互交换信息。

2、定位系统
定位技术是指由移动设备及时确定该设备所在地理位置的技术,其结合了硬件(例如GPS芯片)和软件(例如从多个基站信号中确定位置的程序)的技术。使用基于位置服务是以精确的定位技术为前提的,也是此服务最重要的保障技术之一。目前,常用的定位技术包括四种:

(1)全球定位系统(Global Positioning System,GPS):使用卫星和移动设备通信时根据多个卫星与同一装置之间的通信延迟,使用三角测量方法获得移动对象的经纬度,精度可达5米以下。GPS定位方法是目前最精确的经纬度定位方法。但是,该方法的缺陷是无法实现室内定位。

(2)WiFi定位:建立WiFi接入点与其准确位置之间的对应关系并预先存储在数据库中。当移动对象连接到某个WiFi访问点时,用户的位置可以通过访问数据库中相对应的表检测较精确的经纬度,如Google WiFi定位。WiFi定位的精度在1到10米的范围内。
(3)IP地址定位:当移动设备访问互联网时会被分配一个IP地址,IP地址的分配是与地域有关的。通过使用现有的IP地址与区域之间的映射关系,可以将移动对象的位置定位到城市大小的区域。
(4)三角测量法:三角测量在三角学和几何学上是借由测量目标点与固定基准线的已知端点的角度,测量目标距离的方法。当移动设备在三个移动电话基站的信号范围内时,三角测量可以获得用户的经纬度。三角测量法和WiFi定位克服了GPS不能在室内进行定位的缺点。用户在发送位置服务请求时,需要通过移动设备的定位系统获取自己的精确位置坐标,然后将自己的位置信息和查询内容一起发送给LBS服务器。

3、网络服务提供商
网络服务提供商是移动用户和LBS服务提供商之间通信的网络载体。一般情况下,网络服务提供商不能保证信息传播的安全性。恶意攻击者可以监控网络传输的内容。

4、位置服务提供商
位置服务提供商接收移动用户的查询请求信息并给于该信息计算查询相应的结果,然后通过网络把查询结果发送到移动用户。现实中,LBS服务提供商主要以盈利为主,所以位置服务提供商很可能将移动用户的位置信息卖给第三方来获取利润,存在隐私泄露的风险。

介绍百度地图SDK

百度地图 Android SDK是一套基于Android 4.0及以上版本设备的应用程序接口。 您可以使用该套 SDK开发适用于Android系统移动设备的地图应用,通过调用地图SDK接口,您可以轻松访问百度地图服务和数据,构建功能丰富、交互性强的地图类应用程序。

重点功能简介

  • 地图展示与交互

  • 室内地图

  • 境外地图

  • 地图覆盖物

  • POI检索

  • 路线规划

  • 步行导航

  • 骑行导航

使用百度地图SDK

百度地图SDK下载地址:http://lbsyun.baidu.com/index.php?title=android-locsdk/geosdk-android-download

官方文档:

Android SDK | 百度地图API SDK (baidu.com)

注册百度开发者账号

首先需要注册百度账号,登陆百度账号,打开网址 http://developer.baidu.com/user/info 填写注册信息并提交,然后去自己的邮箱通过验证,就完成注册了。

申请AK密钥

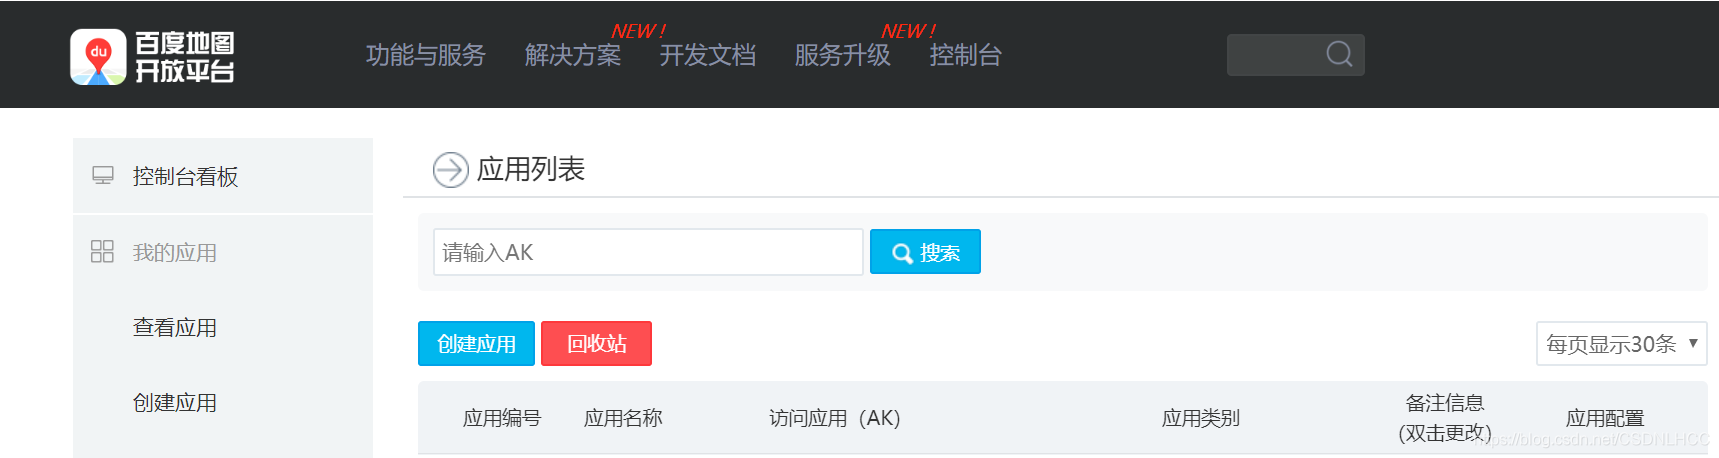
接着访问 https://lbsyun.baidu.com/apiconsole/key 会看到下面这个界面

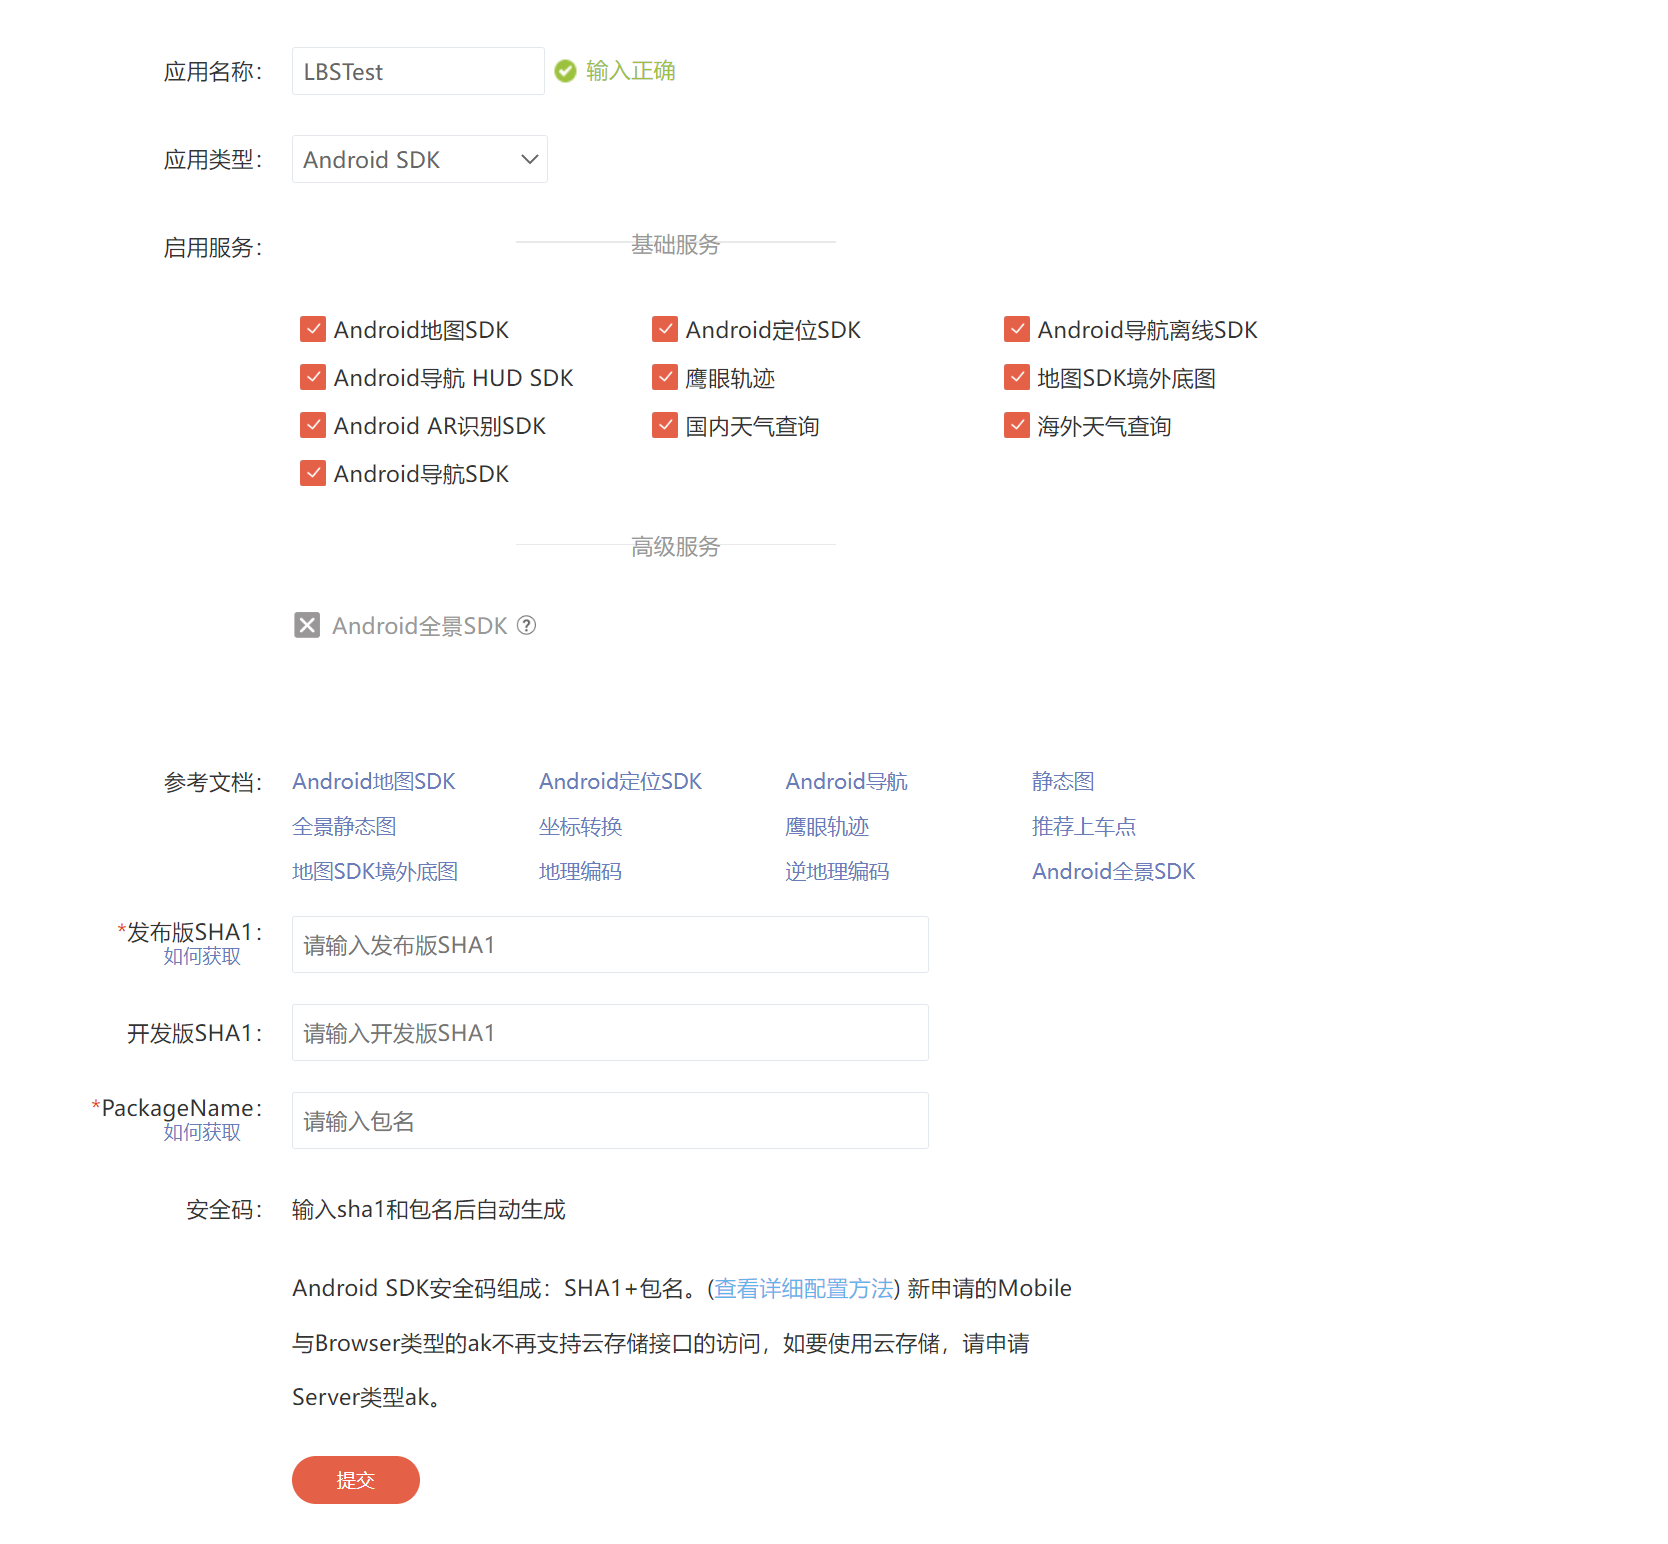
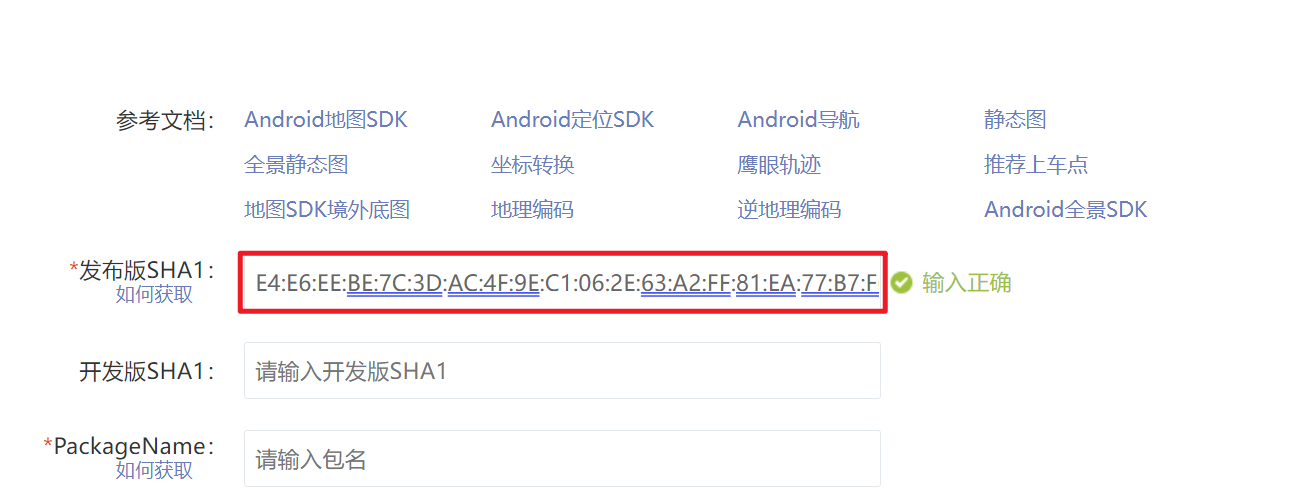
点击 创建应用 申请 API Key, 应用名称可以随便填,这里填 LBSTest,应用类型选择 Android SDK,启用服务保持沉默即可,如下图所示

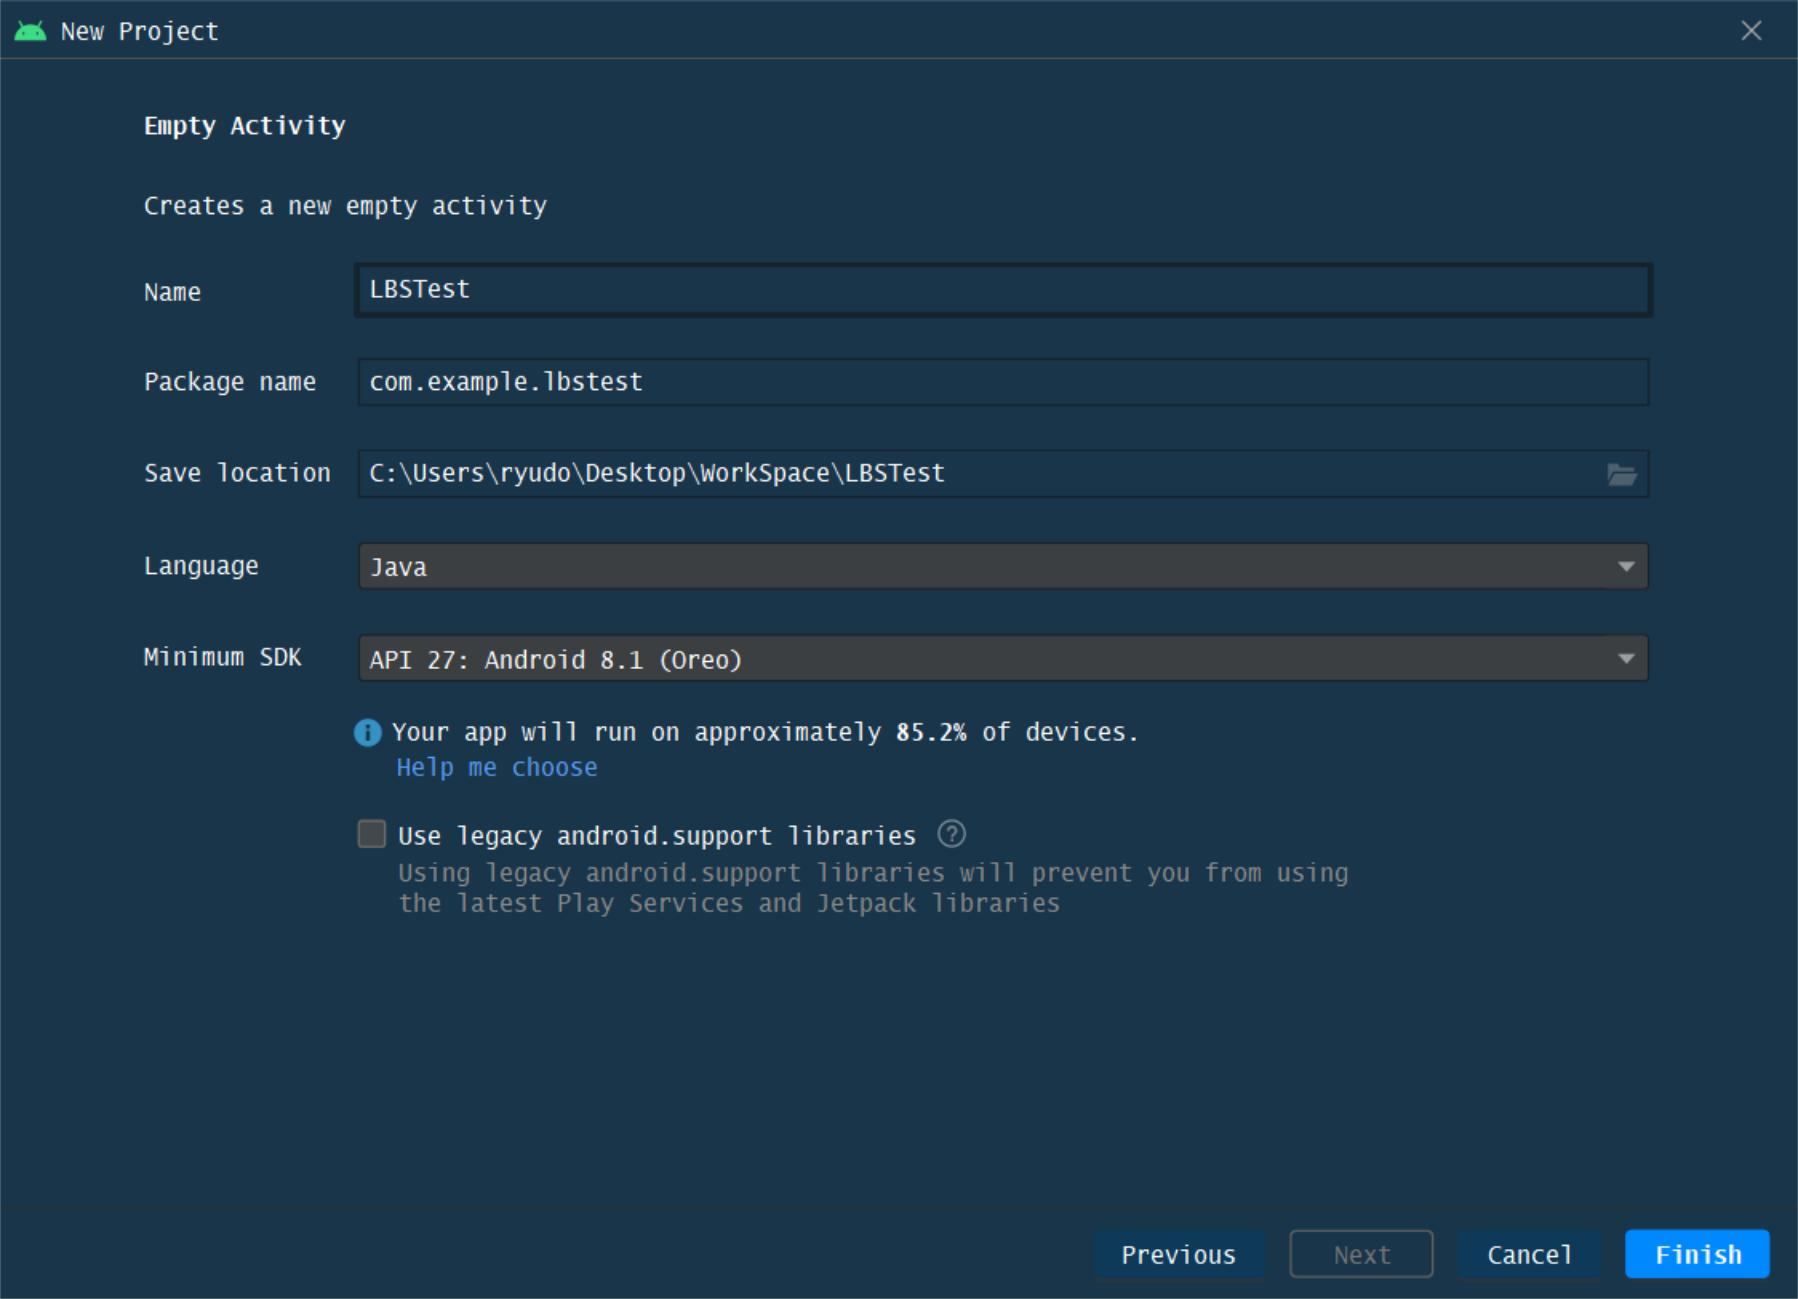
这里的发布版 SHA1 是打包程序时所用的签名文件的 SHA1 指纹,可以通过 Android 查看,新建一个 Android Studio 项目,如图(开发版 SHA1 我们等下再说)

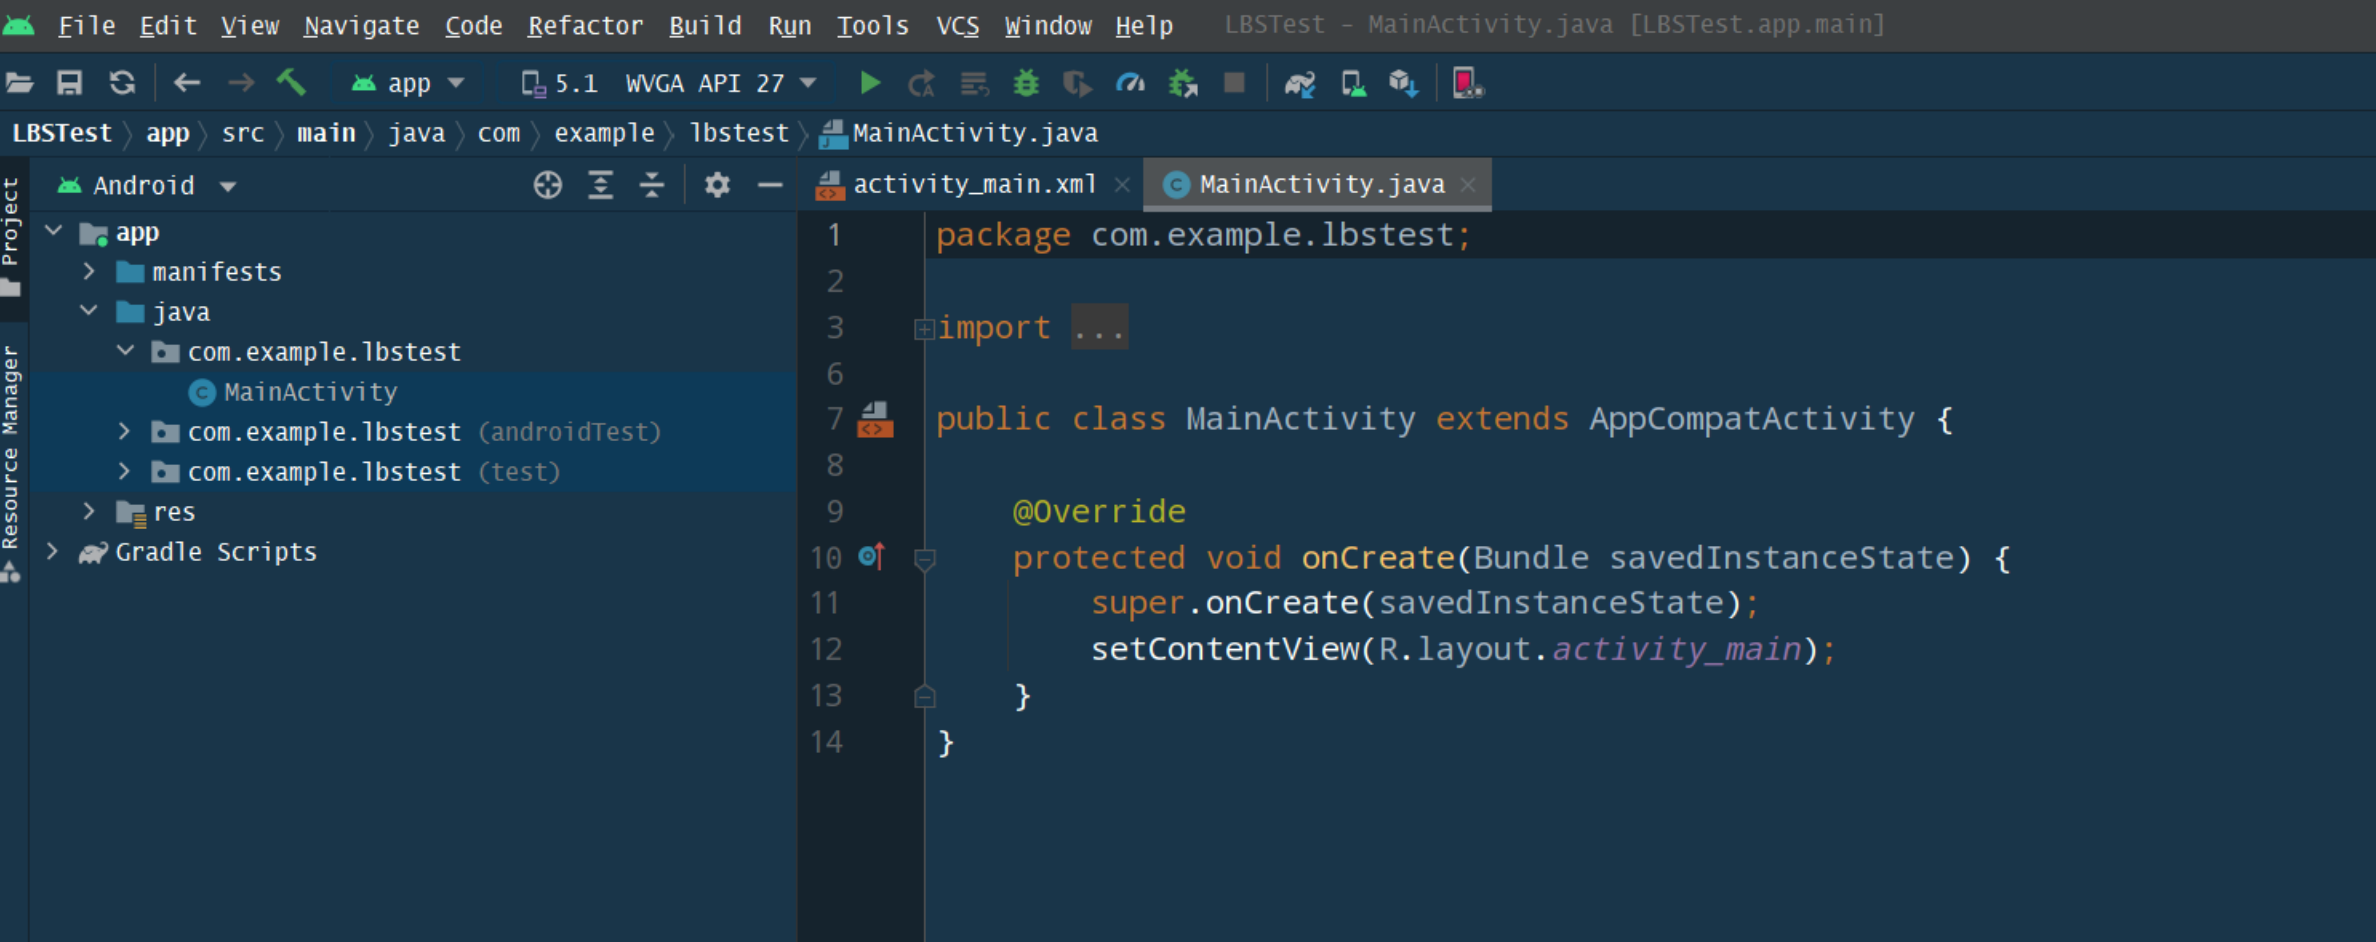
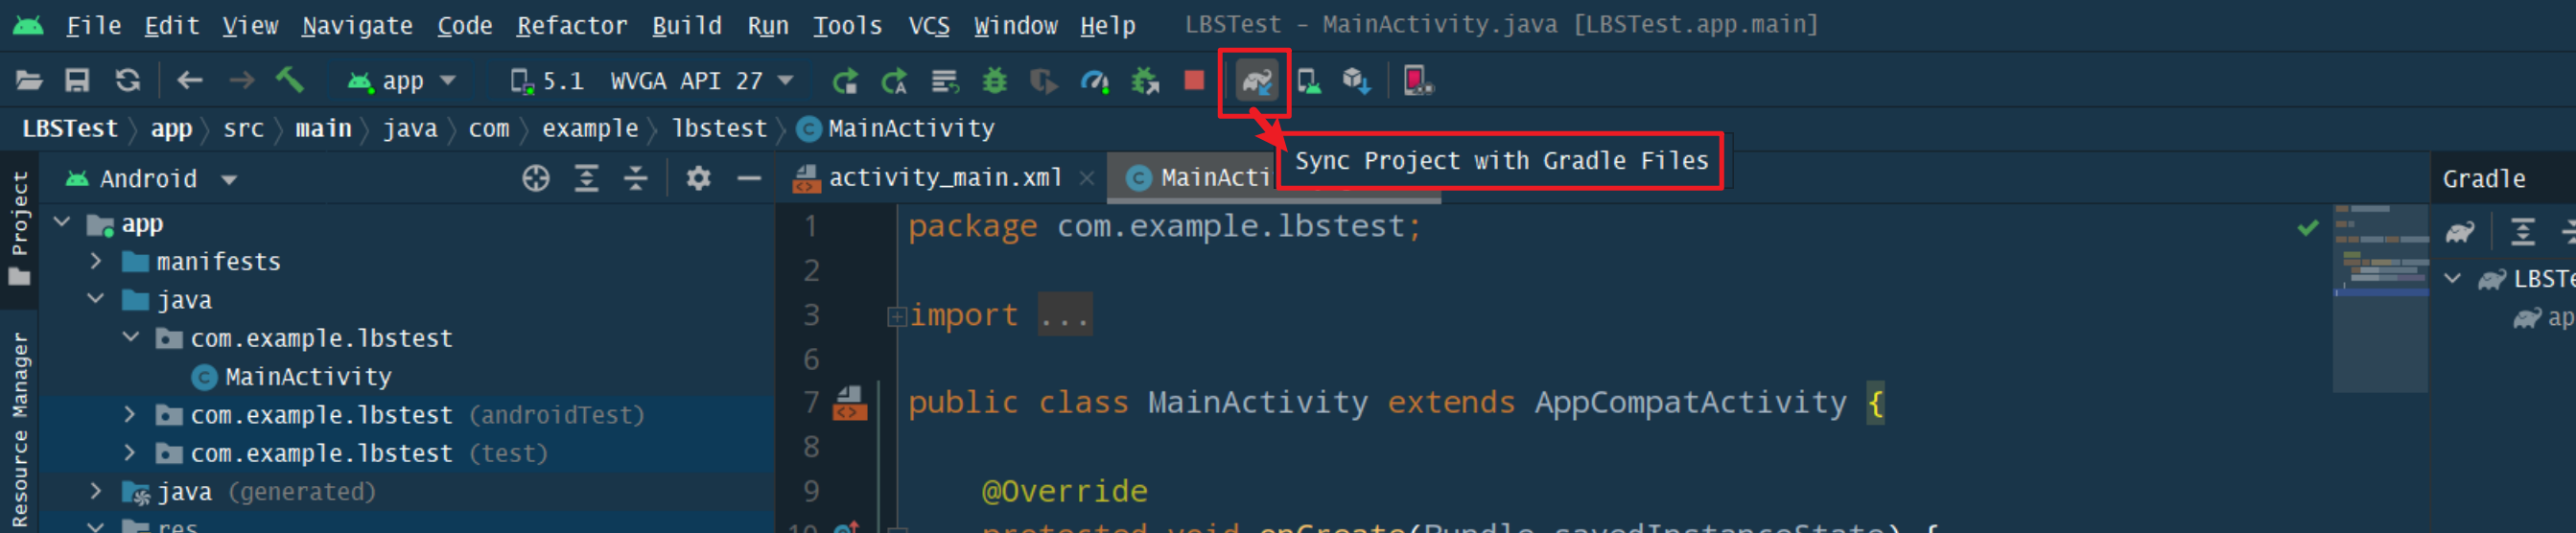
Finish创建成功就可以了。等待Gradle同步完成, 直到运行图标的绿色三角形出现.

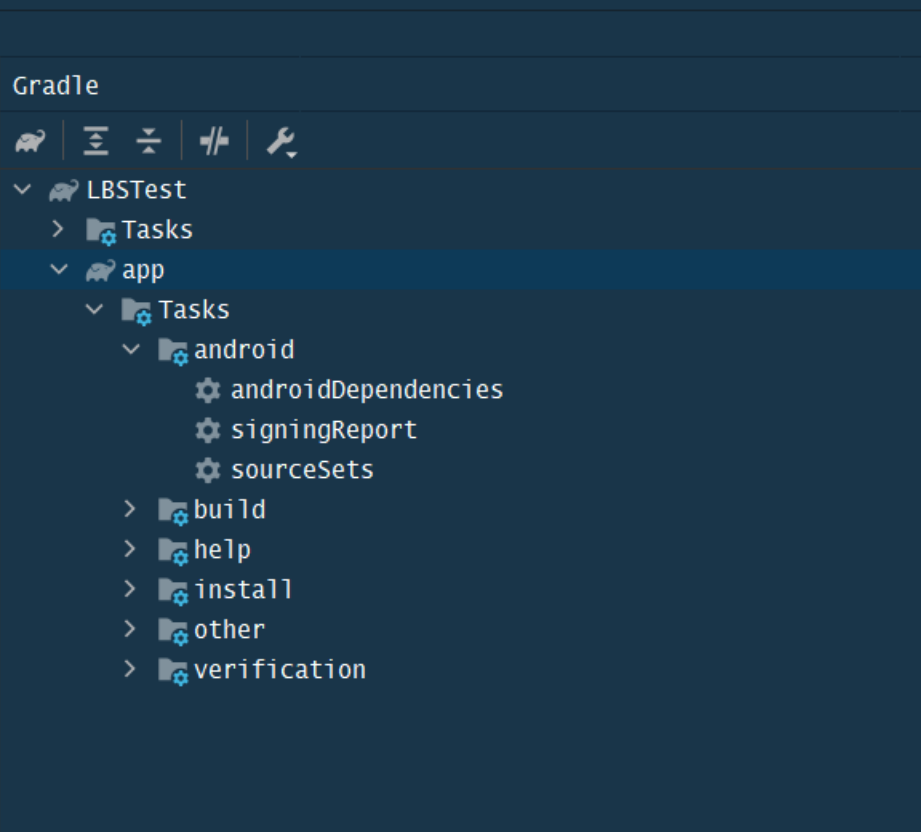
点击 :app --> Task --> android -->

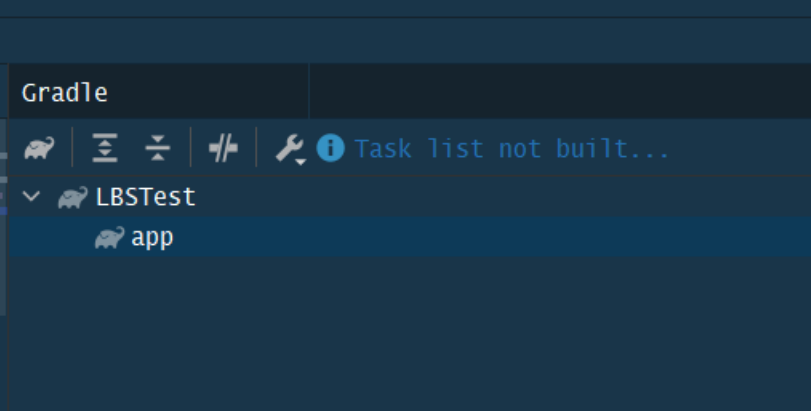
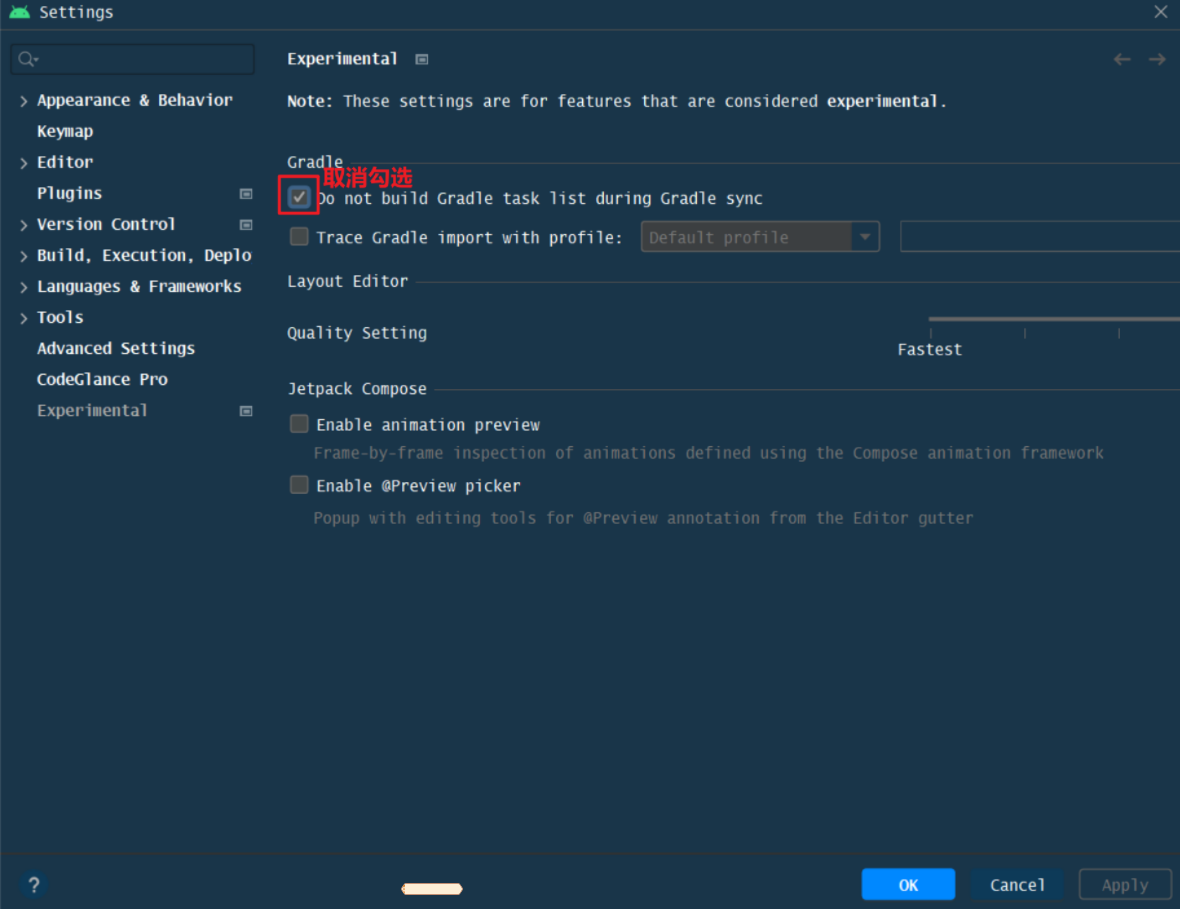
如果Gradle Task List没有显示, 则调整以下设置:

同步完成后, 可以查到Gradle的Task List:

点击 :app --> Task --> android, 双击 signingReport,我们即可得到 发布版SHA1 指纹:

> Task :app:signingReport

Variant: debug
Config: debug
Store: C:\Users\ryudo\AppData\Local\Android\.android\debug.keystore
Alias: AndroidDebugKey
MD5: 46:1A:6B:B8:90:15:7B:AD:BB:07:D2:E5:24:2C:81:30
SHA1: E4:E6:EE:BE:7C:3D:AC:4F:9E:C1:06:2E:63:A2:FF:81:EA:77:B7:F6
SHA-256: BE:F7:7C:81:97:17:6E:99:24:98:0C:7A:61:57:92:AB:AE:6E:A1:64:F6:E5:6E:00:C0:13:BE:87:7E:3E:E7:0B
Valid until: 2052��8��7��������
----------
Variant: release
Config: null
Store: null
Alias: null
----------

Variant: debugAndroidTest
Config: debug
Store: C:\Users\ryudo\AppData\Local\Android\.android\debug.keystore
Alias: AndroidDebugKey
MD5: 46:1A:6B:B8:90:15:7B:AD:BB:07:D2:E5:24:2C:81:30
SHA1: E4:E6:EE:BE:7C:3D:AC:4F:9E:C1:06:2E:63:A2:FF:81:EA:77:B7:F6
SHA-256: BE:F7:7C:81:97:17:6E:99:24:98:0C:7A:61:57:92:AB:AE:6E:A1:64:F6:E5:6E:00:C0:13:BE:87:7E:3E:E7:0B
Valid until: 2052��8��7��������
----------

BUILD SUCCESSFUL in 1s
1 actionable task: 1 executed

Build Analyzer results available
19:55:00: Task execution finished 'signingReport'.

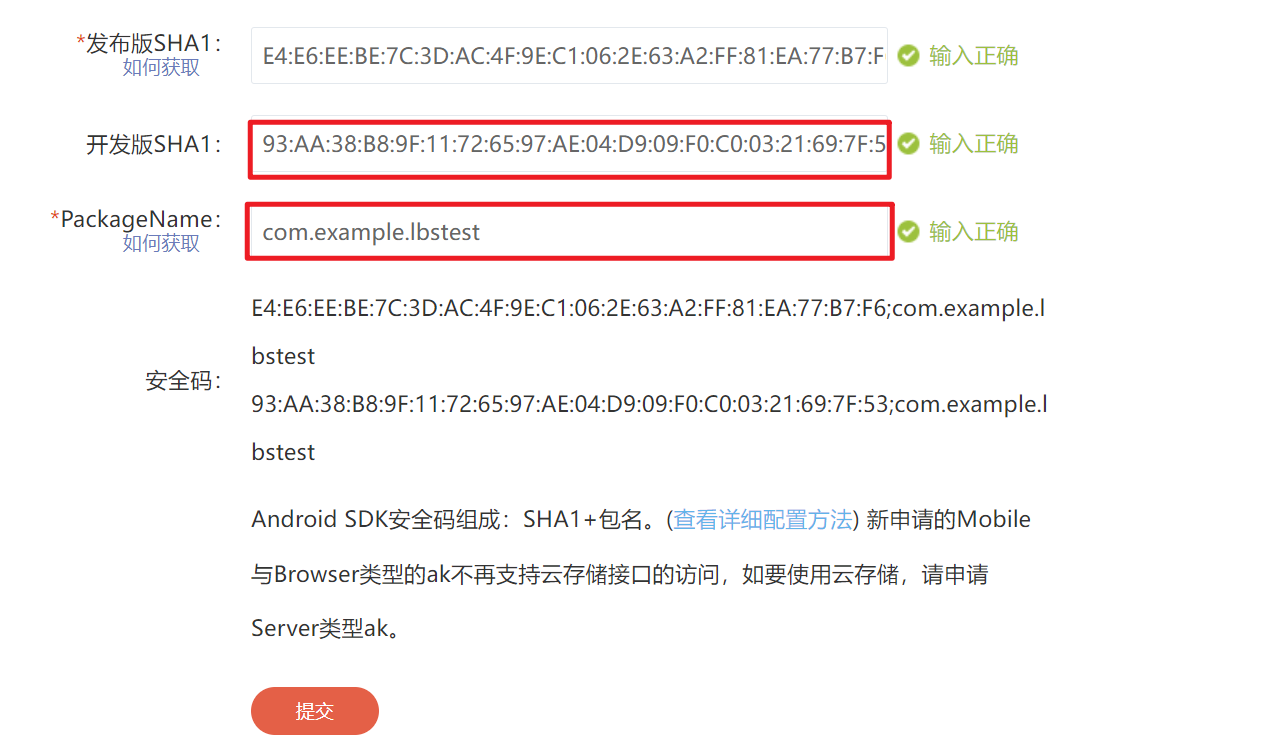
把 SHA1: 后面的字符复制到创建百度地图应用界面的对应位置,

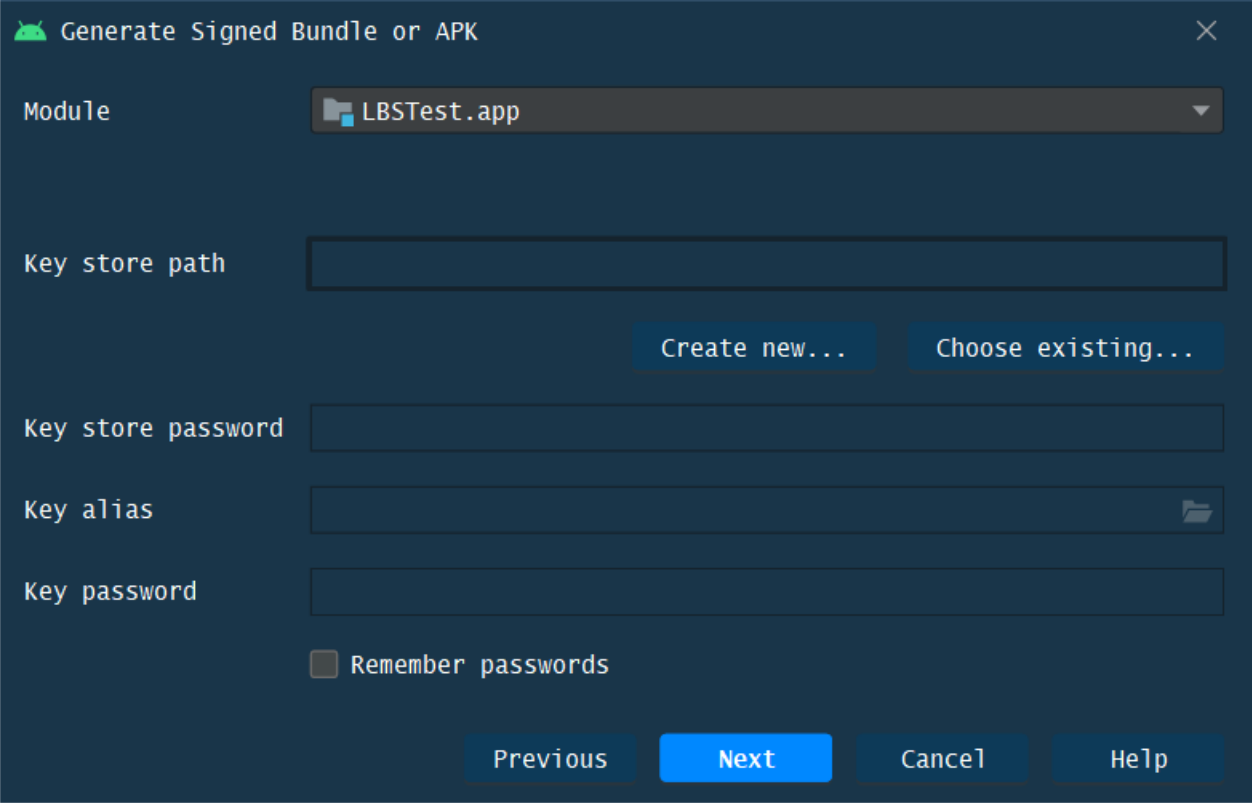
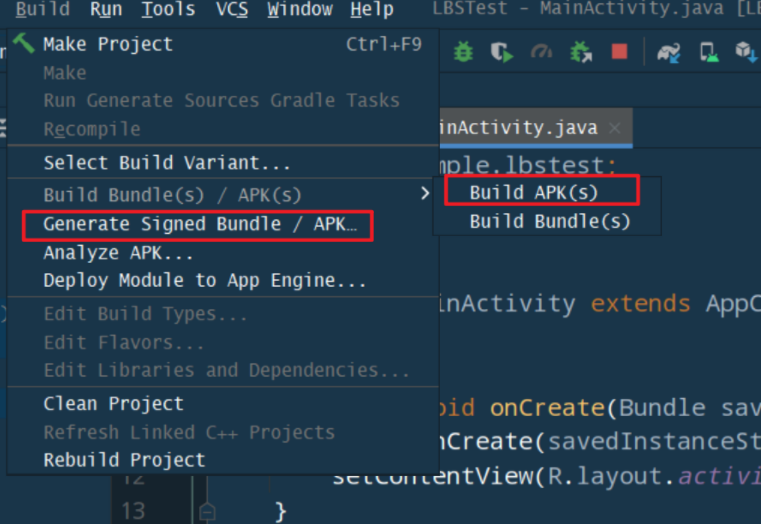
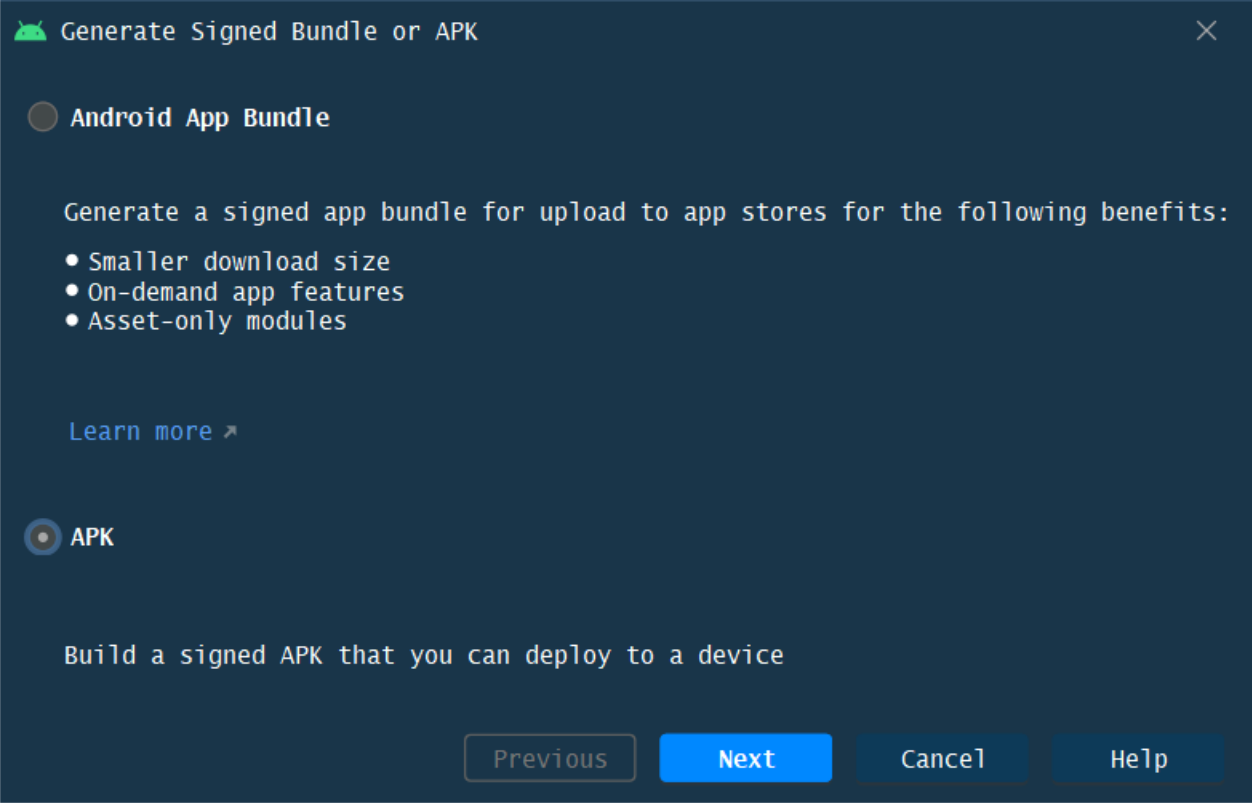
开发版的 SHA1 我们需要创建一个正式的签名文件,点击 Android Studio 顶部工具栏中的 Build --> Generate Signed APK,弹出如下窗口

选择APK:

NEXT:

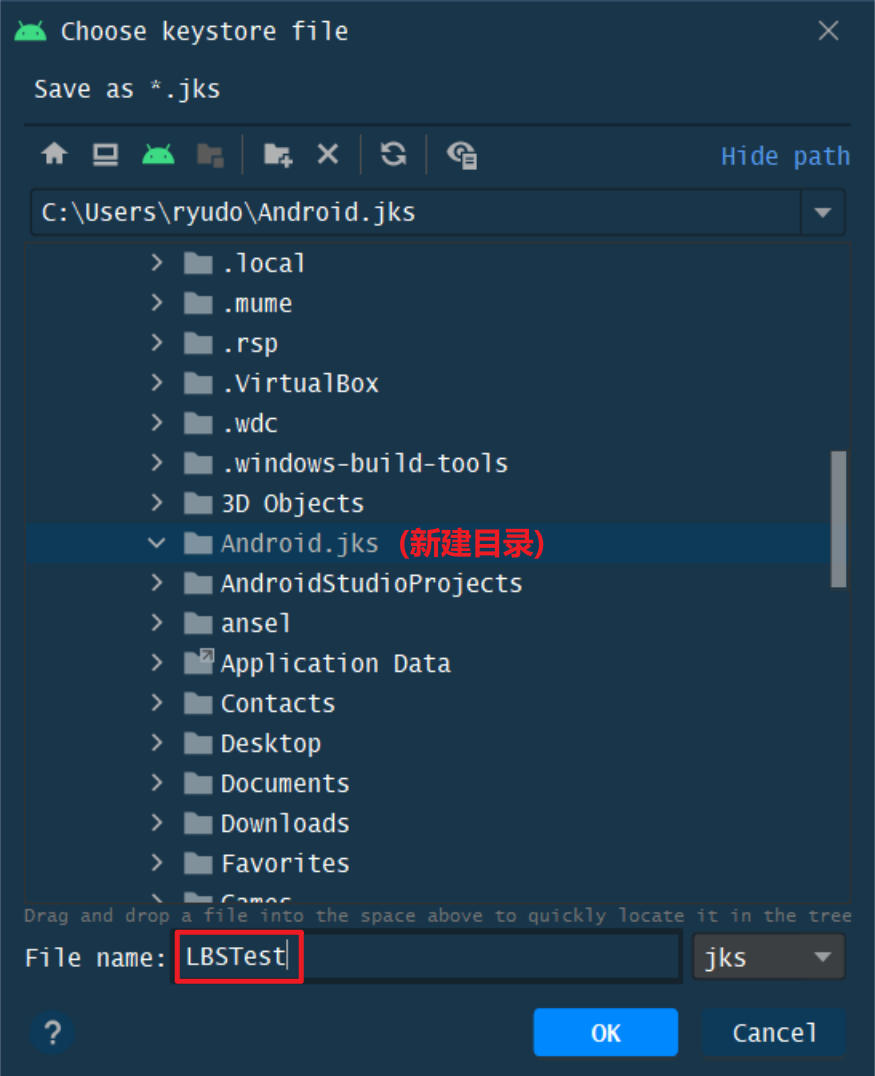
点击 Create new… 弹出如下窗口

在Key Store path处选择签名文件保存的路径,并填写签名文件名称,并点击 OK

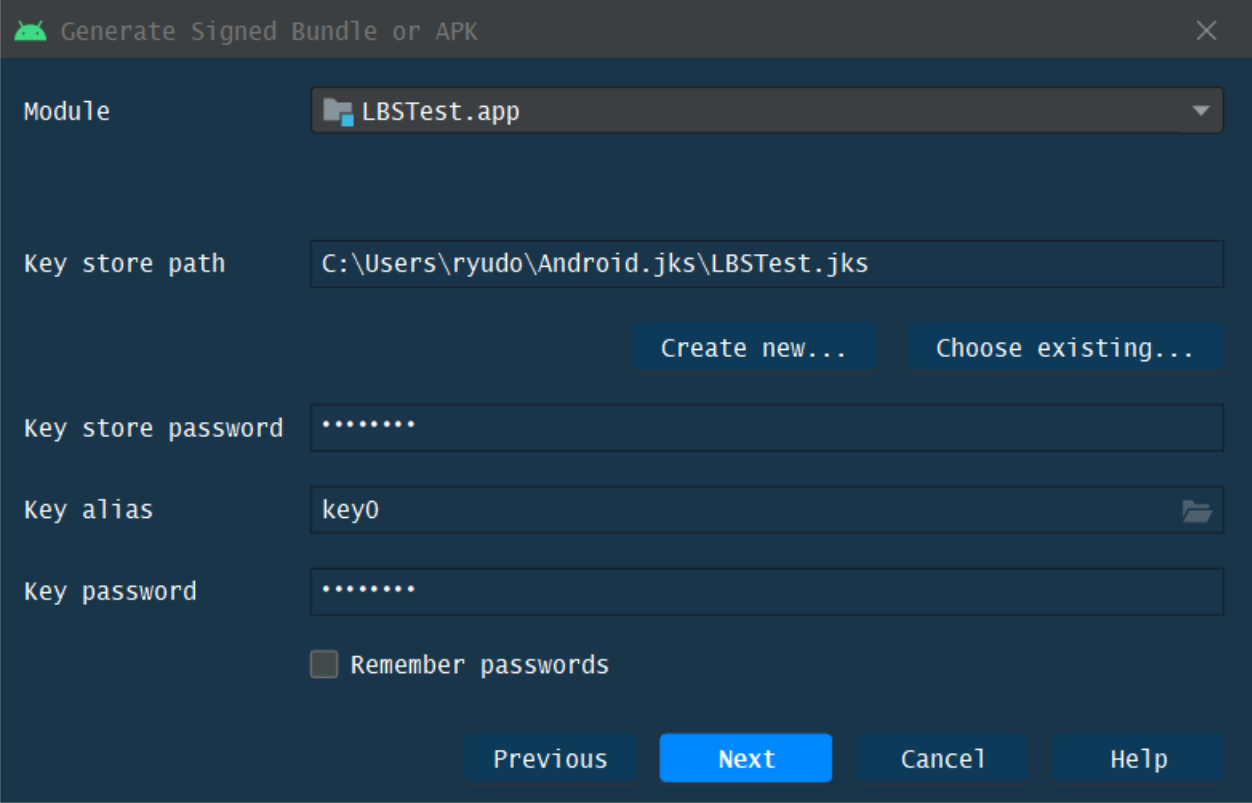
填写密码和名字

点击 OK,会回到如下界面,然后直接点击右上角关闭这个窗口

然后按 win + r 输入 cmd 输入如下命令,

keytool -list -v -keystore <签名文件路径>

比如我创建的签名文件路径为 C:\Users\ryudo\Android.jks\LBSTest.jks ,则完整命令为:

keytool -list -v -keystore C:\Users\ryudo\Android.jks\LBSTest.jks

输入之前提供的密码, 输出如上所示. 从中找到SHAI证书指纹:

SHA1: 93:AA:38:B8:9F:11:72:65:97:AE:04:D9:09:F0:C0:03:21:69:7F:53

把 SHA1:后的字符复制到创建百度地图应用界面的对应位置。
包名这里我们填 com.example.lbstest (包名在我们创建 Android project 的界面中已经设置了)

点击提交, 应用的创建成功了.

image-20221128202257464

上图中WFxwnrDH4vCzwzxxxxxxxxxxxxxxxxxxxx 就是我们申请到的 API Key, 可以点击复制到剪切板。

使用百度定位

建议在手机上运行调试

下载 LBS SDK

在开始编码之前,我们需要下载百度 LBS 开放平台的 SDK,下载地址为 http://lbsyun.baidu.com/index.php?title=sdk/download&action#selected=mapsdk_basicmap,mapsdk_searchfunction,mapsdk_lbscloudsearch,mapsdk_calculationtool,mapsdk_radar

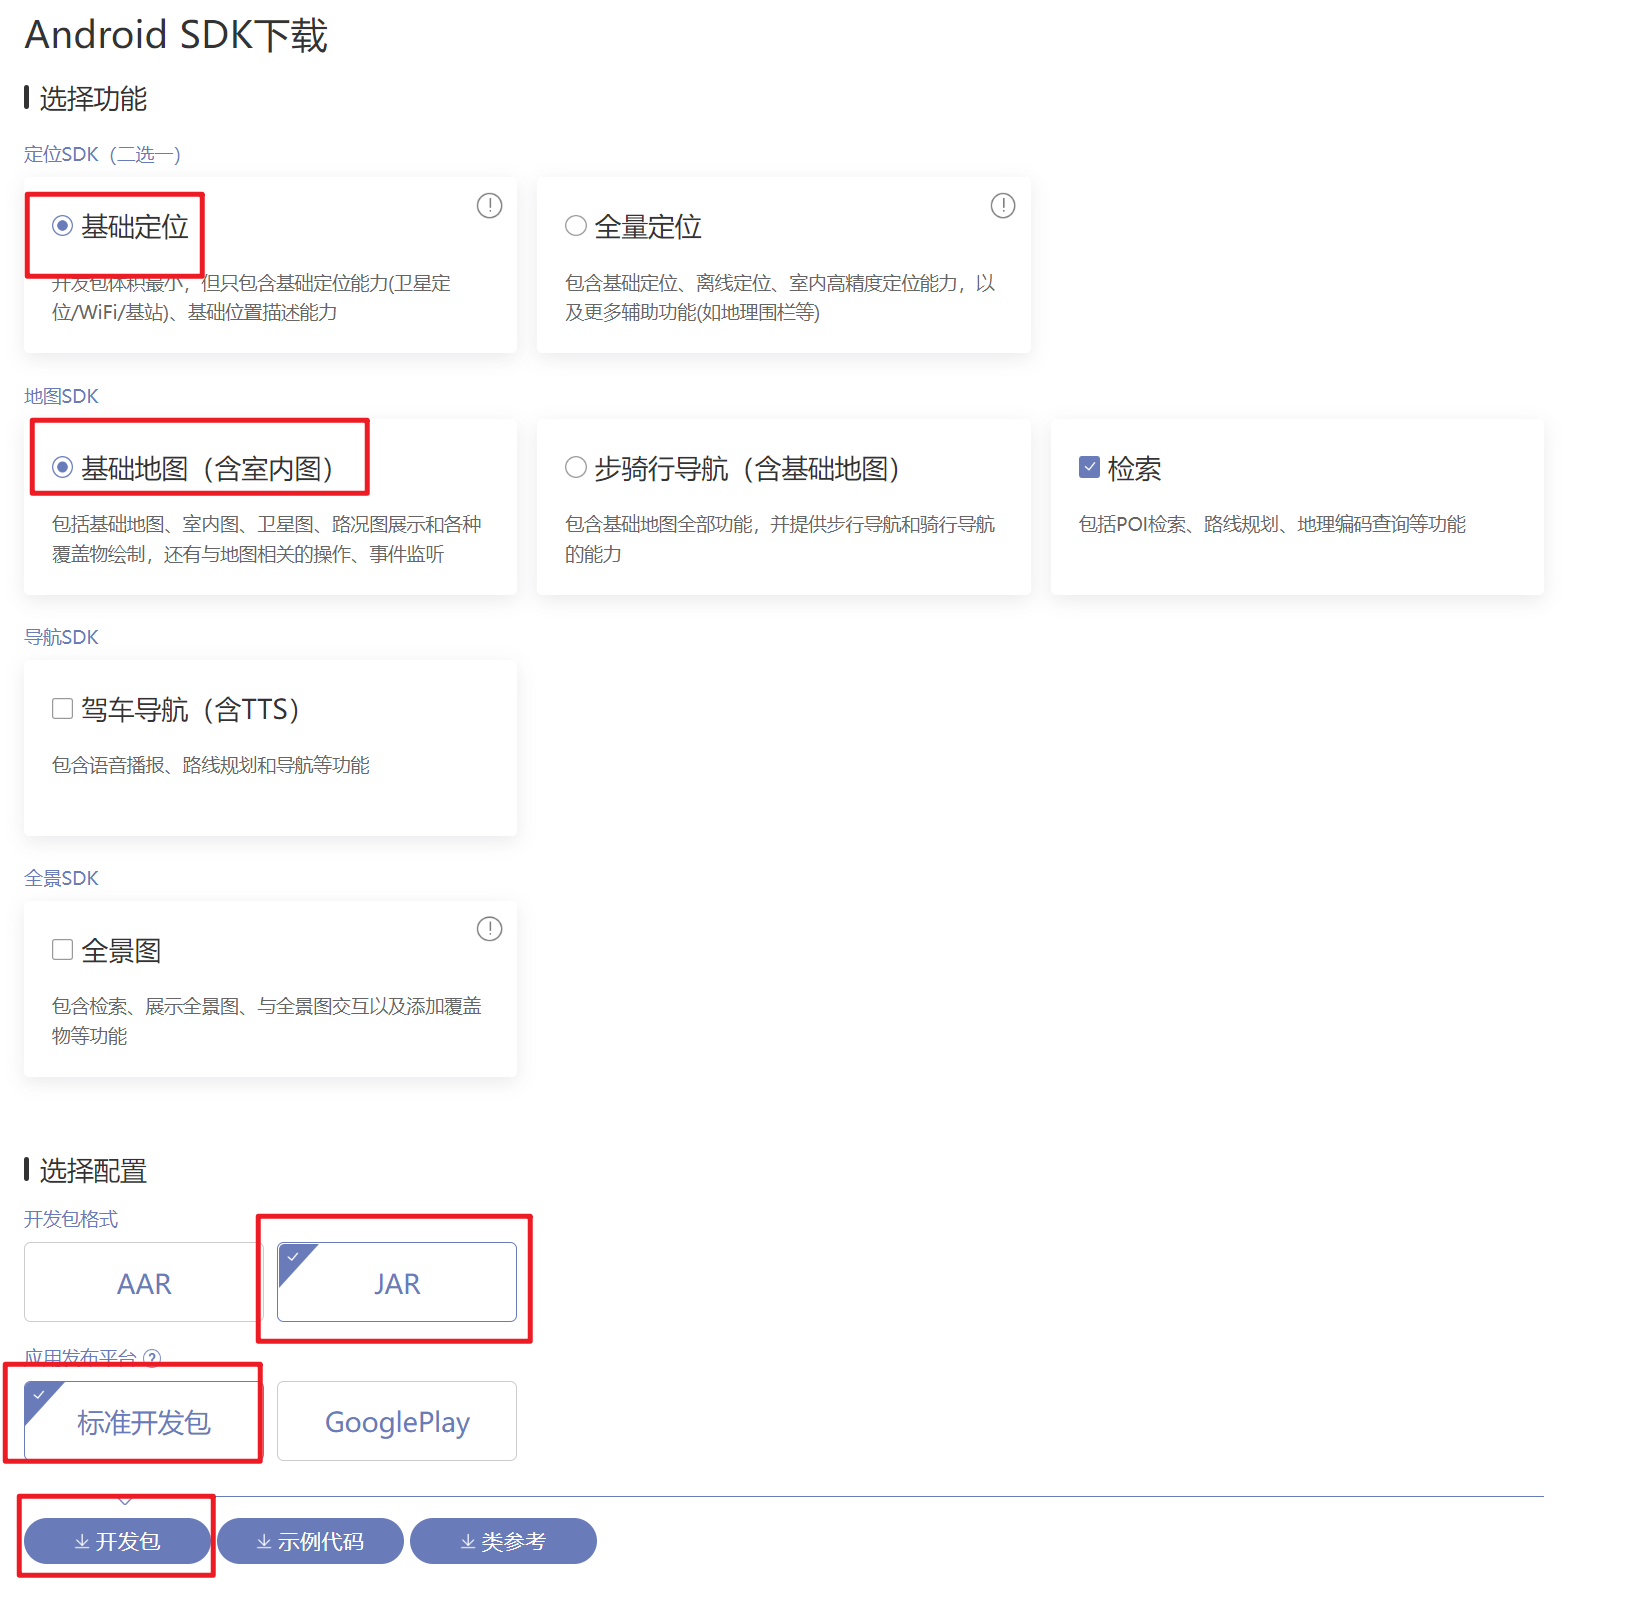
选择 基础定位 和 基础地图 然后点击 开发包 下载按钮

在使用之前,您需要先申请密钥,且密钥和应用证书和包名绑定。

添加依赖库

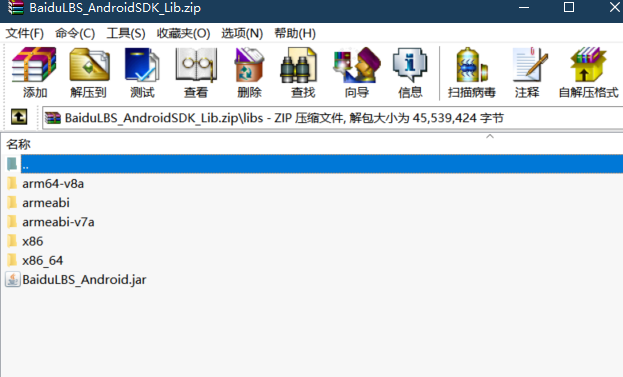
解压下载的文件,在下载文件中 libs 目录下的内容分为两部分,如图,BaiduLBS_Android.jar 是 Java 层要使用的,其他子目录下的 so 文件时 Native 层要用到的。so 文件是用 C/C++ 语言编写的,然后再用 NDK 编译出来的。 我们这里不需要编写 C/C++ 的代码,因为百度都已经做好了封装, 但是我们需要将 libs 目录下的每一个文件都放到正确的位置。

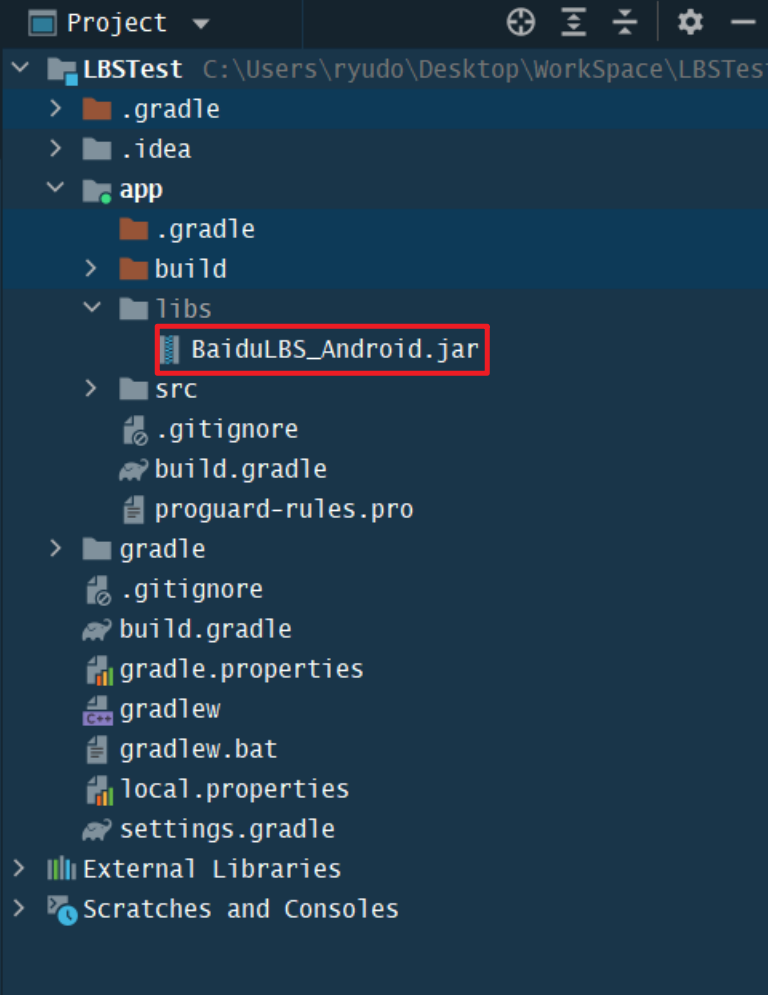
观察一下当前的项目结构, app 模块下有一个 libs 目录,这里就是用来存放所有 Jar 包的,我们将 BaiduLBS_Android.jar 复制到这个目录下,如下图所示(需要切换为Project视图)

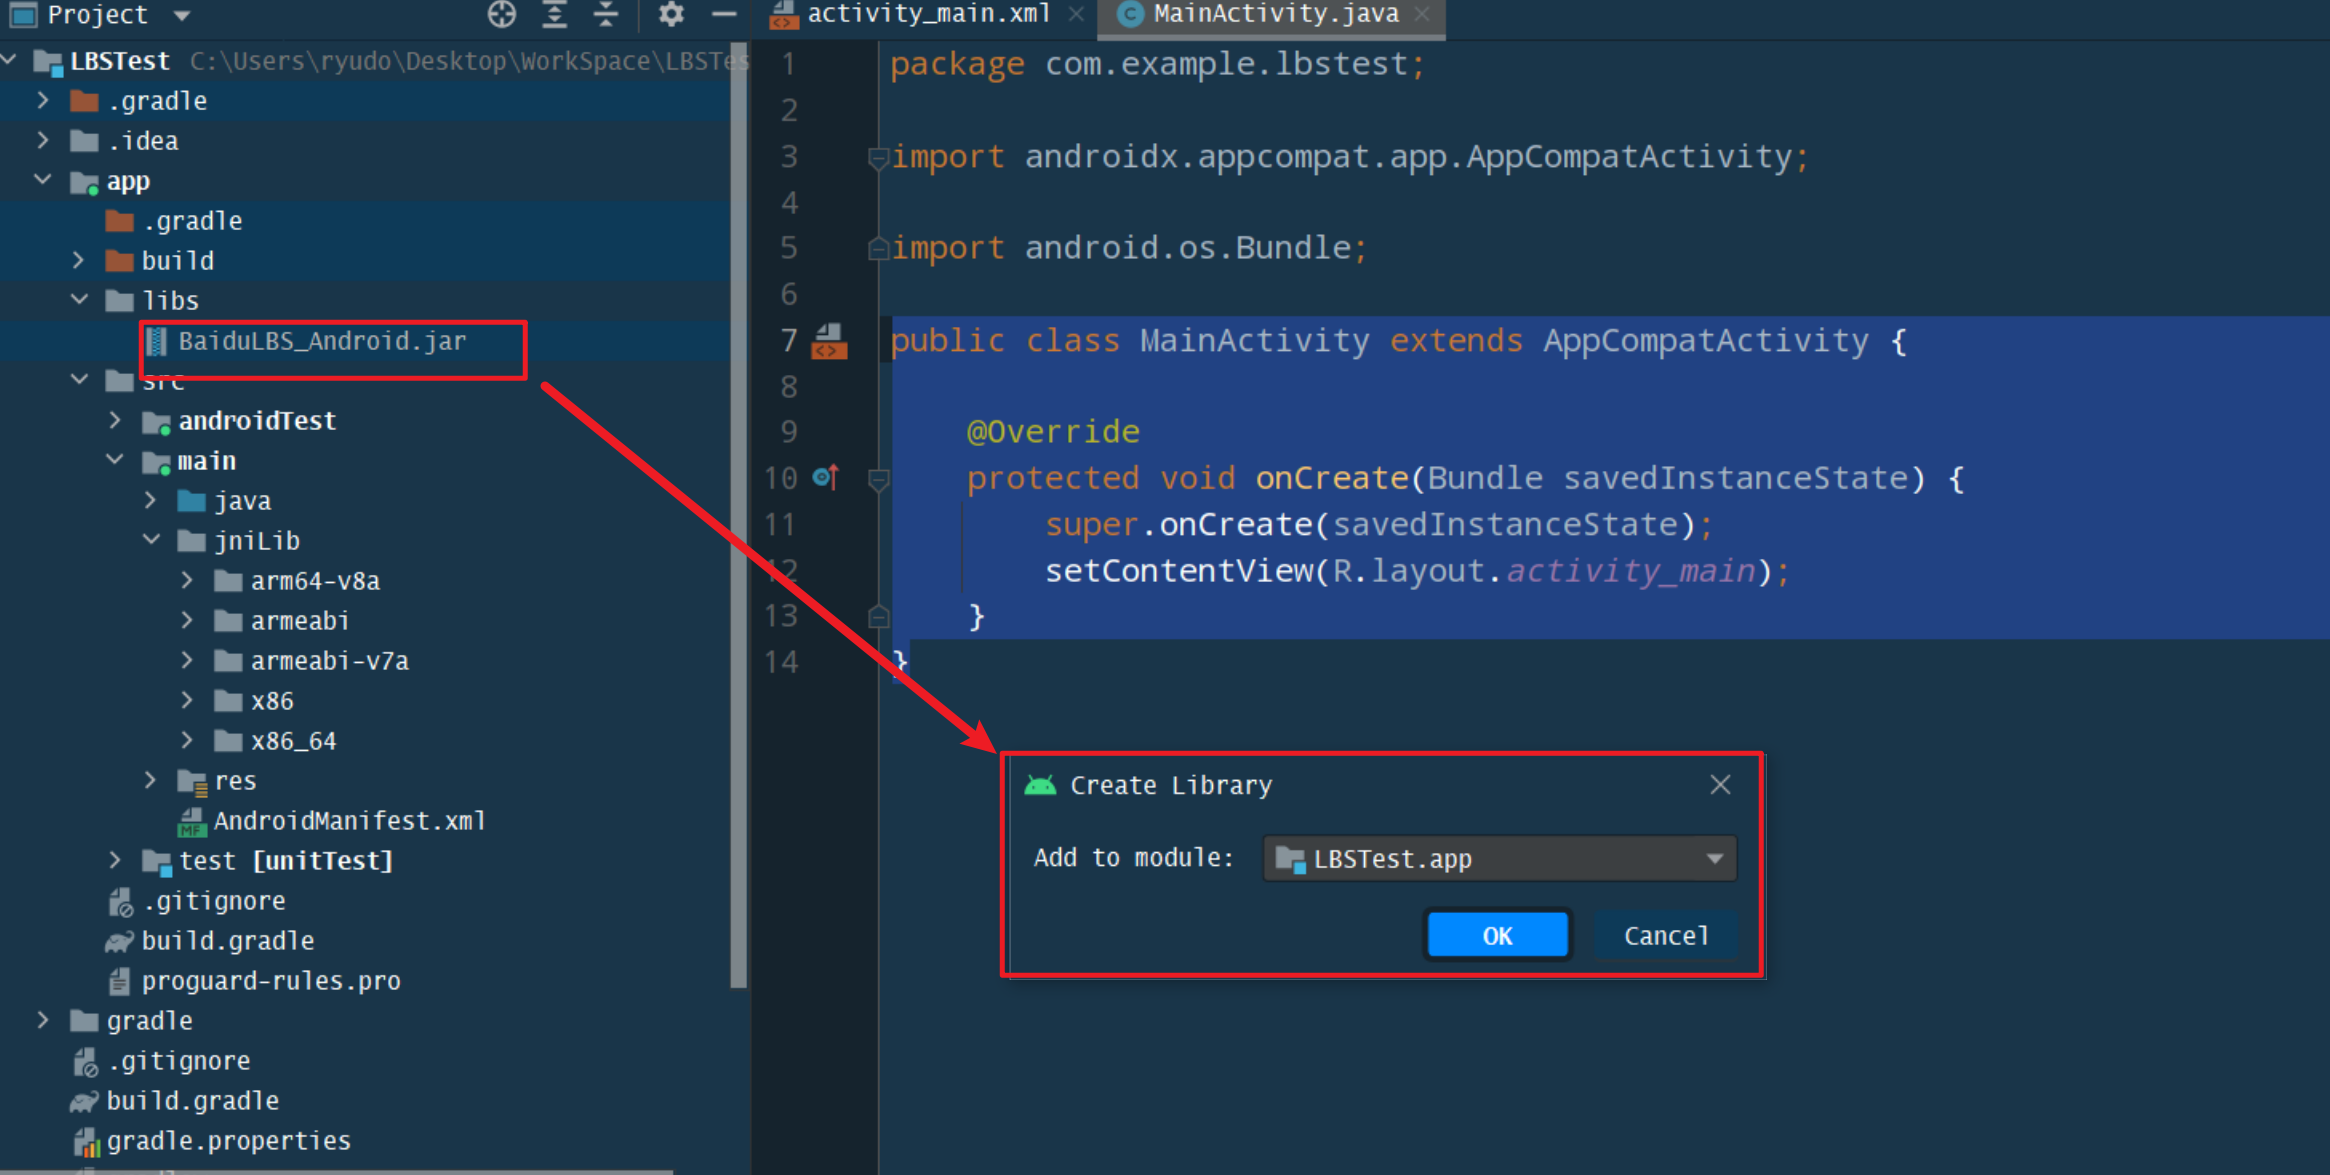
接下来,展开 src/main 目录,鼠标右键点击该目录–>New–>Directory, 创建一个名为 jniLibs 的目录,这个目录是专门用来存放 so 文件的,然后把压缩包里的其他所有目录直接复制到这里,如图

为了让项目引用到 Jar 包中提供的接口,我们需要把BaiduLBS_Android.jar作为库添加到模块:

点击 Sync 之后,libs 目录下的 jar 文件就会多出一个向右的箭头,表示项目已经能引用到这些 jar 包
这样我们就把 LBS 的 SDK 都准备好了,接下来就可以开始编码了

编码

MainActivity.java 代码如下:

package com.example.lbstest;

import android.Manifest;
import android.content.pm.PackageManager;
import android.os.Bundle;
import android.widget.Toast;

import androidx.appcompat.app.AppCompatActivity;
import androidx.core.app.ActivityCompat;
import androidx.core.content.ContextCompat;

import com.baidu.location.BDLocation;
import com.baidu.location.BDLocationListener;
import com.baidu.location.LocationClient;
import com.baidu.location.LocationClientOption;
import com.baidu.mapapi.CoordType;
import com.baidu.mapapi.SDKInitializer;
import com.baidu.mapapi.common.BaiduMapSDKException;
import com.baidu.mapapi.map.BaiduMap;
import com.baidu.mapapi.map.MapStatusUpdate;
import com.baidu.mapapi.map.MapStatusUpdateFactory;
import com.baidu.mapapi.map.MapView;
import com.baidu.mapapi.map.MyLocationData;
import com.baidu.mapapi.model.LatLng;

import java.util.ArrayList;
import java.util.List;

public class MainActivity extends AppCompatActivity {

    public LocationClient mLocationClient;

    private MapView mapView;
    private BaiduMap baiduMap;
    private boolean isFirstLocate = true;

    @Override
    protected void onCreate(Bundle savedInstanceState) {
        super.onCreate(savedInstanceState);

        // 是否同意隐私政策,默认为false
        SDKInitializer.setAgreePrivacy(getApplicationContext(), true);
        try {
            // 在使用 SDK 各组间之前初始化 context 信息,传入 ApplicationContext
            SDKInitializer.initialize(getApplicationContext());

            // 自4.3.0起,百度地图SDK所有接口均支持百度坐标和国测局坐标,用此方法设置您使用的坐标类型.
            // 包括BD09LL和GCJ02两种坐标,默认是BD09LL坐标。
            SDKInitializer.setCoordType(CoordType.BD09LL);
            // 百度地图接口,最新颁布了“隐私合规接口”。就是在百度地图获得定位时,要用户同意定位。
            LocationClient.setAgreePrivacy(true);
            try {
                mLocationClient = new LocationClient(getApplicationContext());
                mLocationClient.registerLocationListener(new MyLocationListener());

                setContentView(R.layout.activity_main);
                mapView = (MapView) findViewById(R.id.bmapView);
                baiduMap = mapView.getMap();
                baiduMap.setMyLocationEnabled(true);//用于显示我的位置

                // 动态申请权限
                List<String> permissionList = new ArrayList<>();
                if (ContextCompat.checkSelfPermission(MainActivity.this, Manifest.
                        permission.ACCESS_FINE_LOCATION) != PackageManager.PERMISSION_GRANTED) {
                    permissionList.add(Manifest.permission.ACCESS_FINE_LOCATION);
                }
                if (ContextCompat.checkSelfPermission(MainActivity.this, Manifest.
                        permission.WRITE_EXTERNAL_STORAGE) != PackageManager.PERMISSION_GRANTED) {
                    permissionList.add(Manifest.permission.WRITE_EXTERNAL_STORAGE);
                }
                if (!permissionList.isEmpty()) {
                    String[] permissions = permissionList.toArray(new String[permissionList.
                            size()]);

                    ActivityCompat.requestPermissions(MainActivity.this, permissions, 1);
                } else {
                    requestLocation();
                }
            } catch (Exception e) {
                e.printStackTrace();
            }
        } catch (BaiduMapSDKException e) {
            e.printStackTrace();
        }

    }

    //用于首次定位让地图移动到当前位置
    private void navigateTo(BDLocation location) {
        if (isFirstLocate) {
            LatLng ll = new LatLng(location.getLatitude(), location.getLongitude());//用于存放经纬度
            MapStatusUpdate update = MapStatusUpdateFactory.newLatLng(ll);
            baiduMap.animateMapStatus(update);
            update = MapStatusUpdateFactory.zoomTo(16f);//缩放级别
            baiduMap.animateMapStatus(update);
            isFirstLocate = false;
        }
        MyLocationData.Builder locationBuilder = new MyLocationData.Builder();
        locationBuilder.latitude(location.getLatitude());
        locationBuilder.longitude(location.getLongitude());
        MyLocationData locationData = locationBuilder.build();
        baiduMap.setMyLocationData(locationData);
    }

    private void requestLocation() {
        initLocation();
        mLocationClient.start(); // start方法开始定位
    }

    private void initLocation() {
        LocationClientOption option = new LocationClientOption();
        option.setScanSpan(5000); // 5秒更新一次位置信息
        option.setIsNeedAddress(true); // 启用详细位置
        option.setLocationMode(LocationClientOption.LocationMode.Device_Sensors);//使用GPS定位
        mLocationClient.setLocOption(option);
    }

    @Override
    protected void onResume() {
        super.onResume();
        mapView.onResume();
    }

    @Override
    protected void onPause() {
        super.onPause();
        mapView.onPause();
    }

    @Override
    protected void onDestroy() {
        super.onDestroy();
        mLocationClient.stop();//活动销毁
        mapView.onDestroy();
        baiduMap.setMyLocationEnabled(false);
    }

    /**
     * 动态权限检查
     * @param requestCode
     * @param permissions
     * @param grantResults
     */
    @Override
    public void onRequestPermissionsResult(int requestCode, String[] permissions,
                                           int[] grantResults) {
        super.onRequestPermissionsResult(requestCode, permissions, grantResults);
        switch (requestCode) {
            case 1:
                if (grantResults.length > 0) {
                    for (int result : grantResults) {
                        if (result != PackageManager.PERMISSION_GRANTED) {
                            Toast.makeText(this, "必须同意所有权限才能使用本程序",
                                    Toast.LENGTH_SHORT).show();
                            finish();
                            return;
                        }
                    }
                    requestLocation();
                } else {
                    Toast.makeText(this, "发生未知错误", Toast.LENGTH_SHORT).show();
                    finish();
                }
                break;
            default:
        }
    }

    public class MyLocationListener implements BDLocationListener {

        @Override
        public void onReceiveLocation(final BDLocation location) {
            if (location.getLocType() == BDLocation.TypeGpsLocation
                    || location.getLocType() == BDLocation.TypeNetWorkLocation) {
                navigateTo(location);
            }
        }
    }
}

activity_main.xml 布局文件代码如下:

<?xml version="1.0" encoding="utf-8"?>
<LinearLayout xmlns:android="http://schemas.android.com/apk/res/android"
    android:orientation="vertical"
    android:layout_width="match_parent"
    android:layout_height="match_parent">

    //地图控件使其占满整个屏幕
    <com.baidu.mapapi.map.MapView
        android:id="@+id/bmapView"
        android:layout_width="match_parent"
        android:layout_height="match_parent"
        android:clickable="true"/>

</LinearLayout>

权限文件 AndroidManifest.xml 代码如下:

<?xml version="1.0" encoding="utf-8"?>
<manifest xmlns:android="http://schemas.android.com/apk/res/android"
    xmlns:tools="http://schemas.android.com/tools"
    package="com.example.lbstest">

    <!-- 添加权限 -->
    <!-- 访问网络,进行地图相关业务数据请求,包括地图数据,路线规划,POI检索等 -->
    <uses-permission android:name="android.permission.INTERNET" />
    <!-- 获取网络状态,根据网络状态切换进行数据请求网络转换 -->
    <uses-permission android:name="android.permission.ACCESS_NETWORK_STATE" />
    <!-- 读取外置存储。如果开发者使用了so动态加载功能并且把so文件放在了外置存储区域,则需要申请该权限,否则不需要 -->
    <uses-permission android:name="android.permission.READ_EXTERNAL_STORAGE" />
    <!-- 写外置存储。如果开发者使用了离线地图,并且数据写在外置存储区域,则需要申请该权限 -->
    <uses-permission android:name="android.permission.WRITE_EXTERNAL_STORAGE" />
    <!-- 这个权限用于进行网络定位 -->
    <uses-permission android:name="android.permission.ACCESS_COARSE_LOCATION" />
    <!-- 这个权限用于访问GPS定位 -->
    <uses-permission android:name="android.permission.ACCESS_FINE_LOCATION" />

    <application
        android:allowBackup="true"
        android:dataExtractionRules="@xml/data_extraction_rules"
        android:fullBackupContent="@xml/backup_rules"
        android:icon="@mipmap/ic_launcher"
        android:label="@string/app_name"
        android:roundIcon="@mipmap/ic_launcher_round"
        android:supportsRtl="true"
        android:theme="@style/Theme.LBSTest"
        tools:targetApi="31">
        <!-- 将百度lbsAPI的AK添加到元数据中 -->
        <meta-data
            android:name="com.baidu.lbsapi.API_KEY"
            android:value="WFxwnrDH4vCzwzxxxxxxxxxxxxxxxxxxxx" />
        <activity
            android:name=".MainActivity"
            android:exported="true">
            <intent-filter>
                <action android:name="android.intent.action.MAIN" />

                <category android:name="android.intent.category.LAUNCHER" />
            </intent-filter>
        </activity>
        <!--注册百度 LBS SDK 服务-->
        <service
            android:name="com.baidu.location.f"
            android:enabled="true"
            android:process=":remote">
        </service>
    </application>

</manifest>

至此,Android 百度地图初步开发完成

使用真机调试运行

为了正确显示定位效果, 建议使用真机运行和调试地图程序.

首先将真机(安卓或者鸿蒙均可)连接到开发机上

根据手机机型上网查询打开USB调试模式的方法.

我是系统更新-->开发人员选项-->USB调试

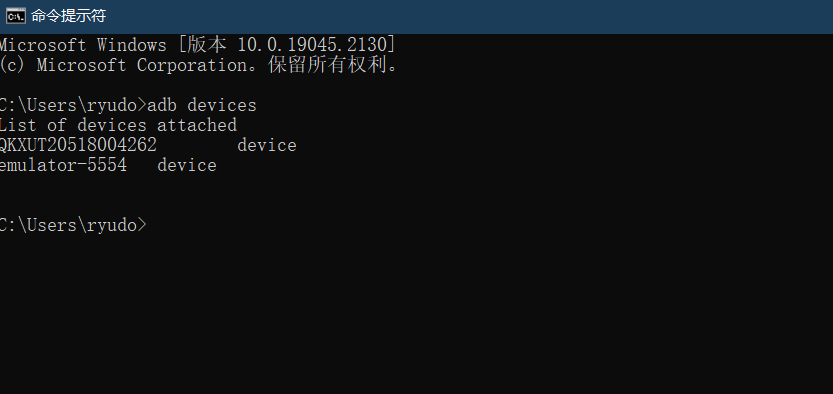
可以通过ADB命令检查是否连接上手机设备

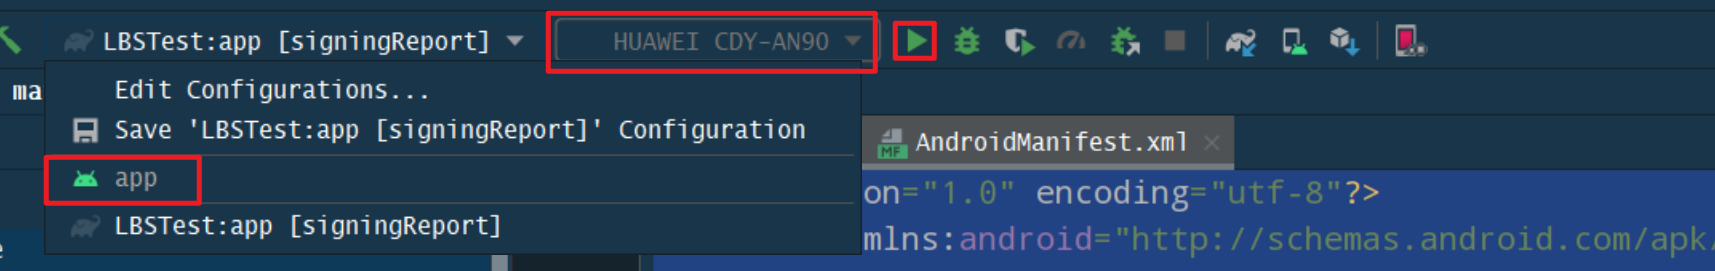
此时AndroidStudio的运行设备也会自动切换到物理机

切换Gradle任务为app, 点击运行:

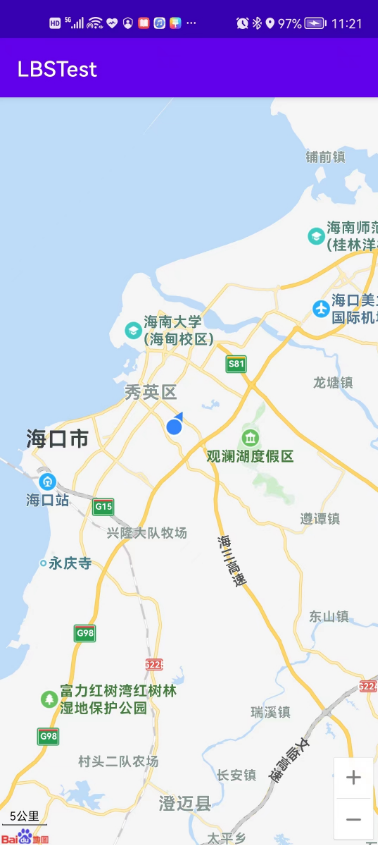
手机显示:

官方示例代码和API文档参考

img 示例代码
img API文档参考

Views: 822

[HBase]往 HBase 导入数据的几种操作

往 HBase 导入数据的几种操作

文章目录

一、前言

二、利用ImportTsv将csv文件导入到HBase

三、利用completebulkload将数据导入到HBase

四、利用Import将数据导入到HBase

一、前言

HBase作为Hadoop DataBase,除了使用put进行数据导入之外,还有以下几种导入数据的方式:

(1)使用importTsv功能将csv文件导入HBase;

(2)使用import功能,将数据导入HBase;

(3)使用BulkLoad功能将数据导入HBase。

二、利用ImportTsv将csv文件导入到HBase

simple.csv内容如下:

1,"Tony"
2,"Ivy"
3,"Tom"
4,"Spark"
5,"Storm"

创建文件

[root@hadoop1 datamove]# vim simple.csv
1,"Tony"
2,"Ivy"
3,"Tom"
4,"Spark"
5,"Storm"

格式:

hbase [类] [分隔符] [行键,列1,列2...] [表] [导入文件]

命令:

bin/hbase  org.apache.hadoop.hbase.mapreduce.ImportTsv  -Dimporttsv.separator="," 
-Dimporttsv.columns=HBASE_ROW_KEY,cf:data hbase-table-name /csv-file-name.csv

上传文件

[niit@niit01 data]$ hdfs dfs -put simple.csv /input/
[niit@niit01 data]$ hdfs dfs -ls /input/
Found 1 items
-rw-r--r--   1 niit supergroup         45 2022-11-04 09:08 /input/simple.csv

创建表

hbase(main):001:0> create 'tb1','cf'
0 row(s) in 3.1120 seconds
=> Hbase::Table - tb1

执行mapreduce

[niit@niit01 hbase]$ $ bin/hbase   org.apache.hadoop.hbase.mapreduce.ImportTsv  -Dimporttsv.separator=,  -Dimporttsv.columns=HBASE_ROW_KEY,cf:data tb1 /input/simple.csv

查看是否成功导入

hbase(main):003:0> scan 'tb1'
ROW                  COLUMN+CELL
 1                   column=cf:data, timestamp=1436152834178, value="Tony"
 2                   column=cf:data, timestamp=1436152834178, value="Ivy"
 3                   column=cf:data, timestamp=1436152834178, value="Tom"
 4                   column=cf:data, timestamp=1436152834178, value="Spark"
 5                   column=cf:data, timestamp=1436152834178, value="Storm"
5 row(s) in 0.1490 seconds

三、利用completebulkload将HFile格式数据导入到HBase

HBase支持bulkload的入库方式,它是利用hbase的数据信息按照特定格式存储在hdfs内这一原理,直接在HDFS中生成持久化的HFile数据格式文件,然后上传至合适位置,即完成巨量数据快速入库的办法。配和mapreduce完成,高效便捷,而且不占用region资源,增添负载,在大数据量写入时,能极大的提高写入效率,并降低对HBase节点的写入压力。

通过使用先生成HFile,然后再BulkLoad到HBase的方式来替代之前直接调用HTableOutputFormat的方法有如下的好处:

1、消除了对HBase集群的插入压力

2、提高了Job的运行速度,降低了Job的执行时间

利用completebulkload将数据导入到HBase

1、先通过lmportTsv生成HFile

将csv导入为hfile文件

bin/hbase org.apache.hadoop.hbase.mapreduce.ImportTsv -Dimporttsv.separator=,  -Dmapreduce.map.speculative=false -Dmapreduce.reduce.speculative=false -Dimporttsv.skip.bad.lines=true -Dimporttsv.bulk.output=/output/hfile-tmp -Dimporttsv.columns=HBASE_ROW_KEY,cf:data tb2 /input/simple.csv

以上的指令,它会主动创建表tb2和文件夹hfile-tmp(此文件夹必须不能事先存在)。

[niit@niit01 hbase]$ hdfs dfs -ls -R /output/hfile-tmp
-rw-r--r--   1 niit supergroup          0 2022-11-04 10:12 /output/hfile-tmp/_SUCCESS
drwxr-xr-x   - niit supergroup          0 2022-11-04 10:12 /output/hfile-tmp/cf
-rw-r--r--   1 niit supergroup       5141 2022-11-04 10:12 /output/hfile-tmp/cf/5179350ee60b40cf9fe9a3c51c682a2a

将hfile数据以增量的方式导入表 tb2, 对应的hfile也会被移动到相应的hbase表的目录下

[niit@niit01 hbase]$ bin/hbase  org.apache.hadoop.hbase.tool.LoadIncrementalHFiles /output/hfile-tmp tb2

验证

hbase(main):003:0> scan 'tb2'
ROW                         COLUMN+CELL
 1                          column=cf:data, timestamp=1667527923246, value="Tony"
 2                          column=cf:data, timestamp=1667527923246, value="Ivy"
 3                          column=cf:data, timestamp=1667527923246, value="Tom"
 4                          column=cf:data, timestamp=1667527923246, value="Spark"
 5                          column=cf:data, timestamp=1667527923246, value="Storm"
5 row(s)
Took 0.0541 seconds

四、利用Import将Sequence File格式的数据导入到HBase

1、HBase export工具导出的数据的格式是sequence file。

比如,在执行完命令bin/hbase org.apache.hadoop.hbase.mapreduce.Export 之后,hbase会启动一个MapReduce作业,作业完成后会在hdfs上面会生成sequence file格式的数据文件。

2、对于这类Sequence file格式的数据文件,HBase是可以通过Import工具直接将它导入到HBase的表里面的。

将数据导出到hdfs中, 格式为sequence file,

[niit@niit01 hbase]$ bin/hbase org.apache.hadoop.hbase.mapreduce.Export tb2 /output/test

创建新表

hbase(main):010:0> create 'tb3','cf'
0 row(s) in 0.4290 seconds
=> Hbase::Table - tb3

导入到hbase (导入后, 源sequence file仍然存在, 如需删除需要手动删除)

[root@hadoop1 lib]# hbase org.apache.hadoop.hbase.mapreduce.Import tb3 /output/test

验证

hbase(main):011:0> scan 'tb3'
ROW                  COLUMN+CELL
 1                   column=cf:data, timestamp=1436152834178, value="Tony"
 2                   column=cf:data, timestamp=1436152834178, value="Ivy"
 3                   column=cf:data, timestamp=1436152834178, value="Tom"
 4                   column=cf:data, timestamp=1436152834178, value="Spark"
 5                   column=cf:data, timestamp=1436152834178, value="Storm"
5 row(s) in 0.0580 seconds

Views: 492