
1、DataX 基本介绍
-
DataX 是阿里巴巴集团内被广泛使用的离线数据同步工具,致力于实现包括:关系型数据库(MySQL、Oracle等)、HDFS、Hive、HBase、ODPS、FTP等各种异构数据源之间稳定高效的数据同步功能。
-
设计理念
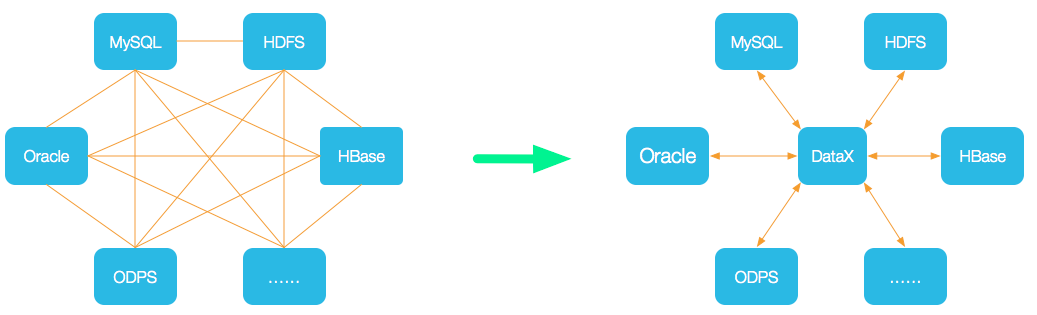
- 为了解决异构数据源同步问题,DataX将复杂的网状的同步链路变成了星型数据链路,DataX作为中间传输载体负责连接各种数据源。当需要接入一个新的数据源的时候,只需要将此数据源对接到DataX,便能跟已有的数据源做到无缝数据同步。
-
当前使用现状
- DataX在阿里巴巴集团内被广泛使用,承担了所有大数据的离线同步业务,并已持续稳定运行了6年之久。目前每天完成同步8w多道作业,每日传输数据量超过300TB。
- 此前已经开源DataX1.0版本,此次介绍为阿里云开源全新版本DataX 3.0,有了更多更强大的功能和更好的使用体验。Github主页地址:https://github.com/alibaba/DataX
2、DataX 3.0 框架设计
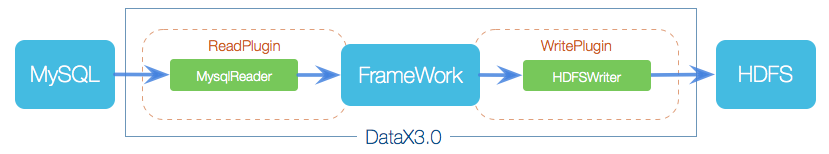
DataX本身作为离线数据同步框架,采用Framework + plugin架构构建。将数据源读取和写入抽象成为Reader/Writer插件,纳入到整个同步框架中。- Reader
- Reader 为数据采集模块,负责采集数据源的数据,将数据发送给 Framework。
- Writer
- Writer 为数据写入模块,负责不断向 Framework 取数据,并将数据写入到目的端。
- Framework
- Framework 用于连接 Reader 和 Writer,作为两者的数据传输通道,并处理缓冲,流控,并发,数据转换等核心技术问题。
3、DataX 3.0 插件体系
- 经过几年积累,DataX目前已经有了比较全面的插件体系,主流的RDBMS数据库、NOSQL、大数据计算系统都已经接入。DataX目前支持数据如下:
| 类型 | 数据源 | Reader(读) | Writer(写) | 文档 |
|---|---|---|---|---|
| RDBMS 关系型数据库 | MySQL | √ | √ | 读 、写 |
| Oracle | √ | √ | 读 、写 | |
| SQLServer | √ | √ | 读 、写 | |
| PostgreSQL | √ | √ | 读 、写 | |
| DRDS | √ | √ | 读 、写 | |
| 达梦 | √ | √ | 读 、写 | |
| 通用RDBMS(支持所有关系型数据库) | √ | √ | 读 、写 | |
| 阿里云数仓数据存储 | ODPS | √ | √ | 读 、写 |
| ADS | √ | 写 | ||
| OSS | √ | √ | 读 、写 | |
| OCS | √ | √ | 读 、写 | |
| NoSQL数据存储 | OTS | √ | √ | 读 、写 |
| Hbase0.94 | √ | √ | 读 、写 | |
| Hbase1.1 | √ | √ | 读 、写 | |
| MongoDB | √ | √ | 读 、写 | |
| Hive | √ | √ | 读 、写 | |
| 无结构化数据存储 | TxtFile | √ | √ | 读 、写 |
| FTP | √ | √ | 读 、写 | |
| HDFS | √ | √ | 读 、写 | |
| Elasticsearch | √ | 写 |
4、DataX 3.0 核心架构
-
DataX 3.0 支持单机多线程模式完成 数据同步作业,本小节按一个DataX作业生命周期的时序图,从整体架构设计简要说明DataX各个模块之间的相互关系。
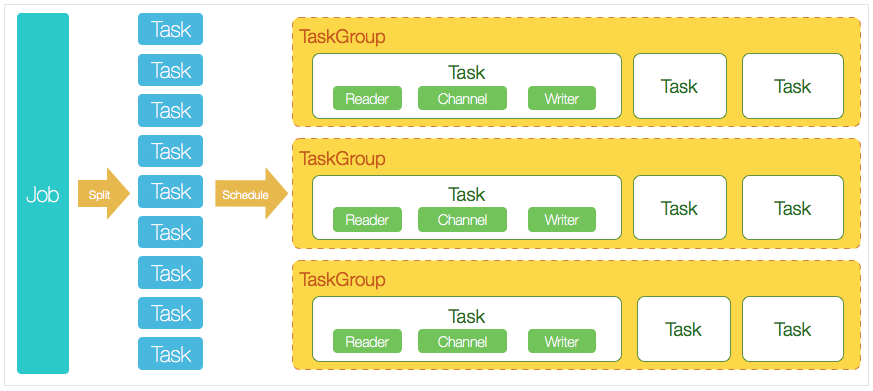
-
核心模块介绍
-
- DataX完成单个数据同步的作业,我们称之为Job,DataX接受到一个Job之后,将启动一个进程来完成整个作业同步过程。DataX Job模块是单个作业的中枢管理节点,承担了数据清理、子任务切分(将单一作业计算转化为多个子Task)、TaskGroup管理等功能。
-
- DataX Job启动后,会根据不同的源端切分策略,将Job切分成多个小的Task(子任务),以便于并发执行。Task便是DataX作业的最小单元,每一个Task都会负责一部分数据的同步工作。
-
- 切分多个Task之后,DataX Job会调用 Scheduler 模块,根据配置的并发数据量,将拆分成的Task重新组合,组装成TaskGroup(任务组)。每一个TaskGroup负责以一定的并发运行完毕分配好的所有Task,默认单个任务组的并发数量为5。
-
- 每一个Task都由TaskGroup负责启动,Task启动后,会固定启动Reader—>Channel—>Writer的线程来完成任务同步工作。
-
- DataX作业运行起来之后, Job监控并等待多个TaskGroup模块任务完成,等待所有TaskGroup任务完成后Job成功退出。否则,异常退出,进程退出值非0。
-
-
DataX调度流程
-
举例来说,用户提交了一个DataX作业,并且配置了20个并发,目的是将一个100张分表的mysql数据同步到odps里面。 DataX的调度决策思路是:
-
- DataXJob根据分库分表切分成了100个Task。
-
- 根据20个并发,默认单个任务组的并发数量为5,DataX计算共需要分配4个TaskGroup。
-
- 这里4个TaskGroup平分切分好的100个Task,每一个TaskGroup负责以5个并发共计运行25个Task。
-
5、DataX 安装部署
-
安装前置要求
- Linux
- JDK ( 1.8 以上 )
- Python ( 2.6 以上 )
-
1、访问官网下载安装包
-
2、上传安装包到服务器node01节点
-
3、解压安装包到指定的目录中
tar -zxvf datax.tar.gz -C /kkb/install -
4、运行自检脚本测试
[hadoop@node01 bin]$ cd /kkb/install/datax/bin
[hadoop@node01 bin]$ python datax.py ../job/job.json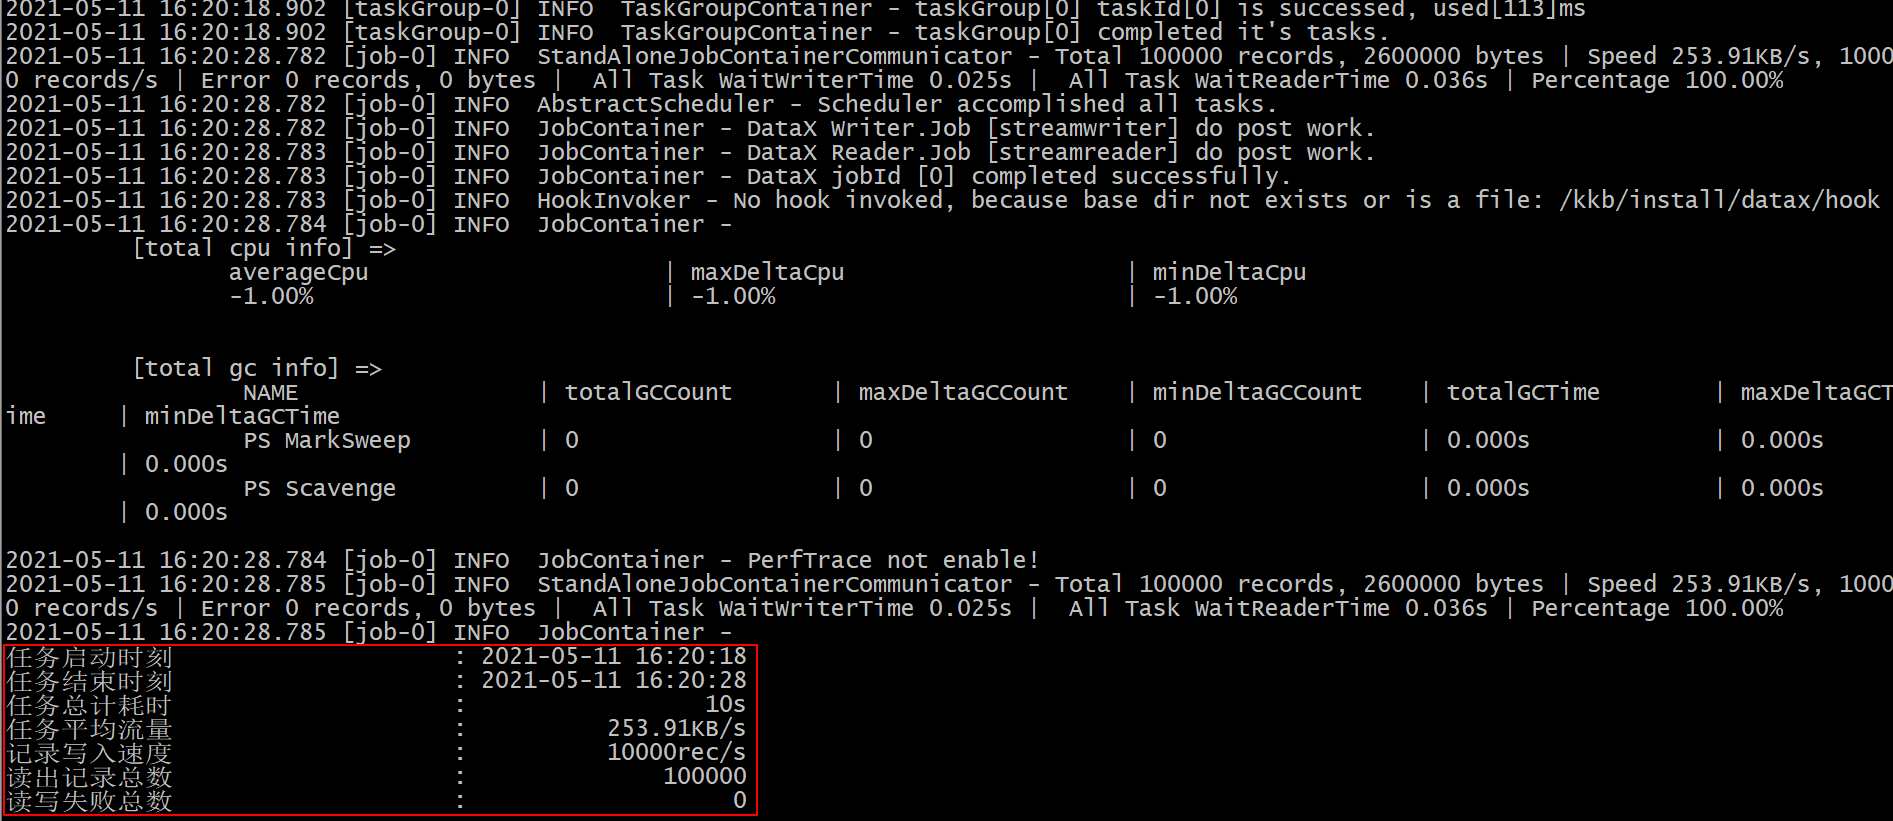
6、DataX 实战案例
6.1 从stream流读取数据并打印到控制台
-
需求:使用datax实现读取字符串,然后打印到控制台。
-
1、创建作业的配置文件(json格式)
-
可以通过命令查看配置模板:
python datax.py -r {YOUR_READER} -w {YOUR_WRITER} -
查看配置模板,执行脚本命令
[hadoop@node01 datax]$ cd /kkb/install/datax [hadoop@node01 datax]$ python bin/datax.py -r streamreader -w streamwriter ##查看输出结果 DataX (DATAX-OPENSOURCE-3.0), From Alibaba ! Copyright (C) 2010-2017, Alibaba Group. All Rights Reserved. Please refer to the streamreader document: https://github.com/alibaba/DataX/blob/master/streamreader/doc/streamreader.md Please refer to the streamwriter document: https://github.com/alibaba/DataX/blob/master/streamwriter/doc/streamwriter.md Please save the following configuration as a json file and use python {DATAX_HOME}/bin/datax.py {JSON_FILE_NAME}.json to run the job. { "job": { "content": [ { "reader": { "name": "streamreader", "parameter": { "column": [], "sliceRecordCount": "" } }, "writer": { "name": "streamwriter", "parameter": { "encoding": "", "print": true } } } ], "setting": { "speed": { "channel": "" } } } } -
-
2、根据模板写配置文件
- 进入到
/kkb/install/datax/job目录,然后创建配置文件stream2stream.json, 文件内容如下:
{ "job": { "content": [ { "reader": { "name": "streamreader", "parameter": { "sliceRecordCount": 10, "column": [ { "type": "long", "value": "10" }, { "type": "string", "value": "hello,你好,世界-DataX" } ] } }, "writer": { "name": "streamwriter", "parameter": { "encoding": "UTF-8", "print": true } } } ], "setting": { "speed": { "channel": 5, "bytes":0 }, "errorLimit": { "record": 10, "percentage": 0.02 } } } }-
其中
sliceRecordCount表示每个channel生成数据的条数。 -
speed表示限速 -
channel表示任务并发数。 -
bytes表示每秒字节数,默认为0(不限速)。 -
errorLimit表示错误控制 -
record: 出错记录数超过record设置的条数时,任务标记为失败. -
percentage: 当出错记录数超过percentage百分数时,任务标记为失败.
- 进入到
-
3、动DataX
[hadoop@node01 bin]$ cd /kkb/install/datax [hadoop@node01 bin]$ python bin/datax.py job/stream2stream.json -
4、观察控制台输出结果
同步结束,显示日志如下:

10      hello,你好,世界-DataX
10      hello,你好,世界-DataX
10      hello,你好,世界-DataX
10      hello,你好,世界-DataX
10      hello,你好,世界-DataX
10      hello,你好,世界-DataX

...
2021-05-11 16:52:39.274 [job-0] INFO  JobContainer -
任务启动时刻                    : 2021-05-11 16:52:29
任务结束时刻                    : 2021-05-11 16:52:39
任务总计耗时                    :                 10s
任务平均流量                    :               95B/s
记录写入速度                    :              5rec/s
读出记录总数                    :                  50
读写失败总数                    :                   0
6.2 从mysql表读取数据并打印到控制台
-
需求:使用datax实现读取mysql一张表指定字段的数据,打印到控制台
-
1、在mysql数据库中创建student表,并且加载数据到表中
mysql> create database datax; mysql> use datax; mysql> create table student(id int,name varchar(20),age int,createtime timestamp ); mysql> insert into <code>student(id,name,age,createtime) values('1','zhangsan','18','2021-05-10 18:10:00'); mysql> insert intostudent(id,name,age,createtime) values('2','lisi','28','2021-05-10 19:10:00'); mysql> insert intostudent(id,name,age,createtime) values('3','wangwu','38','2021-05-10 20:10:00'); -
2、创建作业的配置文件(json格式)
- 执行脚本命令(查看配置模板)
[hadoop@node01 datax]$ cd /kkb/install/datax [hadoop@node01 datax]$ python bin/datax.py -r mysqlreader -w streamwriter DataX (DATAX-OPENSOURCE-3.0), From Alibaba ! Copyright (C) 2010-2017, Alibaba Group. All Rights Reserved. Please refer to the mysqlreader document: https://github.com/alibaba/DataX/blob/master/mysqlreader/doc/mysqlreader.md Please refer to the streamwriter document: https://github.com/alibaba/DataX/blob/master/streamwriter/doc/streamwriter.md Please save the following configuration as a json file and use python {DATAX_HOME}/bin/datax.py {JSON_FILE_NAME}.json to run the job. { "job": { "content": [ { "reader": { "name": "mysqlreader", "parameter": { "column": [], "connection": [ { "jdbcUrl": [], "table": [] } ], "password": "", "username": "", "where": "" } }, "writer": { "name": "streamwriter", "parameter": { "encoding": "", "print": true } } } ], "setting": { "speed": { "channel": "" } } } }-
其中
mysqlreader插件文档 -
https://github.com/alibaba/DataX/blob/master/mysqlreader/doc/mysqlreader.md
-
3、根据模板写配置文件
- 进入到
/kkb/install/datax/job目录,然后创建配置文件mysql2stream.json, 文件内容如下:
{ "job": { "setting": { "speed": { "channel": 3 }, "errorLimit": { "record": 0, "percentage": 0.02 } }, "content": [ { "reader": { "name": "mysqlreader", "parameter": { "username": "root", "password": "123456", "column": [ "id", "name", "age", "createtime" ], "connection": [ { "table": [ "student" ], "jdbcUrl": [ "jdbc:mysql://node03:3306/datax" ] } ] } }, "writer": { "name": "streamwriter", "parameter": { "print":true } } } ] } } - 进入到
-
4、启动DataX
[hadoop@node01 bin]$ cd /kkb/install/datax [hadoop@node01 bin]$ python bin/datax.py job/mysql2stream.json -
5、观察控制台输出结果
同步结束,显示日志如下:

1       zhangsan        18      2021-05-10 18:10:00
2       lisi    28      2021-05-10 19:10:00
3       wangwu  38      2021-05-10 20:10:00

...
2021-05-11 17:31:29.904 [job-0] INFO  JobContainer -
任务启动时刻                    : 2021-05-11 17:31:19
任务结束时刻                    : 2021-05-11 17:31:29
任务总计耗时                    :                 10s
任务平均流量                    :                2B/s
记录写入速度                    :              0rec/s
读出记录总数                    :                   3
读写失败总数                    :                   0
6.3 从mysql表读取增量数据并打印到控制台
-
需求:使用datax实现mysql表增量数据同步打印到控制台。
-
1、创建作业的配置文件
- 进入到
/kkb/install/datax/job目录,然后创建配置文件mysqlAdd2stream.json, 文件内容如下:
{ "job": { "setting": { "speed": { "channel": 3 }, "errorLimit": { "record": 10, "percentage": 0.02 } }, "content": [ { "reader": { "name": "mysqlreader", "parameter": { "username": "root", "password": "123456", "column": [ "id", "name", "age", "createtime" ], "where":"createtime > '${start_time}' and createtime < '${end_time}'", "connection": [ { "table": [ "student" ], "jdbcUrl": [ "jdbc:mysql://node03:3306/datax" ] } ] } }, "writer": { "name": "streamwriter", "parameter": { "print":true } } } ] } } - 进入到
-
2、向
student表中插入一条数据mysql> insert into <code>student(id,name,age,createtime) values('4','xiaoming','48','2021-05-11 19:10:00') -
3、启动DataX
[hadoop@node01 bin]$ cd /kkb/install/datax [hadoop@node01 bin]$ python bin/datax.py job/mysqlAdd2stream.json -p "-Dstart_time='2021-05-11 00:00:00' -Dend_time='2021-05-11 23:59:59'" -
4、观察控制台输出结果
同步结束,显示日志如下:
...
INFO  CommonRdbmsReader$Task - Finished read record by Sql: [select id,name,age,createtime from student where (createtime > '2021-05-11 00:00:00' and createtime < '2021-05-11 23:59:59')

4       xiaoming        48      2021-05-11 19:10:00

...
2021-05-11 18:37:35.755 [job-0] INFO  JobContainer -
任务启动时刻                    : 2021-05-11 18:37:25
任务结束时刻                    : 2021-05-11 18:37:35
任务总计耗时                    :                 10s
任务平均流量                    :                1B/s
记录写入速度                    :              0rec/s
读出记录总数                    :                   1
读写失败总数                    :                   0
6.4 使用datax实现mysql2mysql
-
需求:使用datax实现将数据从mysql当中读取,并且通过sql语句实现数据的过滤,并且将数据写入到mysql另外一张表当中去。
-
1、创建作业的配置文件(json格式)
- 查看配置模板,执行脚本命令
[hadoop@node01 datax]$ cd /kkb/install/datax [hadoop@node01 datax]$ python bin/datax.py -r mysqlreader -w mysqlwriter DataX (DATAX-OPENSOURCE-3.0), From Alibaba ! Copyright (C) 2010-2017, Alibaba Group. All Rights Reserved. Please refer to the mysqlreader document: https://github.com/alibaba/DataX/blob/master/mysqlreader/doc/mysqlreader.md Please refer to the mysqlwriter document: https://github.com/alibaba/DataX/blob/master/mysqlwriter/doc/mysqlwriter.md Please save the following configuration as a json file and use python {DATAX_HOME}/bin/datax.py {JSON_FILE_NAME}.json to run the job. { "job": { "content": [ { "reader": { "name": "mysqlreader", "parameter": { "column": [], "connection": [ { "jdbcUrl": [], "table": [] } ], "password": "", "username": "", "where": "" } }, "writer": { "name": "mysqlwriter", "parameter": { "column": [], "connection": [ { "jdbcUrl": "", "table": [] } ], "password": "", "preSql": [], "session": [], "username": "", "writeMode": "" } } } ], "setting": { "speed": { "channel": "" } } } }-
其中
mysqlwriter插件文档 -
https://github.com/alibaba/DataX/blob/master/mysqlwriter/doc/mysqlwriter.md
-
2、根据模板写配置文件
- 进入到
/kkb/install/datax/job目录,然后创建配置文件mysql2mysql.json, 文件内容如下:
{ "job": { "setting": { "speed": { "channel":1 } }, "content": [ { "reader": { "name": "mysqlreader", "parameter": { "username": "root", "password": "123456", "connection": [ { "querySql": [ "select id,name,age,createtime from student where age < 30;" ], "jdbcUrl": [ "jdbc:mysql://node03:3306/datax" ] } ] } }, "writer": { "name": "mysqlwriter", "parameter": { "writeMode": "insert", "username": "root", "password": "123456", "column": [ "id", "name", "age", "createtime" ], "preSql": [ "delete from person" ], "connection": [ { "jdbcUrl": "jdbc:mysql://node03:3306/datax?useUnicode=true&characterEncoding=utf-8", "table": [ "person" ] } ] } } } ] } } - 进入到
-
3、创建目标表
mysql> create table datax.person(id int,name varchar(20),age int,createtime timestamp ); -
4、启动DataX
[hadoop@node01 bin]$ cd /kkb/install/datax [hadoop@node01 bin]$ python bin/datax.py job/mysql2mysql.json -
5、观察控制台输出结果
同步结束,显示日志如下: 2021-05-12 11:17:24.390 [job-0] INFO JobContainer - 任务启动时刻 : 2021-05-12 11:17:13 任务结束时刻 : 2021-05-12 11:17:24 任务总计耗时 : 10s 任务平均流量 : 3B/s 记录写入速度 : 0rec/s 读出记录总数 : 2 读写失败总数 : 0 -
6、查看person表数据

6.5 使用datax实现将mysql数据导入到hdfs
-
需求: 将mysql表
student的数据导入到hdfs的/datax/mysql2hdfs/路径下面去。 -
1、创建作业的配置文件(json格式)
- 执行脚本命令查看配置模板
[hadoop@node01 datax]$ cd /kkb/install/datax [hadoop@node01 datax]$ python bin/datax.py -r mysqlreader -w hdfswriter DataX (DATAX-OPENSOURCE-3.0), From Alibaba ! Copyright (C) 2010-2017, Alibaba Group. All Rights Reserved. Please refer to the mysqlreader document: https://github.com/alibaba/DataX/blob/master/mysqlreader/doc/mysqlreader.md Please refer to the hdfswriter document: https://github.com/alibaba/DataX/blob/master/hdfswriter/doc/hdfswriter.md Please save the following configuration as a json file and use python {DATAX_HOME}/bin/datax.py {JSON_FILE_NAME}.json to run the job. { "job": { "content": [ { "reader": { "name": "mysqlreader", "parameter": { "column": [], "connection": [ { "jdbcUrl": [], "table": [] } ], "password": "", "username": "", "where": "" } }, "writer": { "name": "hdfswriter", "parameter": { "column": [], "compress": "", "defaultFS": "", "fieldDelimiter": "", "fileName": "", "fileType": "", "path": "", "writeMode": "" } } } ], "setting": { "speed": { "channel": "" } } } } -
2、根据模板写配置文件
- 进入到
/kkb/install/datax/job目录,然后创建配置文件mysql2hdfs.json, 文件内容如下:
{ "job": { "setting": { "speed": { "channel":1 } }, "content": [ { "reader": { "name": "mysqlreader", "parameter": { "username": "root", "password": "123456", "connection": [ { "querySql": [ "select id,name,age,createtime from student where age < 30;" ], "jdbcUrl": [ "jdbc:mysql://node03:3306/datax" ] } ] } }, "writer": { "name": "hdfswriter", "parameter": { "defaultFS": "hdfs://node01:8020", "fileType": "text", "path": "/datax/mysql2hdfs/", "fileName": "student.txt", "column": [ { "name": "id", "type": "INT" }, { "name": "name", "type": "STRING" }, { "name": "age", "type": "INT" }, { "name": "createtime", "type": "TIMESTAMP" } ], "writeMode": "append", "fieldDelimiter": "\t", "compress":"gzip" } } } ] } } - 进入到
-
3、启HDFS, 创建目标路径
[hadoop@node01 ~]$ start-dfs.sh [hadoop@node01 ~]$ hdfs dfs -mkdir -p /datax/mysql2hdfs -
4、启动DataX
[hadoop@node01 bin]$ cd /kkb/install/datax [hadoop@node01 bin]$ python bin/datax.py job/mysql2hdfs.json -
5、观察控制台输出结果
同步结束,显示日志如下: 2021-05-12 11:32:26.452 [job-0] INFO JobContainer - 任务启动时刻 : 2021-05-12 11:32:14 任务结束时刻 : 2021-05-12 11:32:26 任务总计耗时 : 11s 任务平均流量 : 3B/s 记录写入速度 : 0rec/s 读出记录总数 : 2 读写失败总数 : 0 -
6、查看HDFS上文件生成
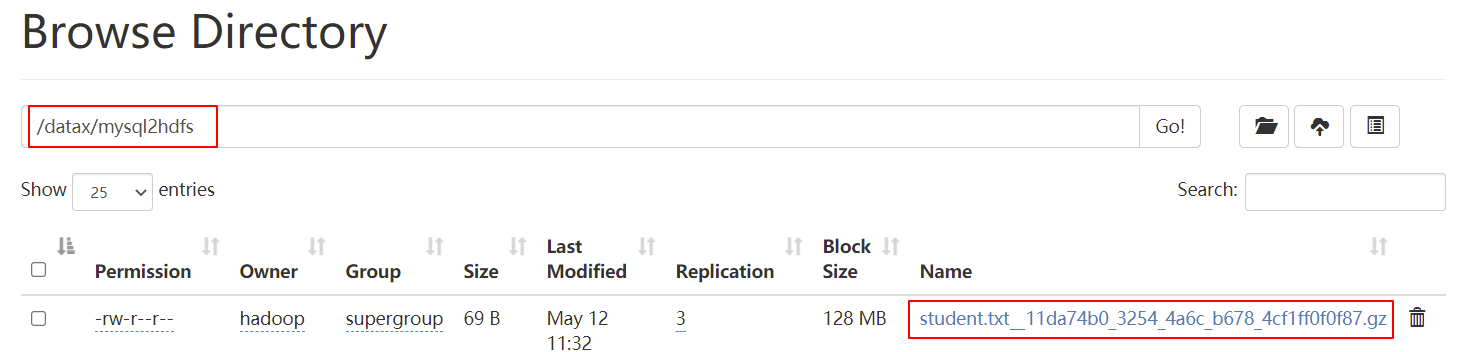
6.6 使用datax实现将hdfs数据导入到mysql表中
-
需求: 将hdfs上数据文件
user.txt导入到mysql数据库的user表中。 -
1、创建作业的配置文件(json格式)
- 查看配置模板,执行脚本命令
[hadoop@node01 datax]$ cd /kkb/install/datax [hadoop@node01 datax]$ python bin/datax.py -r hdfsreader -w mysqlwriter DataX (DATAX-OPENSOURCE-3.0), From Alibaba ! Copyright (C) 2010-2017, Alibaba Group. All Rights Reserved. Please refer to the hdfsreader document: https://github.com/alibaba/DataX/blob/master/hdfsreader/doc/hdfsreader.md Please refer to the mysqlwriter document: https://github.com/alibaba/DataX/blob/master/mysqlwriter/doc/mysqlwriter.md Please save the following configuration as a json file and use python {DATAX_HOME}/bin/datax.py {JSON_FILE_NAME}.json to run the job. { "job": { "content": [ { "reader": { "name": "hdfsreader", "parameter": { "column": [], "defaultFS": "", "encoding": "UTF-8", "fieldDelimiter": ",", "fileType": "orc", "path": "" } }, "writer": { "name": "mysqlwriter", "parameter": { "column": [], "connection": [ { "jdbcUrl": "", "table": [] } ], "password": "", "preSql": [], "session": [], "username": "", "writeMode": "" } } } ], "setting": { "speed": { "channel": "" } } } } -
2、根据模板写配置文件
- 进入到
/kkb/install/datax/job目录,然后创建配置文件hdfs2mysql.json, 文件内容如下:
{ "job": { "setting": { "speed": { "channel":1 } }, "content": [ { "reader": { "name": "hdfsreader", "parameter": { "defaultFS": "hdfs://node01:8020", "path": "/user.txt", "fileType": "text", "encoding": "UTF-8", "fieldDelimiter": "\t", "column": [ { "index": 0, "type": "long" }, { "index": 1, "type": "string" }, { "index": 2, "type": "long" } ] } }, "writer": { "name": "mysqlwriter", "parameter": { "writeMode": "insert", "username": "root", "password": "123456", "column": [ "id", "name", "age" ], "preSql": [ "delete from user" ], "connection": [ { "jdbcUrl": "jdbc:mysql://node03:3306/datax?useUnicode=true&characterEncoding=utf-8", "table": [ "user" ] } ] } } } ] } } - 进入到
-
3、准备HDFS上测试数据文件
user.txt- user.txt文件内容如下
1 zhangsan 20 2 lisi 29 3 wangwu 25 4 zhaoliu 35 5 kobe 40- 文件中每列字段通过
\t制表符进行分割,上传文件到hdfs上
[hadoop@node01 ~]$ hdfs dfs -put user.txt / -
4、创建目标表
mysql> create table datax.user(id int,name varchar(20),age int); -
5、启动DataX
[hadoop@node01 bin]$ cd /kkb/install/datax [hadoop@node01 bin]$ python bin/datax.py job/hdfs2mysql.json -
6、观察控制台输出结果
同步结束,显示日志如下: 任务启动时刻 : 2021-05-12 12:02:47 任务结束时刻 : 2021-05-12 12:02:58 任务总计耗时 : 11s 任务平均流量 : 4B/s 记录写入速度 : 0rec/s 读出记录总数 : 5 读写失败总数 : 0 -
7、查看
user表数据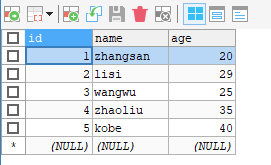
6.7 使用datax实现将mysql数据同步到hive表中
-
需求 :使用datax将mysql中的
user表数据全部同步到hive表中 -
1、创建一张hive表
- 启动hiveserver2
[hadoop@node03 hive]$ hiveserver2- 通过beeline连接hiveserver2
[hadoop@node03 hive]$ beeline beeline> !connect jdbc:hive2://node03:10000- 创建数据库和表
0: jdbc:hive2://node03:10000> create database datax; 0: jdbc:hive2://node03:10000> use datax; 0: jdbc:hive2://node03:10000> create external table t_user(id int,name string,age int) row format delimited fields terminated by '\t'; -
2、编写配置文件
- 进入到
/kkb/install/datax/job目录,然后创建配置文件mysql2hive.json, 文件内容如下:
{ "job": { "setting": { "speed": { "channel":1 } }, "content": [ { "reader": { "name": "mysqlreader", "parameter": { "username": "root", "password": "123456", "connection": [ { "jdbcUrl": [ "jdbc:mysql://node03:3306/datax" ], "table": [ "user" ] } ], "column": [ "id", "name", "age" ] } }, "writer": { "name": "hdfswriter", "parameter": { "defaultFS": "hdfs://node01:8020", "fileType": "text", "path": "/user/hive/warehouse/datax.db/t_user", "fileName": "user.txt", "column": [ { "name": "id", "type": "INT" }, { "name": "name", "type": "STRING" }, { "name": "age", "type": "INT" } ], "writeMode": "append", "fieldDelimiter": "\t", "compress":"gzip" } } } ] } } - 进入到
-
3、启动DataX
[hadoop@node01 bin]$ cd /kkb/install/datax [hadoop@node01 bin]$ python bin/datax.py job/mysql2hive.json -
4、观察控制台输出结果
同步结束,显示日志如下: 2021-05-12 12:20:31.080 [job-0] INFO JobContainer - 任务启动时刻 : 2021-05-12 12:20:19 任务结束时刻 : 2021-05-12 12:20:31 任务总计耗时 : 11s 任务平均流量 : 4B/s 记录写入速度 : 0rec/s 读出记录总数 : 5 读写失败总数 : 0 -
5、查看hive中
t_user表数据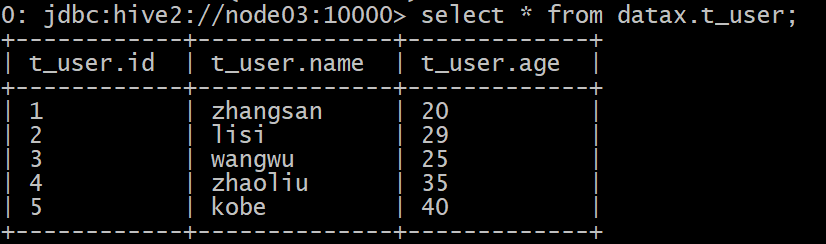
Views: 139