学术界和产业界同月交卷:AI 原生 SDLC 的两个答案,撞出了同一个结论

今年八月,软件工程领域有两份重要文件先后落地,一份来自学术圈,一份来自产业界,彼此没有互相引用,却几乎在同一时间给出了同一个诊断。

一份是 8 月初挂上 arXiv 的技术报告《SDAD: Spec-Driven Agentic Development for the AI-Native SDLC》(arXiv:2608.20341),我上周写过一篇精读。另一份是 8 月 21 日 Anthropic 官方博客发布的《The AI-Native SDLC Playbook》,出自 Applied AI 团队的 Louis Claxton 之手,篇幅 46 分钟阅读量,副标题直白得很:如何一个阶段一个阶段地改造你的软件开发生命周期。

我把两份都读完了,越读越觉得这件事值得单独写一篇——不是因为它们观点相近,而是因为论证路径完全不同的两份文件,从两端撞出了同一个结构性结论。这种收敛本身就是信号。

planning

同一个诊断:瓶颈从写代码,移到了写代码的两侧

SDAD 论文的表述是:当智能体能吞下整仓库和完整需求文档,「写代码」不再稀缺,「把意图写清楚」成为新瓶颈,所以生命周期要围绕规约重组。

Anthropic 手册的开篇标题就叫 "Code is no longer the bottleneck",然后给出了更具体的版图:Build 塌缩到小时级,但左右两侧的 Plan、Review、Test、Deploy 还在以人类速度运转;逐行 review 在人类写代码的时代是合理的控制手段,智能体写掉大部分 diff 之后就跟不上了;治理成本不降反升,异常处理还在走人工委员会。

诊断一致,开出的药方也同构。

处方同构:一根「工件链」,两种表述

SDAD 的核心资产是形式化规约:意图记录 → 机器可读蓝图 → 智能体合成 → 独立验证,人类上游化为 Spec Architect(规约架构师)。

Anthropic 的做法是把这句话落成了具体的文件名。每个阶段以提交一个版本化工件结束、以下一阶段读取它开始:

intent.md → spec.md → plan.md → diff + tests → review findings → incident record

intent.md 记录要解决的问题和约束,产品负责人签发;spec.md 由智能体根据组织级 skills(品牌、安全、合规、UX 政策全部写成技能文件)生成,产品负责人审核但不执笔;plan.md 拆解成有依赖关系的步骤清单;最后到 diff、测试、评审发现、事故记录,每个工件都进版本控制。

手册里有一句很硬的话:这条工件链本身就是审计轨迹。哪个阶段、哪个人、用哪个版本的技能文件批准了什么,git 时间戳全部记得清清楚楚。

再对照角色:SDAD 说工程师要变成「写规约的人」,Anthropic 说产品负责人写 intent.md 和审核 spec.md、技术负责人写 REVIEW.md 和设人工阈值、平台工程师管理技能文件和 hook——双方都在把人类从实现层抽走,钉在门禁上

三处细节,看出手册比论文更「带血」

论文给框架,手册给的是踩过坑之后的工程细节。三处值得单独说。

第一处:配置也要做回归测试。

CLAUDE.md、skills、hooks 这些「智能体的配置」,一有改动 CI 就自动跑一套真实任务的 eval 套件,通过率跌了就不许合并。思路是把给智能体的配置当成代码对待——配置会过时(模型一升级,旧的判别用例就失效了),所以 eval 必须是活的套件,持续从生产监控里补新 case。甚至规定每出一次生产事故,处理团队要把它写成一条永久 eval。事故不是复盘完就翻篇,而是变成回归测试资产。

第二处:组织级学习闭环。

review 发现同类错误第二次出现,修正直接写进 CLAUDE.md——因为评审也读这个文件,下个 PR 开始这个错误就会被自动拦截。错误处理从「人长了记性」变成「组织长了记性」,而且这个记性是版本控制的。

第三处:看门狗刻意不用模型。

Stage 6 的生产监控,检测脚本完全确定性——滚动窗口统计,一个模型都不调用。分级响应写在配置文件里:轻度偏离只记日志;中度偏离 Claude 以只读身份进场诊断;重度偏离才允许行动,而且行动路线只有白名单——开一个进评审门禁的 PR,或者触发一个预先批准过的 runbook。

为什么检测层要刻意「笨」?手册没明说,但答案很明显:确定性脚本不会幻觉、不会漏报、行为可复现。该笨的地方笨,该聪明的地方聪明——这是把 AI 用在刀刃上的克制。

门禁哲学:两个文本,同一句话

SDAD 论文的结尾是:智能体的速度不会消灭工程纪律,它只是把纪律上游化——转移到规约的精确性、显式的门禁和可审计的溯源里。

Anthropic 手册的收尾是:The loop keeps running. Human judgement stays above it.(循环不停,人类判断悬于其上。)

展开看手册对「门禁」的执行强度:生产部署 hook 在指定发布经理授权前硬阻塞;agent 每次无交互运行用独立身份,流水线日志里「智能体干的」和「工程师触发的」分得清清楚楚;rollback 要求是在 staging 定期演练过的最熟练路径——理由是闭环运行时真的会调用它,必须提前验证过。

手册里还有个细节颇有些微妙的坦白:Stage 5 提到 review 发现本身不批准也不阻塞 PR,分支保护仍然只认 code owner 的批准——但平台工程师如果想在发现数量上设门槛,check run 会输出机器可读的严重度计数。措辞谨慎,留了口子,但方向已经很清楚:人类审批是唯一硬门禁,其他一切是软信号。

差异与短板

两份文件的差异也很清楚。SDAD 停在理论框架和经济学估算——那张 99% 成本塌缩的表数字大胆但来路是作者自估;Anthropic 给的是可执行清单,每个打法都配了能直接从 git 时间戳和 PR metadata 取数的度量指标。

但手册也不是没有盲区。全篇假设读者已经在 Claude Code 生态里,工件链绑定的是 intent.md 这些 Anthropic 格式;46 分钟的篇幅里,对「工件本身过期怎么办」着墨很少——1000 页规约账本和演进了的现实系统之间的一致性,SDAD 论文里那个语焉不详的「规约考古学」问题,在手册里同样没有答案。

为什么说收敛本身是信号

方法论文写作里有个规律:当一个问题真正成熟时,不同出发点的解会趋同。

这一次,学术报告和厂商手册从两端撞出同一句话:代码生成不再是竞争壁垒,工件链和门禁设计的质量才是。

对做智能体开发的人,这两份文件建议都读,顺序无所谓:论文给骨架,手册给肌肉。对准备动手改造团队流程的管理者,直接从手册抄作业,但记住它的隐含前提——你得先把组织政策写成机器可读的技能文件,这一步没有捷径,而且这一步恰好就是 SDAD 说的「新瓶颈」。

钟摆从敏捷摆向规约,这次是学术和产业一起按的手。


参考:

Views: 0

写代码不再是瓶颈:一篇 2026 年新论文如何重画软件开发的生命周期

月初在 arXiv 上刷到一篇技术报告,读完后我在工位上愣了几秒钟——它把我这半年做智能体开发时隐约感到、但一直说不清楚的东西,第一次讲明白了。

论文标题是《SDAD: Spec-Driven Agentic Development for the AI-Native SDLC》(arXiv:2608.20341),2026 年 5 月提交,8 月正式公开。作者名气不大,报告性质、未经同行评审,按理说不值得这么激动。但它干了一件近年来 software engineering 领域很少有人认真做的事:把"AI 智能体到底会怎样重塑软件开发流程"从twitter吐槽和发布会 PPT,拉回到方法论层面严肃讨论。

先说结论:这篇论文的核心主张一句话就能讲完——

当 AI 能一口气读完你的整个代码仓库和需求文档,"写代码"就不再是瓶颈,"把需求写清楚"才是。软件开发的生命周期,将围绕"规约"(Specification)重新组织。

但真正有意思的是它的论证过程。下面挑几个我认为最值得展开的点细说。

code

方法论的钟摆:我们绕了一大圈

论文开篇做了一个历史回顾,视角很刁:把软件方法论七十年的演进读成一个钟摆,在"刚性"和"柔性"两个极点之间摇晃。

1970 到 1990 年代是确定性时代。Royce 提出瀑布模型,RUP 把它体系化,核心信仰是:重文档、重评审、阶段门禁。有意思的是作者考据指出,Royce 本人的原始论文其实强调阶段间反馈和原型验证,比教科书上那条"纯线性瀑布"要灵活得多——是我们把他的图简化成了漫画,然后骂了五十年。

2001 年敏捷宣言接棒,"可工作的软件高于详尽的文档"成为新圣经。Scrum 用两周冲刺把反馈周期从月压缩到周。这个转向在当时完全正确,因为人类把模糊意图翻译成代码的速度太慢了,慢到详尽的前期设计在实现完成前就已经过期。

论文的转折点论证在这里:2025 到 2026 年,前沿模型跨过了一个门槛——上下文窗口从十万 token 进入百万级,智能体可以单次推理吞下整仓库加完整 FRD(功能需求文档),并自主完成跨模块的多文件实现。实证研究记录了 3 到 5 倍的交付速度提升。

问题来了:当"实现"这个环节的耗时趋近于零,之前所有为了弥补"实现慢"而设计的方法论,还成立吗?

作者的答案:敏捷的"轻文档"本质是一种补偿机制,补偿的是人类实现的速度上限。当实现不再稀缺,文档就不再是官僚负担,而是执行的燃料。规约写得越精确,智能体产出越快、越准。

于是钟摆回摆——但不是回到 1970,而是螺旋上升到一个新平衡点:形式化规约 + 智能体高速执行。这就是 SDAD(Spec-Driven Agentic Development,规约驱动的智能体开发)。

模糊性税:需求写得烂,是要交税的

这是全文我最喜欢的概念,因为它把一件工程师们感同身受但从未量化过的事情,变成了一个数学模型。

论文定义:规约清晰度 C 与智能体幻觉概率 H(C) 之间,近似满足指数关系——

H(C) ≈ α·e^(−βC)

清晰度越低,幻觉率不是线性上升,而是指数爆炸。论文配图中划了一条 70% 清晰度的"安全线",线以下就是"高幻觉区"。

更狠的是"爆炸半径"这个观察:人类时代一个含糊需求,最多害一个模块;智能体时代一句模糊的需求描述,可能在几分钟内被复制传播到几十个文件里,产生系统性的不一致修改。上下文窗口越大,破坏力越强。

由此引出一条我非常认同的工程直觉,论文称之为"智能体线性主义"(Agentic Linearism):面对一份完整且无歧义的规约,智能体管线以单次不间断的合成通过方式执行时效率最高。中途打断、部分规约、合成途中改需求,都会造成上下文碎片化,输出质量断崖式下跌。

看到这段我笑了。"需求冻结"——这个被敏捷主义者嘲笑二十年的瀑布遗物,居然以"技术优化"的名义复活了。不是官僚惯性,是为了给智能体一个干净的执行上下文。

AI-Code 是第四种生产范式

论文提出了一个分类框架:软件生产历史上出现过三种范式——Pro-code(专业者手写)、Low-code(低代码平台)、No-code(无代码工具),它们区分的本质是"谁写代码、技能门槛多高"。

而 AI-code 完全改变了提问方式。无论你通过 IDE、低代码平台还是无代码工具调用智能体,产出的都是 AI-code——三种入口,同一种产物,同一套治理风险。

AI-code 有三个结构性特征:

第一,作者与责任解耦。生成代码的模型无法被问责,责任只能回溯到下达提示词或批准合并的人类——而大多数组织还没定义这个角色。

第二,表达力与技能脱钩。不会编程的业务人员现在也能生成生产级后端逻辑,No-code 的质量天花板消失了,治理风险的天花板则抬升到了 Pro-code 级别。

第三,范式隐匿合流。以前三种范式产出物不同,IT 部门可以分类审计;现在 AI-code 可以从任何入口产出任何制品,没有生成层的溯源工具就无法审计。

由此,治理的核心问题从"这是谁写的"变成"这是谁规约的、谁评审的、谁批准合并的"。

Spec Architect:软件工程师的新身份

如果代码不再由人写,工程师做什么?论文给出的新角色叫 Spec Architect(规约架构师),要求四种能力:

  • 领域流畅度:深刻理解业务逻辑和系统约束
  • 形式化方法素养:把需求表达为机器可解释的结构(YAML 逻辑、结构化模板)
  • 智能体编排能力:设计多智能体管线——验证智能体、安全审查智能体、回归测试智能体
  • 对抗性推理:预判智能体的失败模式(幻觉、规约漏洞利用),写出对它们免疫的规约

注意第四条,这是最有洞察的一条。以前我们防的是需求理解偏差,现在要防的是"智能体对规约的字面主义利用"——你说"实现登录功能"但没说密码错误几次锁定,智能体就真的不做锁定。写规约变成了一种对抗性博弈。

整个团队都在变形:QA 从写测试用例转向定义评估策略(行为预言、覆盖率契约、回滚标准);SRE 从跑运维手册转向建设自治控制层(权限边界、智能体行为观测、人类回滚权);产品经理从写 backlog 转向前置意图精确化——因为智能体会按你写的字面意思执行,歧义不再能在站会上口头澄清。

那张让 CFO 眼睛发亮的表

论文第 11 章给了个示例经济账,比较传统敏捷团队和 SDAD 模式交付同一个复杂模块(规约账本约 1000 页规模)。数字是作者自己的示意性估算,不是审计数据,看个量级:

指标 Human-Agile (2020) Agentic SDAD (2026)
人力投入 480 人时 4 架构师小时
日历时间 4 周(约 2 个冲刺) 15 分钟合成
交付人力成本 ~$48,000 ~$400
Token 计算 ~$0.20
总实施成本 TCI ~$60,000 ~$600

99% 的成本塌缩。当然要打折扣看——规约本身的撰写成本、验证基础设施、治理开销都被简化了。但趋势方向是对的:当交付的边际成本塌向推理费用,稀缺资源就从"实现人力"迁移到"逻辑清晰度"和"门禁设计"

配套的量化指标体系也值得记录:TCI 公式引入了迭代乘数 φ(返工倍数),模糊规约通过放大 φ 让成本超线性增长;SER(合成效率比)= 规约的逻辑密度 / 消耗的总 token 数,作为规约架构师的核心 KPI;AAR(智能体自治率)衡量合并代码中智能体生成的占比,高自治 regime 的示意目标超过 95%。

还有一个新概念叫"认知债"(cognitive debt):仓库里那些行为正确、测试通过、但已经没有任何人类能安全修改的智能体生成代码——必须从规约和测试反推意图才敢动。这是技术债在 AI 时代的变体,而且更隐蔽。

冷静的部分:这篇论文不能照单全收

例行泼几盆冷水。

这是 technical report,未经同行评审,引用的自我循环倾向明显。那个漂亮的 H(C) 指数模型只是"与经验数据一致"的曲线拟合,α、β 的具体数值没有严格估计;3-5 倍加速来自单一研究,作者自己也承认是"方向性证据而非普适因果保证"。第 11 章那张 99% 成本塌缩表,数字标注的是"作者自己的观察性估计"——这在我读过的论文里算是相当大胆的表述方式。

另外,spec-driven development 并非这篇论文首创。2025 年以来 GitHub 的 Spec Kit、AWS 的 Kiro 都在实践这条路,社区对 vibe coding 的反弹更是推波助澜。这篇论文的贡献不是发明,而是系统化的理论包装:钟摆叙事、四范式分类、量化治理指标、四阶段迁移蓝图(评估→试点→混合→SDAD 优先,进展靠门禁赚取而非排期),这个综合框架确实是目前看到的最完整版本。

还有个论文没有充分展开的问题:规约本身会不会变成新的技术债?1000 页的规约账本,谁来维护它与演进了的现实系统之间的一致性?论文提到了"规约考古学"(Specification Archaeology)工具的必要性,但语焉不详。

为什么值得一读

抛开具体框架不谈,这篇论文最有价值的是它把一个正在发生但很少被正面直视的转变讲透了:

过去二十年,软件工程的最佳实践围绕"如何弥补人类实现的局限"展开——小步迭代、口头澄清、恰好够用的文档。接下来十年,最佳实践将围绕"如何榨取机器实现的潜力"展开——前置的精确、机器可读的规约、独立的验证、人类保留的签发权。

论文结尾那句话我抄给了几个朋友:智能体的速度不会消灭工程纪律,它只是把纪律上游化——转移到规约的精确性、显式的门禁和可审计的溯源里。

对做智能体开发的人,这是必读级的方法论镜子;对教软件工程的人,这是 2026 年视角下绝佳的教案素材;对管理者,第 11 章的经济账虽然粗糙,但预算从"交付人头"转向"前沿模型配额 + 治理工具 + 少量规约架构师"的方向判断,值得认真对待。

钟摆还在晃。但这次它停下的位置,看起来跟以往任何一次都不一样。


论文地址:arXiv:2608.20341(CC BY-SA 4.0)

Views: 2

“把 AI 编程的“飞船”换成皮划艇:pi 极简编码智能体实测”

起因:听说有个工具省 token 省得很邪门

前几天听人说,有个叫 pi 的编码智能体,省 token 省得离谱。我心想又是营销号吧,结果动手一搜——搜不出来。搜 "pi" 出来的是圆周率、是树莓派、是某品牌的手机,唯独搜不到这个工具。

后来才知道,作者是故意的。Mario Zechner——写 libGDX 那位,Java 游戏开发圈的传奇——给自己的新项目起了个"完全没法被搜索引擎收录"的名字,还在博客里自嘲:这样就不会有用户,也就不会有人给我提 issue 了。

但 pi.dev 首页那句标语确实戳人:

There are many agent harnesses, but this one is yours.

(世上有许多 agent 框架,但这一把是你自己的。)

抱着"省 token 能省到哪去"的怀疑,我把它装上真刀真枪跑了一圈。结论先放这里:省 token 是真的,而且省得毫无魔法——但它省的方式,可能让被大厂伺候惯了的人一时不适应。

极简到什么程度:系统提示词不到 1000 token

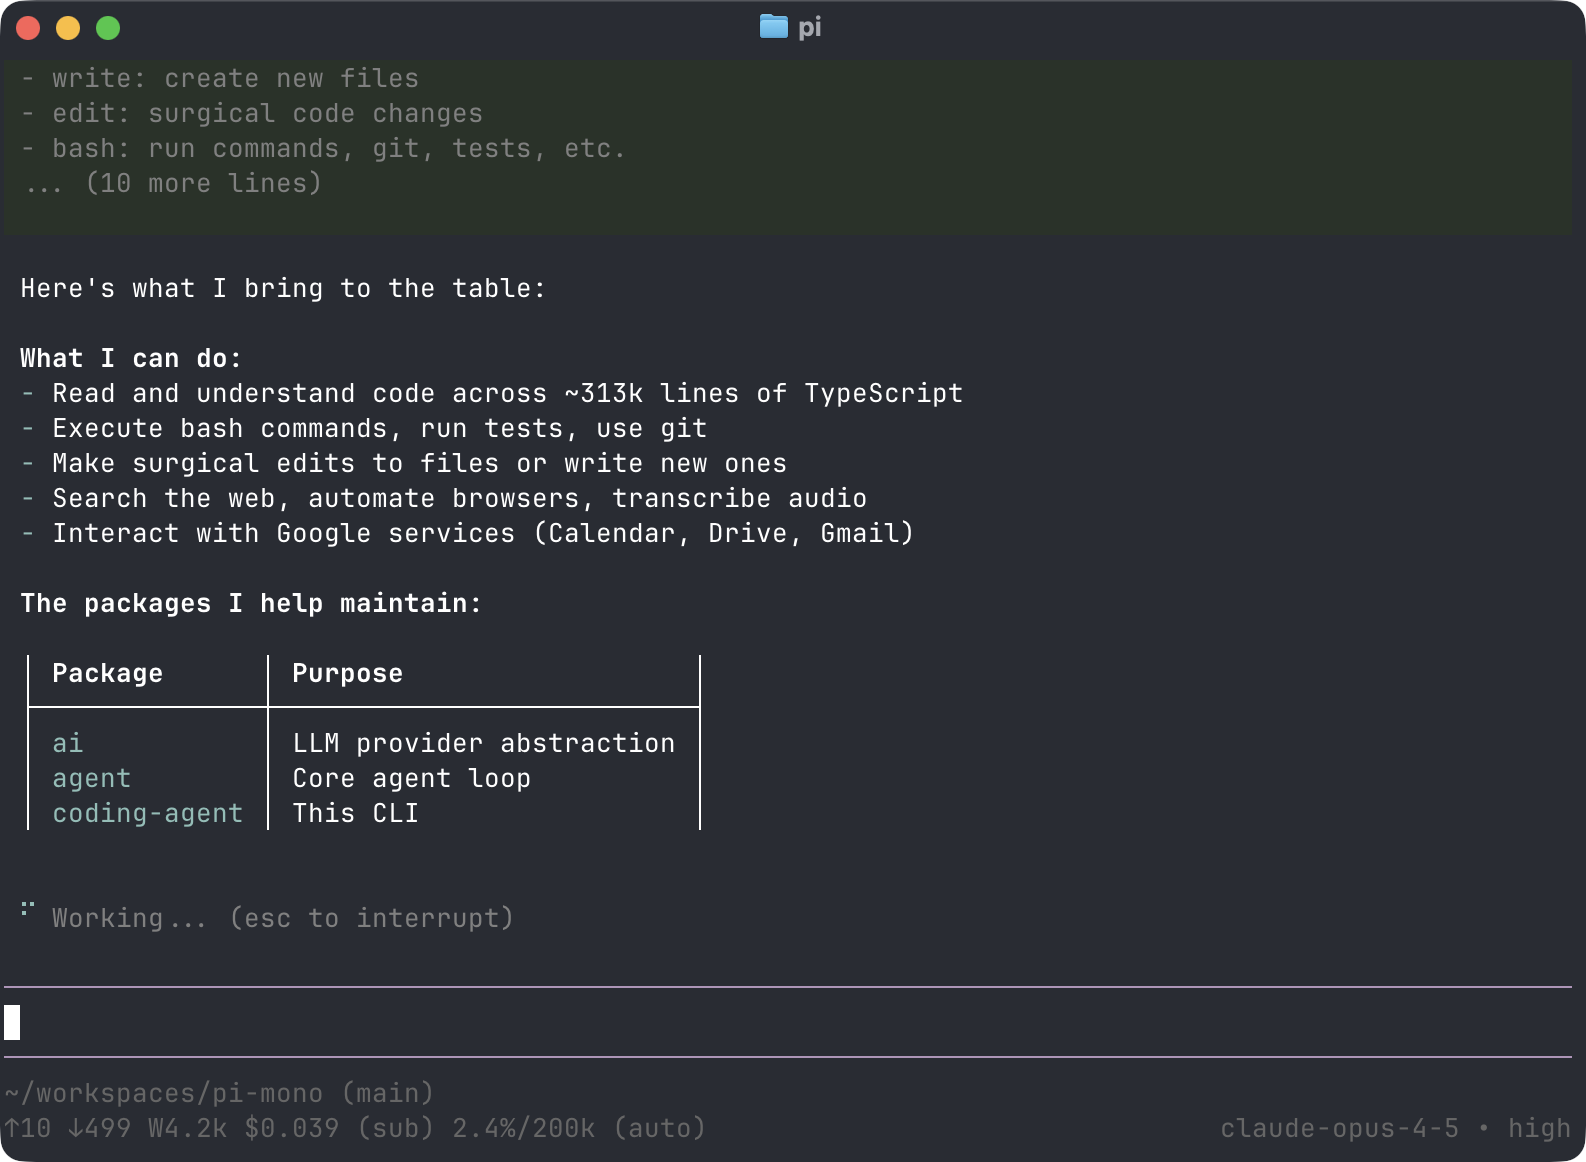
pi 的系统提示词,全文大意就这么多:

You are an expert coding assistant. You help users with coding tasks
by reading files, executing commands, editing code, and writing new files.

Available tools:
- read:  Read file contents
- bash:  Execute bash commands
- edit:  Make surgical edits to files
- write: Create or overwrite files

Guidelines:
- Be concise in your responses
- Use read to examine files before editing
...

对,就这。加上四个工具的参数定义,全部不到 1000 token。

作为对比,我天天在用的 Claude Code,光系统提示词加工具定义,起步就是一万多 token——每开一个新会话,还没说第一句话,一万 token 已经花出去了。pi 把这个起步成本砍到了一个零头。

Mario 的逻辑很暴论但细想有道理:前沿模型被 RL 训练得足够多了,天生就知道怎么当编码 agent,不需要一万 token 的保姆级说明书。这话他也不是空口说的——他带着 pi 用 Claude Opus 4.5 跑了 Terminal-Bench 2.0,跟 Codex、Cursor、Windsurf 这些重型选手同台,成绩排在前列。

实测:给真活干,看它怎么花钱

光看宣传没用。我给它派了个真实任务:一段有除零 bug 的 JS 代码,要求修复、写测试、跑通验证。

它的整个工作过程:5 次工具调用(read ×1、edit ×1、write ×1、bash ×2),6 轮模型请求,然后交卷:

输入 token: 1,593(非缓存)
输出 token: 1,087
缓存读:    19,520

说实话看到这个账单我愣了一下。这个数字里最值得玩味的是"非缓存输入"那一栏——整个任务真正新烧的输入 token 还不到 1600。pi 的省不是什么黑科技,是结构性的:系统提示词小、工具少、没有背着你塞进上下文的隐藏内容。你看到的就是模型看到的,花出去的每一个 token 都摆在明面上。

顺带一提,它对国产模型的亲和度意外地好。内置 zai 提供商,检测到我环境变量里的 ZAI_API_KEY 就直接认了,GLM-5.3-flash 开箱即用,上下文窗口直接给到 1M。装完第一次跑就成功返回,零配置。

踩坑三连(这部分最值钱)

安装五分钟就完事了,但配置踩了三个坑,全记在这里:

坑一:defaultModel 写了等于没写

我最初在 settings.json 里这样写:

{ "defaultModel": "zai/glm-5.3-flash" }

结果被静默忽略,不报错、不警告,就是不理你。正确姿势是两个键分开写:

{ "defaultProvider": "zai", "defaultModel": "glm-5.3-flash" }

这个格式要求藏在文档一行表格里,踩之前谁能想到。

坑二:一场 403 侦探剧

修好坑一以后依然 403:"Request not allowed"。诡异的是,命令行显式指定 --model 就一切正常,走默认配置就挂。

排查下来发现案中有案:我机器上有一组给 Claude Code 用的环境变量(ANTHROPIC_BASE_URL 指向 bigmodel 的 GLM 接入点)。pi 一看环境:哟,有 Anthropic 凭证,那默认走 Anthropic 家——于是拿着 GLM 的钥匙跑去 bigmodel 门口点名要 claude-opus-4-8,保安当场拦下。

把这组变量从环境里摘掉,立刻正常。教训:装了 pi 就把 defaultProvider 显式钉死,千万别让它自己猜。

坑三:证书报错连击

首次运行时 pi 想现场下载 ripgrep 和 fd 两个搜索工具,在我的网络环境下双双 TLS 证书报错。解法朴素得感人:

scoop install ripgrep fd

装完 pi 自己就在 PATH 里找到了它们,下载逻辑根本不触发。

它的哲学,你敢不敢用

pi 最有争议的不是功能少,而是它把几件事做绝了:

YOLO 模式是唯一模式。 没有权限确认弹窗,没有"允许此命令吗",文件直接改、命令直接跑。Mario 的说法是:一个能写代码又能执行代码的 agent,加那些确认框属于安全剧场——真想搞破坏的路子多了去了。我承认他说得有道理,但第一次看它毫无心理负担地改我文件的时候,还是倒吸了一口凉气。介意的话官方文档给了容器化方案,建议真的用起来。

拒绝 MCP。 理由很"token 感性":Playwright MCP 21 个工具的描述就是 13.7k token,Chrome DevTools MCP 26 个工具 18k token——还没开始干活,上下文先烧掉 7-9%。pi 的替代方案是"CLI 工具 + README":agent 需要时自己去读文档,用不到就不付钱。渐进式披露,这才是对上下文窗口的尊重。

"子代理是计划不足的症状。" 这是全书最暴论的暴论。他的观点:会话中途开子代理去收集上下文,说明你一开始就没规划好;正确姿势是单开一个会话把上下文整理成文档,再带着干净的上下文开工。我同意一半——上下文污染确实是大问题;但大型代码库里"先通读一遍"的成本也不低。这条见仁见智。

没有 todo 列表、没有 plan 模式。 需要就写 TODO.md、PLAN.md,让 agent 自己读写。文件即状态,跨会话可版本管理,比藏在运行时内存里的易失状态实在多了。

结论:适合谁

适合你,如果:你心疼 token、想完全掌控模型上下文、用订阅制模型(Claude Pro/Max、GLM Coding Plan 都能直连)、并且愿意花半小时按自己的口味改造工具——pi 的扩展是 TypeScript 模块,官方哲学就是"缺什么,让 pi 自己给自己写一个"。

不适合你,如果:你要开箱即用的安全护栏、离不开 MCP 生态,或者想到 AI 在工作目录里裸奔就睡不着觉。

至于我:Claude Code 还会继续用,但 pi 已经常驻了。一个是全副武装的飞船,一叶随身的皮划艇——远洋当然飞船稳,但去楼下便利店买瓶水,你真不想发动那台飞船。

想试的从 pi.dev 开始,五分钟能跑起来。记得先把 defaultProvider 钉死。

Views: 3

软件工程还值得学吗:这一年我在课堂内外看到的真相

又到毕业季,学生问得最多的一句话是:"老师,软件工程还值不值得学?"

我不打算给标准答案。先把这一年我在课堂内外看到的东西摆出来,再说我的判断。

掌舵的人已经把话挑明了

去年一月,扎克伯格在 Joe Rogan 的播客里说:2025 年,AI 将能够胜任公司里中级工程师的工作。这不是 futurist 写科幻,是 Meta 的 CEO 在向投资人交代人力成本的走向。

差不多同期,Anthropic 的 CEO 达里奥·阿莫代在公开场合预测,AI 会消灭相当比例的初级白领岗位。Salesforce 的贝尼奥夫说得更直白:他们公司相当一部分工作量已经由 AI 承担。

信不信是另一回事,但写代码这件事的稀缺性定价在往下走,是所有数据源共同的指向。GitHub 的调查里,使用 AI 辅助工具的开发者比例早已过半;国内招聘平台上,纯"增删改查"岗位的供给连续收缩,而 AI 应用开发、大模型工程化方向的岗位在逆势增长。

一句话总结现在的行情:总量在缩,门槛在抬,但塔尖和特定方向的口子反而张大了。

一个就在眼前的真实样本

不举远处的大厂例子,说说我自己干的事。

这两年我自己搭了一套课堂在线测验系统。不是外包的,不是买的,从需求分析到数据库设计到前端页面,自己一行行磨出来的。为什么一个教书的人要干这个?因为我发现"随堂测验—自动批改—错题统计"这件事,市面上的工具要么贵、要么不合教学场景,这就是一个真实的麻烦。

磨这个系统的过程中,我踩的坑比写十门课的作业都多:高并发提交怎么扛、防作弊怎么做、试卷数据怎么设计才不至于每加一个题型就重构一次。这些坑,恰恰是教科书里没有、面试官最爱问的东西。

后来我把这套系统用到真实课堂,几百个学生真实地用过、骂过、也真香过。这个完整的过程——发现麻烦、定义需求、选型、踩坑、上线、迭代——就是我理解里"软件工程"四个字的全部含义。

而这件事本身也说明:AI 时代并没有取消"做东西"的机会,反而把做东西的门槛降低了。 现在有大模型帮你写样板代码、查文档、 debug,一个普通人做出一个能用的系统的成本,比五年前低了一个数量级。问题只剩一个:你有没有一个真实的麻烦想去解决。

所以,到底还值不值得学

我的答案是:值得,但值得的姿势变了。

第一,"会写代码"的溢价在归零,"会做东西"的溢价在涨。 课程设计和真实项目的差距,不在于代码量,在于有没有真实用户、真实反馈、真实故障。趁早找一个真实的麻烦去解决——社团的、家里的、小店的都行。别嫌问题小,小才有机会做完整个闭环。

第二,把 AI 当锤子,别当对手。 焦虑"AI 会不会取代我"没有意义,有意义的是"我的产出里有多少是 AI 放大的"。现在面试已经出现新题型:给一个需求,允许用任何 AI 工具,限时看结果。习惯一个人硬啃的学生,在这种场合反而吃亏。

第三,地基别偷工减料。 数据结构、操作系统、计算机网络、数据库,这老四样在 AI 时代更值钱了。AI 能替你写代码,替不了你判断代码对不对、错在哪、为什么慢。面试官筛人,筛的就是"代码能跑但讲不出为什么"的那种。

第四,第一份工作是进站台,不是终点站。 死守"非大厂不去",把应届生身份耗在等待里,是我见过最亏的决策。先进场,在真实工程环境里泡两三年,那身本事是带得走的。行业有周期,人生是长跑。

第五,实习是硬通货。 秋招简历筛选的铁律没变过:一段对口实习,顶半页奖项。

结尾

技术永远在变,岗位永远在洗牌。但"发现一个真实的麻烦,然后把它漂亮地解决掉"这件事,从图灵的时代到现在,就没有贬值过。

工具越强大,会用工具解决真实问题的人就越值钱。

与学生共勉。

Views: 21

当规格成为软件的源头:GitHub Spec Kit 技术深度解析

当规格成为软件的源头:GitHub Spec Kit 技术深度解析

在 AI 编码时代,最值钱的不是代码,而是精确描述"你到底想要什么"的能力。

翻开任何一本软件工程的教材,你都会看到类似的流程图:需求分析 → 系统设计 → 编码实现 → 测试部署。这套方法论已经统治了软件行业几十年。但现实中发生了什么?需求文档写完就锁进抽屉,设计图在第一次 code review 后就再也没人看,测试用例是上线前一天通宵补的。

代码成了唯一的真相,而规格沦为了点缀。

GitHub 的 Spec Kit 想要翻转这件事。


范式转移:从"代码为王"到"规格为王"

传统开发的根本矛盾

软件工程一直有一个无法消除的缝隙:规格和实现之间的鸿沟

我们试过很多方法来缩小这个缝隙——更详细的 PRD、更严格的代码审查、更完善的敏捷流程。但这些都默认了一个前提:缝隙是不可避免的,我们只能尽量窄一点。

Spec-Driven Development(SDD,规格驱动开发)彻底否定了这个前提。它的核心主张是:消除缝隙,而不是缩小缝隙。

怎么做?让规格本身变成可执行的——规格不再是"给人看的参考文档",而是"能直接生成代码的源头"。

这背后的逻辑是:当代码必须从规格中"长出来"时,两者之间就不再有鸿沟,只有转换关系。

为什么是现在?

三个趋势在 2025 年同时成熟,让 SDD 从理论变成了实践:

AI 代码生成能力的临界点。 大语言模型已经能可靠地理解自然语言规格,并将其转化为可工作的代码。这不是取代开发者,而是放大他们的效能——把"规格→代码"这段机械翻译自动化。

软件复杂度的指数级增长。 一个现代应用动辄集成几十个微服务、框架和第三方依赖。靠人力保持所有组件与原始意图的一致性,已经变得几乎不可能。SDD 通过规格驱动来提供系统性的对齐保障。

需求变化的速度空前加快。 Pivot 不再是例外,而是常态。传统开发把需求变更视为"干扰",每次变更都要手动在文档、设计、代码之间传播。而 SDD 中,改规格、重新生成,就是标准流程的一部分。


Spec Kit 技术架构

Spec Kit 是 GitHub 官方开源的 SDD 工具包,它不是一个单一的代码生成器,而是一套完整的方法论基础设施。

核心组件

整个工具包由六个层次组成:

Specify CLI 是整个系统的入口。它是一个 Python CLI 工具(通过 uv 安装),负责项目初始化、集成管理、工作流编排等所有元操作。你不会直接用它写代码,但所有 SDD 流程都通过它来调度。

Templates 系统 是规格的骨架。每个命令(specify、plan、tasks 等)都对应一套结构化模板,确保输出不会遗漏关键信息——从非功能性需求到错误处理,从数据模型到 API 契约。

Integrations 层 连接 AI 编码代理。目前支持 30+ 工具——从 GitHub Copilot、Claude Code、Cursor 到 Codex CLI、Gemini CLI、Qwen Code,甚至包括国产的 Trae、Lingma、Kimi Code。每个集成都会设置好对应的命令文件、上下文规则和目录结构。

Extensions(扩展) 让你添加新能力——领域特定命令、外部工具集成、质量门禁。多个扩展可以独立安装和卸载。

Presets(预设) 定制 SDD 的工作方式——覆盖命令模板、术语对齐、组织标准适配,而不改变底层工具。

Workflows(工作流) 把多步骤的 SDD 流程编排成可重复的序列,支持条件分支、循环、fan-out/fan-in,甚至可以暂停和恢复。

优先级体系

这四层定制机制按优先级从高到低排列:

优先级 类型 位置
1 项目本地覆盖 .specify/templates/overrides/
2 Presets .specify/presets/templates/
3 Extensions .specify/extensions/templates/
4 Spec Kit 核心 .specify/templates/

这意味着你可以从"使用默认模板"开始,逐步通过预设和扩展来定制,最终实现完全的组织级标准化——而不用 fork 整个项目。


SDD 工作流:从想法到代码

六步核心流程

SDD 的核心流程可以用一条流水线来概括:

Constitution(建立宪法)→ Specify(写规格)→ Plan(做计划)→ Tasks(拆任务)→ Implement(写代码)→ Converge(对账)

每一步都有对应的 slash command,让我们用一个真实例子来走一遍。

Step 1: 建立项目宪法

/speckit.constitution 创建原则:代码质量标准、测试覆盖率 >80%、移动端优先的响应式设计、所有 API 必须有 OpenAPI 文档

这一步定义了项目的"基本法"——后续所有生成代码都受它约束。宪法不是写给人看的建议,而是写入 AI 上下文的硬性规则。当后续 plan 和 implement 阶段做出技术决策时,这些原则会被自动引用。

这相当于在提示词工程中设定 system prompt——先画好边界,再让 AI 在边界内发挥。

Step 2: 写规格(最关键的一步)

/speckit.specify 构建一个照片管理应用,可以按日期分组相册,支持拖拽重新排列,相册不嵌套,照片以网格预览

注意这里只描述 What(做什么)和 Why(为什么),完全不涉及技术栈。这一步会自动完成:

  • 扫描现有 specs 目录,确定下一个 feature 编号(001、002…)
  • 从描述中生成语义化的分支名并创建 Git 分支
  • 基于模板生成结构化的 feature 规格文档,放在 specs/[branch-name]/spec.md
  • 自动填充用户故事、验收标准、非功能性需求

AI 在这一步会追问你:相册容量有没有上限?拖拽时要不要显示放置预览?照片要不要支持排序?这些问题在传统开发中往往要到 code review 阶段才被发现。

Step 3: 制定技术计划

/speckit.plan 使用 Vite 构建,尽量用原生 HTML/CSS/JS,图片不上传,元数据存本地 SQLite

这一步把产品规格翻译成技术方案。AI 会:

  • 读取并分析 spec.md 中的需求和验收标准
  • 对照项目宪法,确保技术选型符合约束
  • 生成数据模型(data-model.md
  • 生成 API 契约(contracts/ 目录)
  • 生成研究文档(research.md),包含库的对比、性能基准等

每一个技术决策都有记录的 rationale,追溯到具体的需求条目。这意味着当未来有人问"为什么选 SQLite 而不是 PostgreSQL",答案就在文档里,而不是丢失在 Slack 历史消息中。

Step 4: 拆解任务

/speckit.tasks

从 plan.md 出发,自动生成可执行的任务列表。关键特性:

  • 并行标记:独立任务会被标记 [P],标识可以安全并行的任务组
  • 依赖排序:有依赖关系的任务按正确顺序排列
  • 验收条件:每个任务都有明确的"完成标准"

输出是 specs/[branch-name]/tasks.md,一份结构化的执行清单。

Step 5: 执行实现

/speckit.implement

AI 按任务列表逐个实现。这个阶段的概念映射非常优雅:

  • 领域概念 → 数据模型
  • 用户故事 → API 端点
  • 验收场景 → 测试用例

测试不再是事后补的,而是从规格中"自然生长"出来的。因为验收条件在 spec 阶段就定义好了,implement 只是把它翻译成可执行的测试代码。

Step 6: 收敛对账

/speckit.converge

这是一个经常被忽视但极其重要的步骤:对比现有代码和 spec/plan/tasks,找出遗漏的工作项并追加为新任务。它回答的问题是:"我们生成的代码,真的实现了规格中定义的所有东西吗?"


进阶能力

Clarify:在计划之前消除模糊

/speckit.clarify

运行在 specify 之后、plan 之前。AI 会系统性地分析规格中的模糊点、矛盾点和遗漏点,然后向你提问。这就像有一个经验丰富的架构师帮你做 design review,但在你写一行代码之前。

Analyze:交叉一致性验证

/speckit.analyze

运行在 tasks 之后、implement 之前。它检查 spec、plan、tasks 三个文档之间的一致性:

  • spec 中的每个需求,在 plan 中都有对应的技术方案吗?
  • plan 中的每个设计决策,在 tasks 中都有对应的任务吗?
  • 有没有孤立的任务(不追溯到任何需求)?

这相当于"英文写的单元测试"——在写代码之前先验证文档的质量。

Checklist:质量门禁

/speckit.checklist

生成定制化的质量检查清单,验证需求的完整性、清晰度和一致性。可以被纳入 CI 流程,成为自动化的质量门禁。


Workflow 引擎:可编排的 SDD 流水线

Spec Kit 不只是提供孤立的命令,它还有一个完整的 Workflow 引擎,把多步骤流程编排成可重复、可暂停、可恢复的流水线。

内置的 Full SDD Cycle

Spec Kit 自带一个完整 SDD 循环工作流,把 specify → plan → tasks → implement 串联起来,中间插入人工审核门禁:

schema_version: "1.0"
workflow:
  id: "speckit"
  name: "Full SDD Cycle"
  description: "Runs specify → plan → tasks → implement with review gates"

steps:
  - id: specify
    command: speckit.specify
    input:
      args: "{{ inputs.spec }}"

  - id: review-spec
    type: gate
    message: "Review the generated spec before planning."
    options: [approve, reject]
    on_reject: abort

  - id: plan
    command: speckit.plan

  - id: review-plan
    type: gate
    message: "Review the plan before generating tasks."
    options: [approve, reject]
    on_reject: abort

  - id: tasks
    command: speckit.tasks

  - id: implement
    command: speckit.implement

一行命令启动:

specify workflow run speckit -i spec="构建一个看板系统,支持拖拽任务管理"

支持的步骤类型

Workflow 引擎支持 10 种步骤类型:

类型 用途
command 调用 Spec Kit 命令
prompt 向 AI 发送任意提示
shell 执行 shell 命令
init 引导新项目
gate 人工审核门禁
if 条件分支
switch 多路分发
while 条件循环
do-while 至少执行一次的循环
fan-out / fan-in 并行分发与结果聚合

状态持久化

每个 workflow run 都会持久化状态到 .specify/workflows/runs/<run_id>/

  • state.json — 当前运行状态和步骤进度
  • inputs.json — 已解析的输入值
  • log.jsonl — 逐步骤执行日志

这意味着当你在一个 gate 步骤暂停后,可以用 specify workflow resume <run_id> 从断点恢复。这在需要人工审核的场景中特别有用——你可以花一天时间审核 spec,然后一键继续。


实战效率对比

传统方式和 Spec Kit 方式的效率差异是显著的。以构建一个实时聊天功能为例:

传统方式:

步骤 耗时
写 PRD 文档 2-3 小时
创建设计文档 2-3 小时
手动搭建项目结构 30 分钟
写技术规格 3-4 小时
创建测试计划 2 小时
合计 约 12 小时

使用 Spec Kit:

步骤 耗时
/speckit.specify 写规格 5 分钟
/speckit.plan 做计划 5 分钟
/speckit.tasks 拆任务 5 分钟
合计 约 15 分钟

15 分钟内你得到了:完整的 feature 规格(含用户故事和验收标准)、详细的技术实现计划(含技术选型理由)、API 契约和数据模型、测试场景、所有文档都在 feature 分支中正确版本化。

当然,这不意味着 15 分钟就能上线一个聊天系统。后续的 implement、测试、调试仍然需要时间。但前置的文档和规划工作从 12 小时压缩到 15 分钟,这个量级的提升是实实在在的。


谁适合用 Spec Kit?

高度适配的场景

AI-Native 团队。 如果你已经在用 Copilot、Claude Code 或 Cursor 写代码,Spec Kit 是天然的升级——从"AI 帮你写函数"进化到"AI 帮你写整个 feature"。

提示词工程师。 SDD 的核心理念——"精确描述你要什么"——和提示词工程完全同构。规格本质上就是给 AI 的结构化提示词。

教学场景。 SDD 强制学生先想清楚"要什么"再动手,这培养了系统思维。学生不能跳过需求分析直接写代码,因为 Spec Kit 的流程不允许。

快速原型和 MVP。 "如果我改这个需求,重新实现要多久?"——在 SDD 中,答案是"改 spec,重新生成"。这使得探索多个技术方案的成本极低。

需要谨慎的场景

遗留系统改造。 Spec Kit 的价值在新项目中最大化。对于已有大量代码的遗留系统,你需要先为现有功能"补写"规格,才能享受 SDD 的好处——这个补写过程本身就很昂贵。

高度定制化的底层系统。 如果你写的是操作系统内核、编译器或数据库引擎,规格→代码的转换可能不如业务应用那么直接。


SDD 的深层启示

规格即提示词

站在提示词工程的视角看 SDD,会有一个有趣的发现:规格文档本质上就是给 AI 的结构化提示词。

  • Constitution = System Prompt(设定边界和规则)
  • Spec = User Prompt(描述具体任务)
  • Plan = Chain-of-Thought(让 AI 展示推理过程)
  • Tasks = Step-by-Step Decomposition(任务分解)
  • Converge = Self-Check(自我验证)

这意味着 SDD 最佳实践和提示词工程最佳实践高度重合。一个优秀的提示词工程师,天然就是优秀的规格编写者。

代码的终局

SDD 提出了一个深刻的问题:当代码可以从规格中自动生成时,代码还是资产吗?

在 SDD 的世界观中,代码更像是"编译产物"——可以随时从源头重新生成。真正的资产是规格、是团队对需求的理解、是架构决策的记录。

这意味着未来的开发者可能不再"写代码",而是"写规格"。代码变成了一种中间表示,就像我们不再手写汇编一样。

从 0 到 1,从 1 到 N

SDD 的流程本质上是:

0 (idea) → 1 (spec) → implementation → 1' (new spec) → new implementation → 2 → 3 → N

第一次实现是 0→1,后续的每次修改都是改规格、重新生成。同一个规格可以生成不同的实现(用不同的技术栈、优化不同的维度),就像同一个设计图纸可以盖出不同材料的房子。

这让"重新开始"不再昂贵——你不需要从代码中剥离旧逻辑,只需要修改规格的对应部分,然后重新生成。


快速上手

# 1. 安装 uv(如果没有的话)
curl -LsSf https://astral.sh/uv/install.sh | sh

# 2. 安装 Specify CLI(替换为最新版本号)
uv tool install specify-cli --from git+https://github.com/github/spec-kit.git@v0.8.5

# 3. 初始化项目
specify init my-project --integration copilot
cd my-project

# 4. 启动你的 AI 编码代理,然后依次运行:
# /speckit.constitution   ← 定义项目原则
# /speckit.specify        ← 写规格
# /speckit.clarify        ← 消除模糊点
# /speckit.plan           ← 做技术计划
# /speckit.analyze        ← 一致性检查
# /speckit.tasks          ← 拆任务
# /speckit.implement      ← 写代码
# /speckit.converge       ← 对账

或者用 Workflow 一步到位:

specify workflow run speckit -i spec="你的需求描述"

结语

Spec Kit 不是一个代码生成工具。它是一种开发哲学的载体——规格才是软件的真正源头,代码只是它的投影。

这个哲学并不新(形式化方法领域已经探索了几十年),但 AI 代码生成能力的成熟让它第一次变得可操作。当 GitHub 这样的平台级玩家开始投入,意味着这不只是实验性的尝试,而是软件工程范式转移的信号。

对于每一个在 AI 时代写代码的人来说,值得思考的问题是:你花在描述"要什么"上的时间,是否配得上它的重要性?

Spec Kit 给出的答案是:把最好的精力放在规格上,剩下的交给机器。


GitHub 仓库:github/spec-kit
官方文档:github.github.io/spec-kit

Views: 55
Index