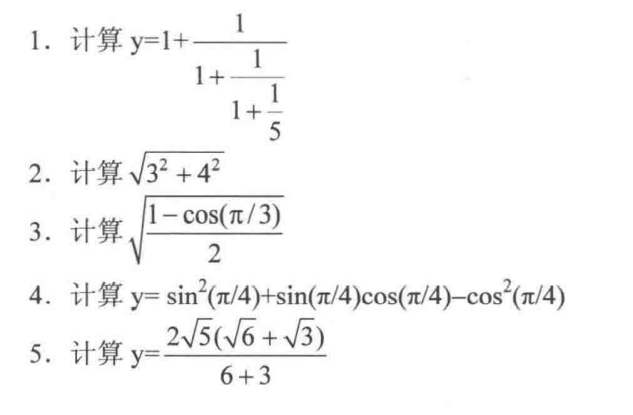
神奇的魔数:0x5f3759df

Quake-III Arena (雷神之锤3)是90年代的经典游戏之一。

该系列的游戏不但画面和内容不错,而且即使计算机配置低,也能极其流畅地运行。这要归功于它3D引擎的开发者约翰-卡马克(John Carmack)。

事实上早在90年代初DOS时代,只要能在PC上搞个小动画都能让人惊叹一番的时候,John Carmack就推出了石破天惊的Castle Wolfstein, 然后再接再励,doom, doomII, Quake...每次都把3-D技术推到极致。他的3D引擎代码资极度高效,几乎是在压榨PC机的每条运算指令。当初MS的Direct3D也得听取他的意见,修改了不少API。

最近,QUAKE的开发商ID SOFTWARE遵守GPL协议,公开了QUAKE-III的原代码,让世人有幸目睹Carmack传奇的3D引擎的原码。

我们知道,越底层的函数,调用越频繁。3D引擎归根到底还是数学运算。

那么找到最底层的数学运算函数(game/code/q_math.c),必然是精心编写的。里面有很多有趣的函数,很多都令人惊奇,估计我们几年时间都学不完。

在/code/game/q_math.c里发现了这样一段代码。

它的作用是将一个数开平方并取倒。

那么你会如何通过代码写出下面这个公式?

f(x) = \frac{1}{\sqrt{x}} \\

如果是我的话,一行代码搞定float y = 1 / sqrt(x)。而《雷神之锤3》实现的方式就非常有趣:

float Q_rsqrt( float number )
{
  long i;
  float x2, y;
  const float threehalfs = 1.5F;

  x2 = number * 0.5F;
  y = number;
  i = * ( long * ) &y; // evil floating point bit level hacking
  i = 0x5f3759df - ( i >> 1 ); // what the fuck?
  y = * ( float * ) &i;
  y = y * ( threehalfs - ( x2 * y * y ) ); // 1st iteration
  // y = y * ( threehalfs - ( x2 * y * y ) ); // 2nd iteration, this can be removed

  #ifndef Q3_VM
  #ifdef __linux__
  assert( !isnan(y) ); // bk010122 - FPE?
  #endif
  #endif
  return y;
}

函数返回1/sqrt(x),这个函数在图像处理中比sqrt(x)更有用。

注意到这个函数只用了一次叠代!(其实就是根本没用叠代,直接运算)。编译,实验,这个函数不仅工作的很好,而且比标准的sqrt()函数快4倍!要知道,编译器自带的函数,可是经过严格仔细的汇编优化的啊!

这个简洁的函数,最核心,也是最让人费解的,就是标注了“what the fuck?”的一句:

i = 0x5f3759df - ( i >> 1 );

再加上

y = y * ( threehalfs - ( x2 * y * y ) );

两句话就完成了开方运算!而且注意到,核心那句是定点移位运算,速度极快!特别在很多没有乘法指令的RISC结构CPU上,这样做是极其高效的。

如果你看到这个0x5f3759df数字,想必有点小懵逼,人生三问开始了:

  1. 它是谁?
  2. 它怎么来的?
  3. 它有什么用?

下面就会介绍这个magic number从何来,去何处。

为何需要这个算法?

当你需要在游戏中实现一些物理效果,比如光影效果、反射效果时,所关注的点其实是某个向量的方向,而不是这个向量的长度,如果能将所有向量给单位化,很多计算就会变得比较简单。

所以在计算中很重要的一点就是计算出单位向量,而在真正在运行代码中需要根据某个向量计算相应的单位向量,根据某个向量(x, y, z)计算法向量公式如下

x_0 = x * \frac{1}{\sqrt{x^2 + y^2 + z^ 2}}  \\
y_0 = y * \frac{1}{\sqrt{x^2 + y^2 + z^ 2}}  \\
z_0 = z * \frac{1}{\sqrt{x^2 + y^2 + z^ 2}}  \\

可以看出来计算一个数的平方根的倒数其实非常频繁,所以需要一个很快的算法去计算平方根倒数。众所周知,乘法和加法在计算机中被设计得非常快,所以x<em>x+y</em>y+z*z计算起来真的非常快,但是

sqrt(xx + yy + zz)求平方根算法很慢,求一个数的倒数即除法也很慢,所以上面的一行代码实现平方根倒数所消耗的时间会特别慢。而Q_rsqrt(x</em>x + y<em>y + z</em>z)里面的代码没有看到任何除法,以及求平方根,里面全部都是乘法、位移等运算速度很快的操作,平方根倒数速算其实是计算的近似数,大约1%的误差,但是运算速度是之前的三倍,下面就会解释这几行代码。

初始化参数

long i;

float x2, y;

const float threehalfs = 1.5F;

x2 = number * 0.5F;

y = number;

首先函数的参数是一个32位浮点数,之后声明一个32位整型变量i,继续声明两个32位浮点数x2,y,声明一个32位浮点数常量threehalfs,即表示\frac{3}{2},之后两行也非常简单,一个是将number的一半赋值给x2,将number赋值给y,你会发现很有趣的一点,就是这些变量不管是整型还是浮点型,其在内存中的长度都是32位,这其实是magic发生的基础。

接着看下面几行的注释(因为直接看代码也看不懂),分别是evil bit hack、what the fuck、newton iteration,这三个注释其实就说明了整个算法重要的三步,在真正解释这三个步骤之前,先来说说浮点数的在内存中表示。

二进制数的表示方法

在日常生活中,我们通常以十进制的方式表示现实生活中的各种数,这种数被称为真值,对于负数,我们会在数的前面加一个‘-’号表示这个数是小于0,‘+’号(通常不写)去表示一个正数。而在计算机中只能表示0、1两种状态,所以下正负号在计算机中会以0、1的形式表示,通常放在最高位,作为符号位。为了能够方便对这些机器数进行算术运算、提高运算速度,计算机设计了许多种表示方式,其中比较常见的是:原码、反码、补码以及移码。下面主要以8bit长度的数0000 0100,即十进制数4,去介绍这几种表示方式

  • 原码

原码表示方式是最容易理解的,首先第一位为符号位,后面七位表示的就是真值,如果表示负数,只需要将符号位置为1即可,后面七位依然为真值,所以4与-4的原码为0000 0100 和 1000 0100。所以很容易就得出原码的表示范围为[-127, 127],会存在两个特殊的数为+0与-0。

  • 反码

正数的反码即是其原码,而负数的反码就是在保留符号位的基础上,其他位全部取反,所以4与-4的反码为0000 0100 和 1111 1011。所以反码表示范围为[-127, 127],依然存在两个特殊的数为+0与-0。

  • 补码

正数的补码即是其原码,而负数的补码就是在保留符号位的基础上,其他位全部取反,最后加1,即在反码的基础上+1,所以4与-4的补码是0000 0100 和 1111 1100。所以补码表示范围为[-128,127],之前的-0在补码中被表示成了-128,可以多表示一个数,另外补码统一了正数0和负数0。

  • 移码

假设数值用八位有符号二进制表示, 则移码表示在数轴上将真值在范围从[-128, 127]变为[0, 255],即向上偏移量128,即将补码的符号位取反(将负数平移到正数区间内),所以4与-4的移码为1000 0100 和 0111 1100,移码的好处是可以直观方便的比较两数在数轴上的大小。

浮点数

先考虑一个问题,如果你用32位二进制如何表示4.25?可能会是这样:

0000 0000 0000 0100 . 0100 0000 0000 0000

这放在普通十进制,这种想法其实非常常见,但是这种方式放在二进制世界中,总共1位符号位,15号整数位,16位小数位,总共表示数的范围只有[-2^{15}, 2^{15}],而对于长整型的范围却有[-2^{31}, 2^{31}],差的倍数有6w5,可见这种方式为了小数表示抛弃了一半的位数,得不偿失,所以有人提出了IEEE754标准。

IEEE754

在描述这个标准前,先在这里说下科学计数法,在十进制中科学计数法表示如下

\begin{aligned} & 12300 && 1.23 * 10^{4} \\ & 0.00123 && 1.23 * 10^{-3} \\ \end{aligned}  \\

同样的,可以将科学计数法运用到二进制中

\begin{aligned} & 11,000 && 1.1 * 2^{4} \\ & 0.0101 && 1.01 * 2^{-2} \\ \end{aligned} \\

所以IEEE754也是采用的是科学计数法的形式,会将32位数分为以下三部分

  • Sign Bit

首先第一位是符号位,0表示正数,1表示负数,而在平方根的计算中,明显不会涉及到负数,所以第一位肯定是为0的。

  • Exponent

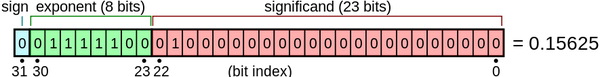
第二部分用8位bit表示指数部分(乘上2的几次方),可以表示数的范围是[0, 255],但是这个只能表示正数,所以需要把负数也加进来,而IEEE754标准中阶码表示方式为移码,之所以要表示为移码的方式是在浮点数比较中,比较阶码的大小会变得非常简单,按位比较即可。不过和正常的移码有一点小区别是,0000 0000与1111 1111用来表示非规格化数与一些特殊数,所以偏移量从128变为127,表示范围也就变成了[-127, 126]。

举个例子,众所周知啊,4这个数的8bit真值为0000 0100,加上127的偏移量变成131,即阶码的二进制表示为1000 0011。

  • Mantissa

二进制科学计数法中小数部分就是剩余的23位,由于第一位二进制数总是1,所以用这23位bit表示剩余的数值,真正计算的时候再在最高位加上1即可。

下面我们以9.625这个数改成IEEE 754标准的机器数:

首先变为相应的二进制数为1001.101,用规范的浮点数表达应为1.001101 * 2^{3},所以符号段为0,指数部分的移码为1000 0010,有效数字去掉1后为001101,所以最终结果为

0 |10000010 |00110100000000000000000

二进制数转换

在前面我们介绍了一个浮点数是如何在计算机中以机器数来表示的,现在我们要对这个浮点数进行一些骚操作,以方便之后对这个浮点数的处理。

同样的,我们以9.625这个数为例,首先我们令阶码的真值为E,则有

E = 1000,0010_{(2)} = 130_{(10)}  \\

令余数为M,则有

M = 00110100000000000000000_{(2)} = {0.001101 * 2^{23}}_{(2)} \\

现在我们先不认为这个是浮点数,这个数就是32位长整型,令这个数为L,它所表示的十进制数便是这样

L = 2^{23} * E + M \\

这个数L便是这32位所表示的无符号整型,这个数后面有大用,我们先暂且把它放在这儿,后续再来看。

然后我们通过一个公式来表示这个浮点数F的十进制数

F = (1 + \frac{M}{2^{23}}) * 2^{E - 127} \\

尾数加1是因为在IEEE754标准中把首位的一去掉了,所以计算的时候需要把这个一给加上,然后阶码减去127是因为偏移为127,要在8位真值的基础上减去127才是其表示真正的值。

然后有趣的事情就发生了,我们现在将这个数F取下对数

\log_2 F = \log_2 (1 + \frac{M}{2^{23}}) + E - 127 \\

在这个公式,E-127自然非常好计算,但是前面的对数计算起来是比较麻烦的,所以我们可以找个近似的函数去代替对数。

现在看下y=log_2(1 + x)与y=x的图像

根据图像,我们很容易得出下面这个结论

\lim_{x \to 0^+} \log_2 (1 + x) = x  \\
lim_{x \to 1^-} \log_2 (1 + x) = x \\

然后很容易发现,在[0, 1]这个范围内,\log_2(x+1)与x其实是非常相近的,那样我们可以取一个在[0,1]的校正系数\mu$,使得下面公式成立

\log_2 (x + 1) \approx x + \mu \\

到此,我们知道了怎样去简化对数,所以我们可以将这个简化代入上面浮点数表示中,就可以得到

\begin{aligned} \log_2 F &= \log_2 (1 + \frac{M}{2^{23}}) + E - 127 \\ & \approx (\frac{M}{2^{23}} + \mu) + E - 127 \\ & = (\frac{M}{2^{23}} + \frac{E * 2^{23}}{2^{23}}) + \mu - 127 \\ & = \frac{1}{2^{23}} (M + E * 2^{23}) + \mu - 127 \end{aligned} \\

看见这个M + E * 2 ^{23}\\应该比较熟悉吧,这个数就是浮点数F的二进制数L,然后代入约等式中得到

\log_2 F \approx \frac{L}{2^{23}} + \mu - 127 \\

在某种程度上,不考虑放缩与变换,我们可以认为浮点数的二进制表示L其实就是其本身F的对数形式,即

\log_2 F \approx L \\

三部曲

经过上面一系列复杂的数字处理操作,我们终于可以开始我们的算法三部曲了

evil bit hack

众所周知啊,每个变量都有自己的地址,程序运行的时候就会通过这个地址拿到这个变量的值,然后进行一系列的计算,比如i和y在内存中会这样表示
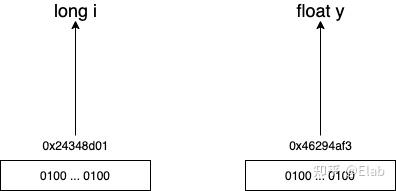
我们对长整型这些数据很好进行位移运算,比如我想将这个数乘以或者除以2^n\\,只需要左移或者右移N个位就可以,但是浮点数明显无法进行位运算,它本身二进制表示就不是为了位运算设计的。

然后,现在就会提出一个想法,我把float转成int,然后进行位运算不就行了,代码如下long i = (long) y

假设y为3.33,进行长整型强转后,C语言会直接丢弃尾数,i也就变成了3,丢失这么多精度,谁干啊,如果我们想一位都不动地进行位运算,就是下面这份代码i = <em> ( long </em> ) &y

这个强转过程其实没改变内存中任何东西,首先它并没有改变0x3d6f3d791这个地址,也没改变这个地址中所存储的数据,可以认为改变的是C语言的“认知”,原本是要以IEEE754标准去读取这个地址中数据,但是C语言现在认为这个是长整型的地址,按长整型方式读取就行。所以(long<em>)&y代表0x3d6f3d791这个地址中存储的是长整型数据,然后我通过</em>运算符从这个地址中拿出数据,赋值给i这个长整型变量。
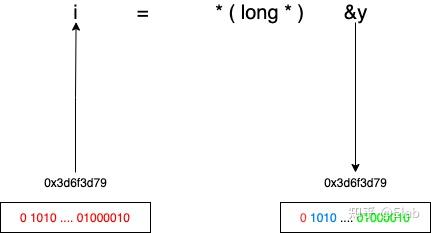
这行代码做了什么事呢,&y首先将浮点数y的地址找出来,可以认为就是0x3d6f3d79这个地址,它的类型其实是float <em>,C语言便会以浮点数的形式将这个数取出来,而想让C语言认为这个是长整型类型,就必须进行地址的类型的强转,将float </em>强转成long *。

这样我们其实避开了数字本身的意义,而是通过地址变换完整地拿出了这个二进制数据。

what the fuck

众所周知啊,位运算中的左移和右移一位分别会使原数乘以或者除以2,比如

\begin{aligned} x & & 110 &= 6 \\ x << 1 & & 1100 &= 12 \\ x >> 1 & & 11 &= 3 \\ \end{aligned} \\

我们想办法把平方根倒数做一个简单的转化

\frac{1}{\sqrt x} = x^{-\frac{1}{2}} \\

这个等式其实就是我们的最终目标,接下的计算就会逐渐往这个等式靠近,得到一个近似的结果。

在前面一步的叙述中,我们得出这样一个结论,浮点数的二进制表示其实就是其本身的对数形式,想要求的浮点数存储在y中,则有

y = 9.625 \\  \\
log_2 (y) \approx i = 01000001 \ 00011010 \ 00000000 \ 00000000 \\

也就是说i中其实存储着y的对数,当然还需要进行一系列的转换与缩放。

前面提到过,直接运算一个数的平方根倒数,所以不如直接计算平方根倒数的对数,然后就会有如下等式

\begin{aligned} \log_2 (\frac{1}{\sqrt y}) = \log_2 (y^{- \frac{1}{2}}) & = - \frac{1}{2} \log_2(y) \\ \log_2 (y) & \approx i \\ \log_2 (\frac{1}{\sqrt y}) & \approx -(i >> 1) \end{aligned}  \\

除法同样计算速度是比较慢的,所以我们用右移代替除法,这也就解释了-(i >> 1)其实是为了计算\log_2 (\frac{1}{\sqrt y})的结果。

所以0x5f3759df这个数到底咋来的,为啥要这么计算,并且-(i >> 1)并不完全是\log_2 (\frac{1}{\sqrt y})的近似值啊,根据公式还得除以2^{23},还得加上一定的误差。

先别急,我们先算下这个magic number是咋来的,令\Gamma为y的平方根倒数,则有

\begin{aligned} \Gamma & = \frac{1}{\sqrt y} \\ \log_2 \Gamma & = \log_2 (\frac{1}{\sqrt y}) = -\frac{1}{2} \log_2 (y) \end{aligned} \\

然后我们代入上面那个浮点数对数的公式中,则有

\begin{aligned} \log_2 \Gamma & = \frac{1}{2^{23}} (M_{\Gamma} + E_{\Gamma} * 2^{23}) + \mu - 127 \\ \log_2 y & = \frac{1}{2^{23}} (M_y + E_y * 2^{23}) + \mu - 127 \\ \frac{1}{2^{23}} (M_{\Gamma} + E_{\Gamma} * 2^{23}) + \mu - 127 & = -\frac{1}{2}(\frac{1}{2^{23}} (M_y + E_y * 2^{23}) + \mu - 127) \end{aligned} \\

现在经过一定的变换能够得到下面这个式子

\begin{aligned} (M_{\Gamma} + E_{\Gamma} * 2^{23}) & = \frac{3}{2}2^{23}(127 - \mu) -\frac{1}{2} (M_y + E_y * 2^{23}) \\ & = 0x5f3759df - (i >> 1) \end{aligned} \\

这里\mu是就是之前简化对数计算引进的误差,通过一定计算,得到最合适的\mu,来得到\Gamma的近似值。这个计算过程偏向纯数学化的,具体过程请查阅《FAST INVERSE SQUARE ROOT》这篇论文。

原算法中取的\mu值为0.0450465,然后计算一下

\frac{3}{2}2^{23}(127 - \mu) = \frac{3}{2}2^{23}(127 - 0.0450465) = 1597463007 \\

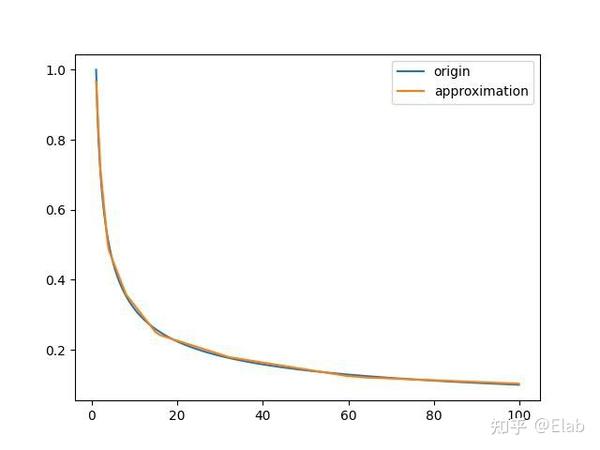
这个数的十六进制就是0x5f3759df,也就是上面提到的那个magin number,然后我们根据这个数去计算得到的近似值,并与真正的\frac{1}{\sqrt y}进行比较,具体函数图像如下

从上面的图像可以看到,在[1,100]这个区间内,所得到的近似值曲线已经和原始值制拟合的比较好了,这样我们已经完成了前面几个比较重要的步骤。y = <em> ( float </em> ) &i;

这样我们通过和evial bit hack的逆向步骤,即将一个长整型的内存地址,转变成一个浮点型的内存地址,然后根据IEEE754标准取出这个浮点数,即我们要求的\Gamma的近似值,其实到这里应该是算法差不多结束了,但是这个近似值还存在一定的误差,还需要经过一定的处理降低误差,更接近真实值。

Newton Iteration

本身我们已经得到了一个比较好的近似值,但是仍然存在一定的误差,而牛顿迭代法可以这个近似值更加接近真实的值,近一步减少误差。

牛顿迭代法本身是为了找到一个方程根的方法,比如现在有一个方程f(x)=0,需要找到这个方程的根,但是解方程嘛,是不会解方程的,所以可以找到一个近似值来代替这个真正的解。
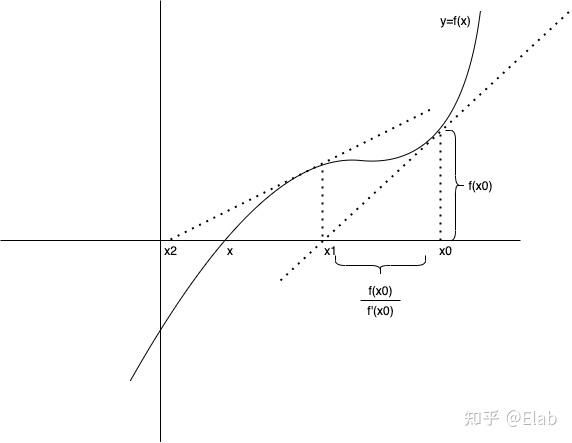
如上图,假设f(x)=0的解为x=x_c,我们需要首先给一个x的近似值x_0,通过这个x_0,不断求得一个与x_c更接近的值。

在(x_0, f(x_0))处做切线,切线的斜率就是f(x)在x=x_0的导数f'(x_0),然后来求这条切线与x轴的交点x_1,则有

x_1 = x_0 - \frac{f(x_0)}{f'(x_0)}  \\

这样我们就完成了一次迭代,从图像上可以看见x_1比x_0更接近于真正的解,下一次迭代基于x_1进行同样的步骤,就能得到比x_1更好的近似值x_2,所以牛顿迭代公式非常简单

x_{n + 1} = x_n - \frac{f(x_n)}{f'(x_0)} \\

当这个迭代次数接近无限时,x_n也就越接近真正的解。

而最后一行就是经过一次迭代后的简化公式,这个公式怎么来的呢。对于一个浮点数a,要求它的平分根倒数,则有

y = \frac{1}{\sqrt a} \\

通过这个公式能构成一个函数

f(y) = \frac{1}{y^2} - a \\

求这个y值,其实就是求f(y)=0的根,所以迭代公式就是

\begin{aligned} y_{n+1} & = y_n - \frac{f(y_n)}{f'(y_n)} \\ & = y_n - \frac{y_n^{-2} - a}{-2 * y_n^{-3}} \\ & = y_n * (\frac{3}{2} - \frac{1}{2}* a * y_n^2) \end{aligned} \\

这个公式对应的算法中的代码y = y <em> (threehalfs - ( x2 </em> y * y ) )

至此,你的代码就更接近真实的y=\frac{1}{\sqrt x},在更接近真实答案的同时,运行速率也大大提升。仅仅牺牲了一点点的准确性,却能提高整个的速度,这其实就是算法在优化中的一个比较重要的点。

Lomont -"Fast Inverse Square Root"。

普渡大学的数学家Chris Lomont看了这个算法以后觉得有趣,决定要研究一下卡马克弄出来的这个猜测值有什么奥秘。Lomont也是个牛人,在精心研究之后从理论上也推导出一个最佳猜测值,和卡马克的数字非常接近, 0x5f37642f。卡马克真牛,他是外星人吗?

传奇并没有在这里结束。Lomont计算出结果以后非常满意,于是拿自己计算出的起始值和卡马克的神秘数字做比赛,看看谁的数字能够更快更精确的求得平方根。结果是卡马克赢了... 谁也不知道卡马克是怎么找到这个数字的。

最后Lomont怒了,采用暴力方法一个数字一个数字试过来,终于找到一个比卡马克数字要好上那么一丁点的数字,虽然实际上这两个数字所产生的结果非常近似,这个暴力得出的数字是0x5f375a86。

Lomont为此写下一篇论文,"Fast Inverse Square Root"。

给出了InvSqrt函数的定义:

float InvSqrt(float x)
{
  float xhalf = 0.5f * x;
  int i = *(int *)&x;
  i = 0x5f3759df - (i>>1);
  x = *(float *)&i;
  x = x * (1.5f - xhalf * x * x);
  return x;
}

本文参考自:

知乎Elb(字节跳动大力教育前端团队)-https://wjrsbu.smartapps.cn/zhihu/article?id=445813662&isShared=1&_swebfr=1&_swebFromHost=baiduboxapp

Views: 193
编写控制台游戏程序

现在让我们使用所学的知识完成一个游戏程序。这里我们将不使用任何图形界面,而是制作一个简单的、控制台上运行的字符界面的游戏。

需要注意Windows的控制台程序和Linux的控制台程序需要使用各自不同的方法来实现诸如光标移动,颜色设置等操作,下面分别讲解。

清屏

在Windows下控制台窗口的控制是基于win32 api, 就是那些在cmd下可以执行的命令, 使用之前需要引入头文件windows.h。

例如Windows下清除屏幕:

system("cls");

而在Linux下是通过Shell命令,只需要引入stdlib.h即可,比如要实现清除屏幕:

system("clear);

休眠

Window的控制台中休眠,可以调用windows.h中的Sleep(),比如Sleep(1000)函数,这里1000为毫秒数,功能为延时1s后程序向下运行,下面是一个3秒倒计时程序:

for(int i = 3; i >= 1; i--) {
  printf("%d\n", i);
  Sleep(1000);
}

Linux的控制台休眠可以使用stdlib.h中的system()调用Shell命令sleep n, 这里n代表秒数。

Linux下程序需要这样改写:

for(int i = 3; i >= 1; i--) {
  printf("%d\n", i);
  system("sleep 1");
}

windows控制台窗口操作API

Windows.h中定义的用于控制台窗口操作的API函数如下:

  • GetConsoleScreenBufferInfo 获取控制台窗口信息
  • GetConsoleTitle 获取控制台窗口标题
  • ScrollConsoleScreenBuffer 在缓冲区中移动数据块
  • SetConsoleScreenBufferSize 更改指定缓冲区大小
  • SetConsoleTitle 设置控制台窗口标题
  • SetConsoleWindowInfo 设置控制台窗口信息
#include <windows.h>
SetConsoleTitle("hello world!"); // 设置

由于Linux中往往不安装图形界面的,因此一般也不需要控制控制台窗口,这里就不介绍了。

控制台初始化

#include <iostream>
#include <windows.h>
using namespace std;

int main()
{
    //设置控制台窗口标题
    SetConsoleTitle("hello world!");

    //获取控制台窗口信息;
    //GetConsoleScreenBufferInfo(HANDLE hConsoleOutput, CONSOLE_SCREEN_BUFFER_INFO *bInfo)
    //第一个hConsoleOutput参数(标准控制句柄)通过GetStdHandle()函数返回值获得
    //第二个参数CONSOLE_SCREEN_BUFFER_INFO 保存控制台信息结构体指针
        /*数据成员如下:
        {
            COORD dwSize; // 缓冲区大小
            COORD dwCursorPosition; //当前光标位置
            WORD wAttributes; //字符属性
            SMALL_RECT srWindow; //当前窗口显示的大小和位置
            COORD dwMaximumWindowSize; //最大的窗口缓冲区大小
        }
        */
    HANDLE hOutput = GetStdHandle(STD_OUTPUT_HANDLE);
    CONSOLE_SCREEN_BUFFER_INFO bInfo;
    GetConsoleScreenBufferInfo(hOutput, &bInfo);
    cout << "窗口缓冲区大小:" << bInfo.dwSize.X << ", " << bInfo.dwSize.Y << endl;
    cout << "窗口坐标位置:" << bInfo.srWindow.Left << ", " << bInfo.srWindow.Top
         << ", "<< bInfo.srWindow.Right << ", " << bInfo.srWindow.Bottom << endl;

    //设置显示区域坐标
    //SetConsoleWindowInfo(HANDLE, BOOL, SMALL_RECT *);
    SMALL_RECT rc = {0,0, 79, 24}; // 坐标位置结构体初始化
    SetConsoleWindowInfo(hOutput,true ,&rc);
    cout << "窗口显示坐标位置:" << bInfo.srWindow.Left << ", " << bInfo.srWindow.Top
         << ", "<< bInfo.srWindow.Right << ", " << bInfo.srWindow.Bottom << endl;

    //更改指定缓冲区大小
    //SetConsoleScreenBufferSize(HANDLE hConsoleOutput, COORD dwSize)
    //COORD为一个数据结构体
    COORD dSiz = {80, 25};
    SetConsoleScreenBufferSize(hOutput, dSiz);
    cout << "改变后大小:" << dSiz.X << ", " << dSiz.Y << endl;

    //获取控制台窗口标题
    //GetConsoleTitle(LPTSTR lpConsoleTitle, DWORD nSize)
    //lpConsoleTitle为指向一个缓冲区指针以接收包含标题的字符串;nSize由lpConsoleTitle指向的缓冲区大小
    char cTitle[255];
    GetConsoleTitleA(cTitle, 255);
    cout << "窗口标题:" << cTitle << endl;

    // 关闭标准输出设备句柄
    CloseHandle(hOut);
    return 0;
}

设置文本颜色和光标移动控制

#include <iostream>
#include <windows.h>
using namespace std;
int main()
{
    /*设置文本属性
    BOOL SetConsoleTextAttribute(HANDLE hConsoleOutput, WORD wAttributes);//句柄, 文本属性*/

    HANDLE hOut = GetStdHandle(STD_OUTPUT_HANDLE); // 获取标准输出设备句柄
    WORD wr1 = 0xfa;//定义颜色属性;第一位为背景色,第二位为前景色
    SetConsoleTextAttribute(hOut, wr1);
    cout << "hello world!" << endl;

    WORD wr2 = FOREGROUND_RED | FOREGROUND_INTENSITY;//方法二用系统宏定义颜色属性
    SetConsoleTextAttribute(hOut, wr2);
    cout << "hello world!" << endl;

    /*移动文本位置位置
    BOOL ScrollConsoleScreenBuffer(HANDLE hConsoleOutput, CONST SMALL_RECT* lpScrollRectangle, CONST SMALL_RECT* lpClipRectangle,
                                   COORD dwDestinationOrigin,CONST CHAR_INFO* lpFill);
                                  // 句柄// 裁剪区域// 目标区域 // 新的位置// 填充字符*/
    //输出文本
    SetConsoleTextAttribute(hOut, 0x0f);
    cout << "01010101010101010101010101010" << endl;
    cout << "23232323232323232323232323232" << endl;
    cout << "45454545454545454545454545454" << endl;
    cout << "67676767676767676767676767676" << endl;

    SMALL_RECT CutScr = {1, 2, 10, 4}; //裁剪区域与目标区域的集合行成剪切区域
    SMALL_RECT PasScr = {7, 2, 11, 9}; //可以是NULL,即全区域
    COORD pos = {1, 8};     //起点坐标,与裁剪区域长宽构成的区域再与目标区域的集合为粘贴区

    //定义填充字符的各个参数及属性
    SetConsoleTextAttribute(hOut, 0x1);
    CONSOLE_SCREEN_BUFFER_INFO Intsrc;
    GetConsoleScreenBufferInfo(hOut, &Intsrc);
    CHAR_INFO chFill = {'A',  Intsrc.wAttributes}; //定义剪切区域填充字符
    ScrollConsoleScreenBuffer(hOut, &CutScr, &PasScr, pos, &chFill); //移动文本

    CloseHandle(hOut); // 关闭标准输出设备句柄
    return 0;
}

WORD文本属性预定义宏:(可以直接用16进制表示,WORD w = 0xf0;前一位表示背景色,后一位代表前景色)

FOREGROUND_BLUE 蓝色
FOREGROUND_GREEN 绿色
FOREGROUND_RED 红色
FOREGROUND_INTENSITY 加强
BACKGROUND_BLUE 蓝色背景
BACKGROUND_GREEN 绿色背景
BACKGROUND_RED 红色背景
BACKGROUND_INTENSITY 背景色加强
COMMON_LVB_REVERSE_VIDEO 反色

当前文本属性信息可通过调用函数
GetConsoleScreenBufferInfo后,在CONSOLESCREEN BUFFER_INFO结构成员wAttributes中得到。
在指定位置处写属性

BOOL WriteConsoleOutputAttribute(HANDLE hConsoleOutput, CONST WORD *lpAttribute, DWORD nLength, 
                                COORD dwWriteCoord, LPDWORD lpNumberOfAttrsWritten);
                                //句柄, 属性, 个数, 起始位置, 已写个数*/

填充指定数据的字符

BOOL FillConsoleOutputCharacter(HANDLE hConsoleOutput, TCHAR cCharacter,DWORD nLength, 
                               COORD dwWriteCoord, LPDWORD lpNumberOfCharsWritten);
                               // 句柄, 字符, 字符个数, 起始位置, 已写个数*/

在当前光标位置处插入指定数量的字符

BOOL WriteConsole(HANDLE hConsoleOutput, CONST VOID *lpBuffer, DWORD nNumberOfCharsToWrite,
                 LPDWORD lpNumberOfCharsWritten,LPVOID lpReserved);
                 //句柄, 字符串, 字符个数, 已写个数, 保留*/

向指定区域写带属性的字符

BOOL WriteConsoleOutput(HANDLE hConsoleOutput, CONST CHAR_INFO *lpBuffer, COORD dwBufferSize,
                       COORD dwBufferCoord,PSMALL_RECT lpWriteRegion );
                       // 句柄 // 字符数据区// 数据区大小// 起始坐标// 要写的区域*/

在指定位置处插入指定数量的字符

BOOL WriteConsoleOutputCharacter(HANDLE hConsoleOutput, LPCTSTR lpCharacter, DWORD nLength,
                                COORD dwWriteCoord, LPDWORD lpNumberOfCharsWritten);
                                // 句柄// 字符串// 字符个数// 起始位置// 已写个数*/

填充字符属性

BOOL FillConsoleOutputAttribute(HANDLE hConsoleOutput, WORD wAttribute,DWORD nLength,
                               COORD dwWriteCoord, LPDWORD lpNumberOfAttrsWritten);
                               //句柄, 文本属性, 个数, 开始位置, 返回填充的个数*/

设置代码页,代码页是字符集编码的别名,也有人称"内码表"。

SetConsoleOutputCP(437);
//如(简体中文) 设置成936

光标操作控制

#include <iostream>
#include <windows.h>
using namespace std;
int main()
{
    cout << "hello world!" << endl;

    //设置光标位置
    //SetConsoleCursorPosition(HANDLE hConsoleOutput,COORD dwCursorPosition);
    //设置光标信息
    //BOOL SetConsoleCursorInfo(HANDLE hConsoleOutput, PCONST PCONSOLE_CURSOR_INFO lpConsoleCursorInfo);
    //获取光标信息
    //BOOL GetConsoleCursorInfo(HANDLE hConsoleOutput,  PCONSOLE_CURSOR_INFO lpConsoleCursorInfo);
    //参数1:句柄;参数2:CONSOLE_CURSOR_INFO结构体{DWORD dwSize;(光标大小取值1-100)BOOL bVisible;(是否可见)}

    Sleep(2000);//延时函数
    HANDLE hOut = GetStdHandle(STD_OUTPUT_HANDLE);
    COORD w = {0, 0};
    SetConsoleCursorPosition(hOut, w);
    CONSOLE_CURSOR_INFO cursorInfo = {1, FALSE};
    Sleep(2000);//延时函数
    SetConsoleCursorInfo(hOut, &cursorInfo);
    CloseHandle(hOut); // 关闭标准输出设备句柄
    return 0;
}

键盘操作控制

#include <iostream>
#include <windows.h>
#include <conio.h>
using namespace std;
HANDLE hOut;
//清除函数
void cle(COORD ClPos)
{
    SetConsoleCursorPosition(hOut, ClPos);
    cout << "            " << endl;
}
//打印函数
void prin(COORD PrPos)
{
    SetConsoleCursorPosition(hOut, PrPos);
    cout << "hello world!" << endl;
}
//移动函数
void Move(COORD *MoPos, int key)
{
    switch(key)
    {
    case 72: MoPos->Y--;break;
    case 75: MoPos->X--;break;
    case 77: MoPos->X++;break;
    case 80: MoPos->Y++;break;
    default: break;
    }
}

int main()
{
    cout << "用方向键移动下行输出内容" << endl;
    hOut = GetStdHandle(STD_OUTPUT_HANDLE);//取句柄
    COORD CrPos = {0, 1};//保存光标信息
    prin(CrPos);//打印
    //等待键按下
    while(1)
    {
        if(kbhit())
        {
            cle(CrPos);//清除原有输出
            Move(&CrPos, getch());
            prin(CrPos);
        }
    }
    return 0;
}

可以用方向键任意移动hello world!

注意区分:

getch()、 getche()、getcher()函数

Linux下控制台操作替代办法

字体颜色

在 Linux 下若想输出 类似与 Windows 下的多颜色字体如何做呢?本文就来介绍实现的方法。
首先,来看下 在Linux 下颜色的表示

注意自定义的配置需在写在\033[和m之间

\033[22;30m - black
\033[22;31m - red
\033[22;32m - green
\033[22;33m - brown
\033[22;34m - blue
\033[22;35m - magenta
\033[22;36m - cyan
\033[22;37m - gray
\033[01;30m - dark gray
\033[01;31m - light red
\033[01;32m - light green
\033[01;33m - yellow
\033[01;34m - light blue
\033[01;35m - light magenta
\033[01;36m - light cyan
\033[01;37m - white

可以看出都是使用的转义字体来实现的。
比如:
Linux 终端输入:echo -e "\033[35;1m Shocking \033[0m"
C代码: printf("\033[34mThis is blue.\033[0m\n");
是不是出错不同的颜色了,记得最后要 "\033[0m" 关闭所有属性,这样又回到了系统默认的颜色了。

一个定义宏的办法如下:([0;是用来清除之前或之后的设置)

#define COLOR(msg, code) "\033[0;1;" #code "m" msg "\033[0m"
#define RED(msg)    COLOR(msg, 31)
#define GREEN(msg)  COLOR(msg, 32)
#define YELLOW(msg) COLOR(msg, 33)
#define BLUE(msg)   COLOR(msg, 34)

光标控制

Linux 下终端 C 语言控制光标的技巧

// 清除屏幕
#define CLEAR() printf("\033[2J")

// 上移光标
#define MOVEUP(x) printf("\033[%dA", (x))

// 下移光标
#define MOVEDOWN(x) printf("\033[%dB", (x))

// 左移光标
#define MOVELEFT(y) printf("\033[%dD", (y))

// 右移光标
#define MOVERIGHT(y) printf("\033[%dC",(y))

// 定位光标

#define MOVETO(x,y) printf("\033[%d;%dH", (x), (y))

// 光标复位

#define RESET_CURSOR() printf("\033[H")

// 隐藏光标

#define HIDE_CURSOR() printf("\033[?25l")

// 显示光标

#define SHOW_CURSOR() printf("\033[?25h")

//反显

#define HIGHT_LIGHT() printf("\033[7m")

#define UN_HIGHT_LIGHT() printf("\033[27m")

模拟按键监听

windows平台接受字符并不回显可以调用<conio.h>库的getch函数, 但是这是依赖于windows的BIOS。
linux下可以使用命令stty -echo来关闭回显,当接受字符后,使用stty echo命令恢复设置即可.

linux下如何向windows的getch或者getche一样,不需要回车就可以接受字符?
这里可以使用命令raw开启一次接受一个字符的模式,接受字符后,再次使用cooked(回车之后一锅端模式)模式即可

#include <stdio.h>
#include <stdlib.h>
#define ENTER_KEY 13
#define ESCAPE_KEY 27

char getch()
{
    char ch;
    system("stty -echo raw");
    ch = getchar();
    system("stty echo cooked");
    return ch;
}

int main(int argc, char *argv[])
{
    char ch;

    system("clear\n");
    while (1)
    {
        printf("Press Enter to continue, ESC to exit\n");
        ch = getch();
        if (ch == ESCAPE_KEY)
            break;
        if (ch == ENTER_KEY)
        {
            printf("Input a character\n");
            ch = getch();
            printf("=%c\n", ch);
        }
    }

    return 0;
}

Hangman 猜词游戏

我们将从构建经典的猜词游戏,需要有两个玩家,一个玩家负责出题,另一个玩家负责猜。如果你从来没有听过这个游戏,

规则

  1. 在给定的选词范围内,比如"动物"或""国家",玩家一选择一个秘密单词并根据字母数画相应数量的短横,即“”,短横用来表示单词中的每个字母。比如秘密单词是"cat"则可以用" "表示。

  2. 游戏开始后,玩家二猜一个字母,玩家一判断这个字符是否在秘密单词中出现,如果出现则将对应位置的短横替换成正确的字符。比如猜的是a,则表示成_ _ a。

  3. 如果玩家二猜错了字母,玩家一会逐步从上到下的完成一副小人上吊的图像,如果玩家2在完整的图像被画出来之前猜出来秘密单词的所有字母他就赢了,否则当完整的图像画出来之后,小人的脚离开地面就预示着玩家二输了。

    第1次猜错

    ________   

    第2次猜错

    ________   
    |      |   

    第3次猜错

    ________   
    |      |   
    |      0   

    第4次猜错

    ________   
    |      |   
    |      0   
    |     /|\  

    第5次猜错

    ________   
    |      |   
    |      0   
    |     /|\  
    |     / \  

    第6次猜错,小人脚离地,玩家二输了,游戏结束

    ________   
    |      |   
    |      0   
    |     /|\  
    |     / \  
    |          
  4. 如果玩家在小人脚离地之前猜出了所有字母,例如 c a t.则玩家二获胜。

注意:以下代码是在linux环境中运行:

游戏的初始化
// 初始化词库
char words[5][100] = {"china", "japan", "india", "korea", "syria"};
// 初始化词库的数量
int words_num = sizeof(words) / sizeof(words[0]);
// 初始化要猜的词
char secret_word[100] = "";
// 初始化要猜的词的字母数
int secret_word_len = 0;
// 显示的题板, 未猜出的字母用_代替
// 打印的上吊小人的画像
char stages[][15] = {"  ________    ",   // stage 1
                     "  |      |    ",   // stage 2
                     "  |      0    ",   // stage 3
                     "  |     /|\\  ",   // stage 4
                     "  |     / \\  ",   // stage 5
                     "  |________   "};  // stage 6
int stage_num     = sizeof(stages) / sizeof(stages[0]);
// 初始化猜错的次数
int wrong_guess = 0;
// 初始化是否赢得游戏
bool win = false;

// FUNCTION PROTOTYPES
void PrintBoard(int stage);
void StartGame();
char getch();

int main(int argc, char *argv[]) {

    // init
    srand((unsigned int)time(NULL));
    int random_index = rand() % words_num;
    strcpy(secret_word, words[random_index]);
    secret_word_len = strlen(secret_word);

    StartGame();
    return 0;
}
玩法部分

游戏的玩法部分封装到了StartGame函数中,玩法部分通常是个循环


// GAME LOOP
while (wrong_guess < stage_num) {
...
}

判断是否猜中

char *find_pos = strstr(remaining_letters, guess);
if (find_pos != NULL) {
    int pos                = find_pos - remaining_letters;
    remaining_letters[pos] = '$';
    letter_board[pos]      = guess[0];
}
else {
    wrong_guess++;
    PrintBoard(wrong_guess);
    system("sleep 1");
}

如果输了就打印上吊图像


void PrintBoard(int stage) {
    for (int i = 0; i < stage_num; i++) {
        if (i < stage)
            printf("%s\n", stages[i]);
        else
            puts("");
    }
}

练习

你也可以试着完成一个属于你自己的控制台小游戏, 多花些时间做些类似的练习可以帮助你提高编程能力,同时也能让你对编程保持兴趣。

我还记得在DOS时期(95年左右)我第一个使用QuickBasic语言制作的猜飞机头的游戏,虽然是简单的游戏但是最终被我制作的越来越复杂,比如增加关卡,添加声效,游戏记录的保存等,可惜是存储在软盘中现在已经遗失了。

  • 三子棋或者五子棋游戏

  • 根据心情选歌

  • 根据品牌打印广告语。

寻求帮助

如果你写代码时卡壳,大多数的问题通过百度都可以解决,不行的话就CSDN或者知乎。

如果英文水平不赖就科学上网去谷歌搜索,这里要强调的是浏览Stack Exchange这个神奇的网站会很有帮助。有两个版块非常有用。

一个是Stack Overflow,程序员应该没有不知道它的,上面几乎涵盖所有编程可能遇到的问题。即便你的问题是独一无二其他人都没有经历过的,这是一个QA类型的网站,你可以在上面发布问题,会有大佬帮你解答的。

https://www.codementor.io/ama/0926528143/stackoverflow-python-moderator-martijn-pieters-zopatista

http://programmers.stackexchange.com/questions/44177/what-is-the-single-most-effective-thing-you-did-to-improve-your-programming-skil

另外一个有用的板块叫Code Review, 你只要发布你的代码就会有人给你"指手画脚", 告诉你哪些地方做的好,哪些地方做的不好,如何改进之类的建议。

Views: 43

CH-02 编程准备

为什么学习C语言

  1. 操作系统编程
    • 内存管理、服务器
  2. 操作系统设计
    • 大部分系统使用C语言实现
  3. 网络协议实现
    • 局域网、互联网数据传输
  4. 物联网和嵌入式编程
    • Linux编程
  5. 实现其他语言
    1. 解释形
      • 解析器实现大多数都是C/C++
    2. 编译型
      • 高效率编译器的实现也离不开C语言

C语言历史

为了玩游戏编写了一套操作系统

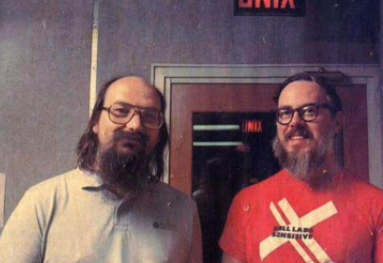
C 语言的产生,还是有一些故事的。在很久很久以前,那个时期的计算机系统还处在批处理阶段,技术不发达导致了运算速度十分缓慢,也使得程序员工作效率低下。当时他们只能在运算速度缓慢笨重的大型机器上工作,操作也十分繁琐:需要先将程序卡片装入设备,然后等一个多小时才能获取运算结果。……在知名的贝尔实验室,有一个叫 Ken Thompson 和另一个叫 Dennis M. Ritchie 的工程师,他们被共同称为“C 语言之父”。
file
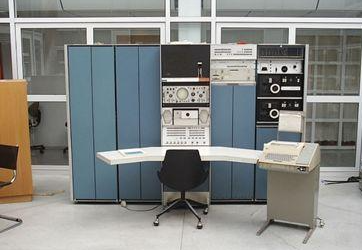
他们为了在实验室角落里一台 PDP-7 小型机上写一个让自己可以不用花多少钱就可以玩的《星际旅行(Star Travel)》的游戏,用汇编语言编写了一个操作系统,并把这个系统命名成了 Unix。
file
后面又出现了B语言替代了汇编,因为B语言编写的程序无法移植到其他类型的机器上,当PDP-11出来后,为了将PDP-7上的B语言移植到PDP-11上又开发了NB语言,这就是C语言的前身,1972年NB语言改名为C语言。在1973年Dennis和Ken一起使用C语言重写了Unix系统。

file

file

后又有大神Linus

Early C

  • 1969: B created, based on BCPL, to replace PDP-7 assembler as the system programming language for Unix
  • 1971: NB ("new B") created when porting B to PDP-11
  • 1972: Language renamed to C
  • 1973: Unix re-written in C
  • 1978: The C Programming Language, 1st edition

Standard C

  • 1988: The C Programming Language, 2nd edition
  • 1989: C89, the ANSI C standard published
  • 1990: C90, the ANSI C standard accepted as ISO/IEC 9899:1990
  • 1995: C95 (ISO/IEC 9899:1990/Amd.1:1995) (online store)
  • 1999: C99 (ISO/IEC 9899:1999)
  • 2011: C11 (ISO/IEC 9899:2011) (ISO store) (ANSI store) (April 12, 2011 draft)
  • 2018: C17 (ISO/IEC 9899:2018) (ISO Store) (Final draft)
  • 2023: C23 Next major C language standard revision

环境准备

C 语言即可以在Windows、也可以在macOS(Unix内核)或者Linux(类Unix)上进行开发, 需要注意平台之间的差异, 例如Windows环境下的一些库文件和函数有些"特立独行", 除了系统的差异, 也存在编译工具的差异,例如微软平台下的宇宙第一IDE的Visual Studio与其他IDE相比就存在明显的区别。

C 语言在 Unix 上被设计出来,也被基于 Unix 的操作系统更好地支持。如果你希望更顺利地学习 C 语言,使用基于 Unix 的操作系统将会是很好的选择。同时,多数情况下你将会需要使用命令行工具来进行操作。

Windows环境配置

一般IDE会自带编译环境。你也可以选择使用自己的编译环境,一般Windows上常用的C/C++编译环境是MinGW(Minimalist GNU for Windows)。为了安装 MinGW,请访问 MinGW 的主页 ,进入 MinGW 下载页面,下载最新版本的 MinGW 安装程序,命名格式为 MinGW-.exe。

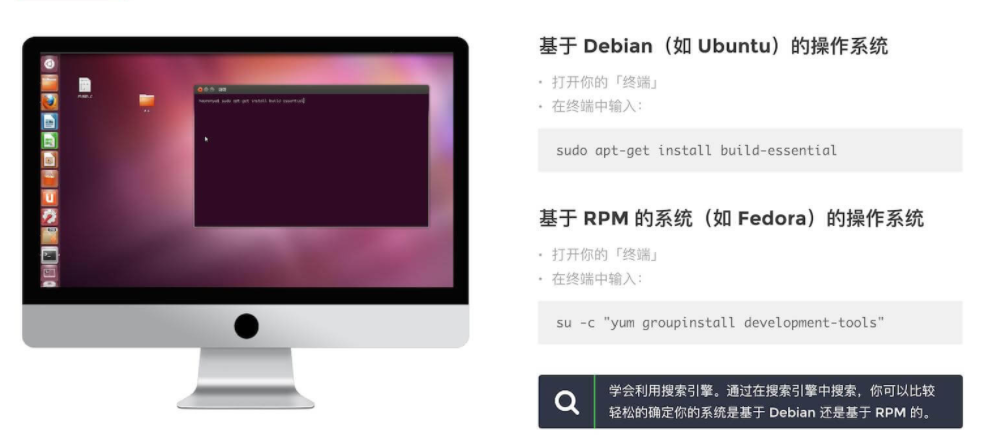
Linux环境配置

file

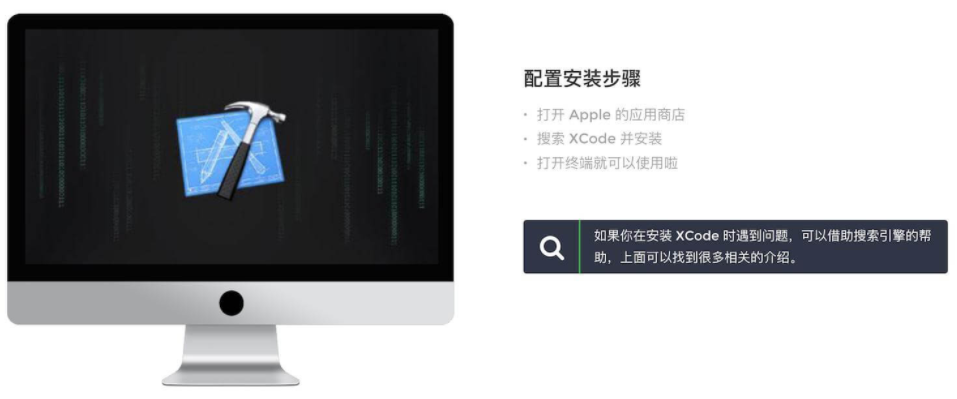
macOS环境配置

file

文本编辑器和IDE选择

对于程序语言的初学者来说,不要轻易地使用太复杂的IDE(integrated development environment,集成式开发环境),如:

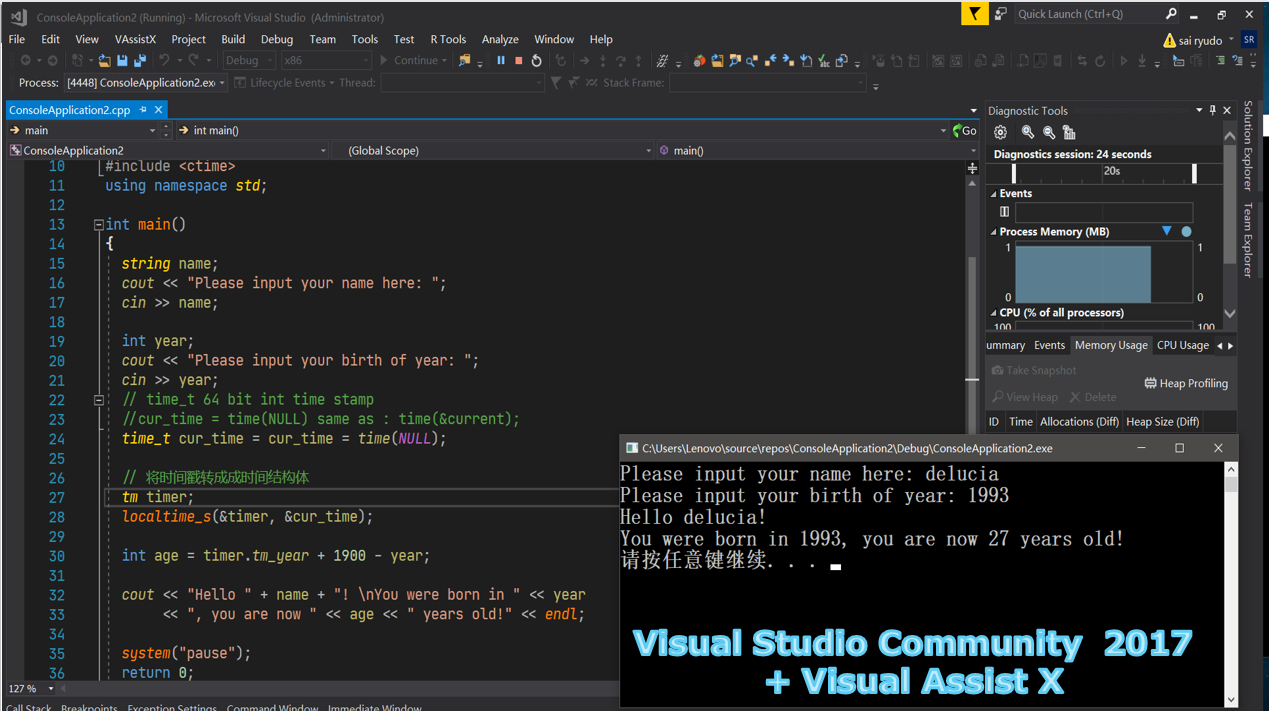
  • Visual Studio Conmmunity(IDE)
    file

  • Visual Studio Code(IDE)
    file

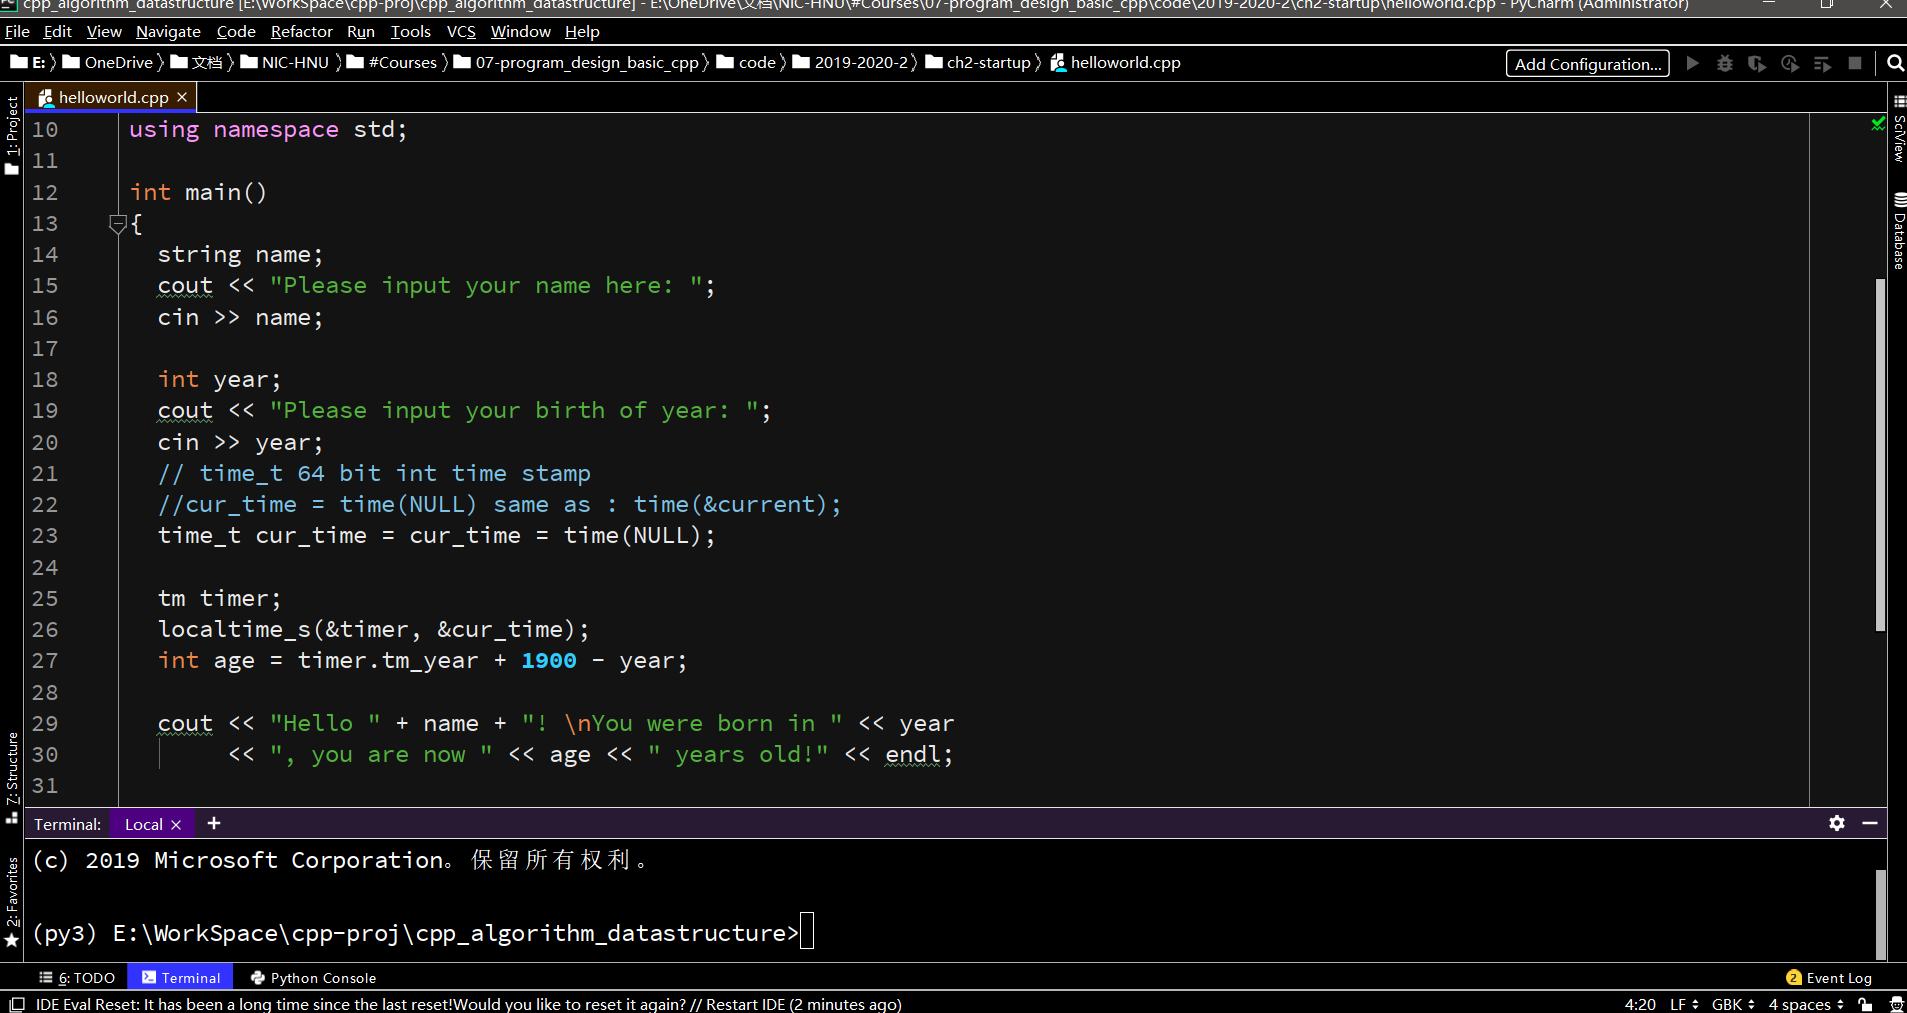
  • JetBrain CLion
    file

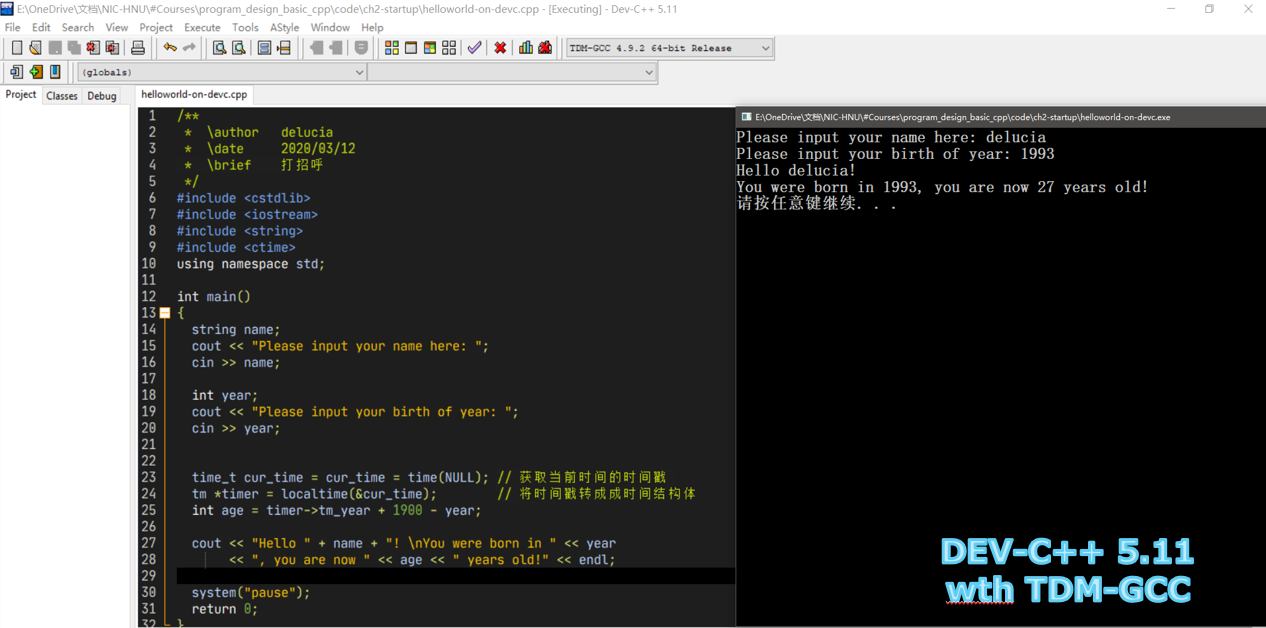
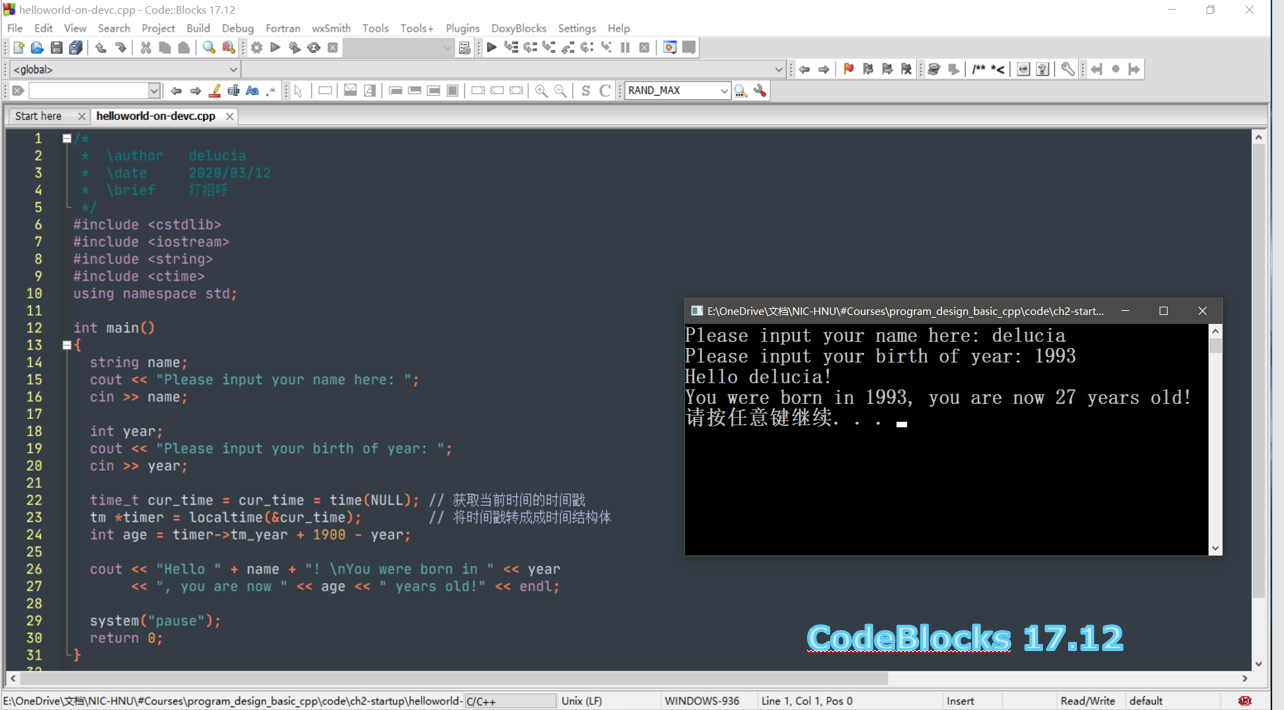
因为IDE 会隐藏很多本来应该让你学习到的知识,如果坚持要使用 IDE,对于初学者推荐你使用 Dev C++ 或 Code::Blocks 这种相对轻量的 IDE),像VC6.0这种古老的IDE就不推荐使用了。

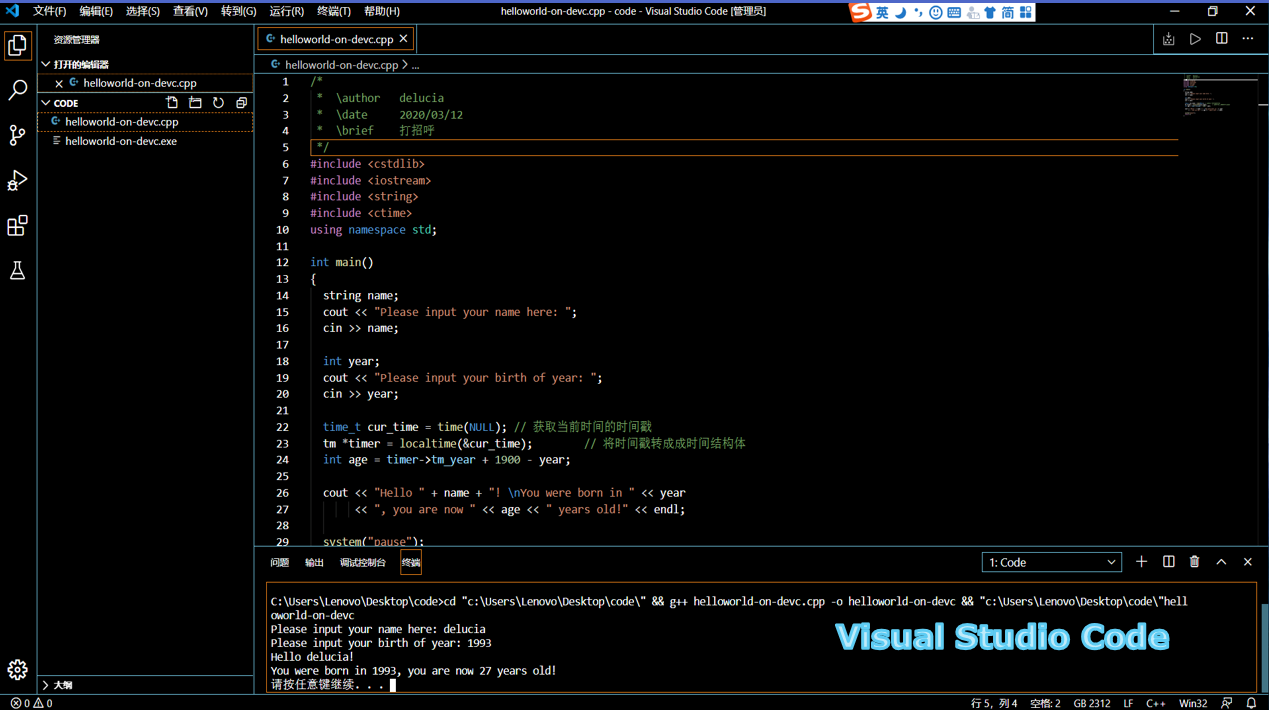
  • Dev-C++(IDE)
    file

  • Code Blocks(IDE)
    file

也推荐使用 Atom、Sublime、NotePad++、Gedit、Nano、Emacs、Vim 这些编辑器,其中Vim、Atom、Sublime经过适当的配置也是可以达到接近IDE的效果的。如果可能,你都可以试一试,找到你最顺手的那个。

  • Sublime
    file

  • Vim(Editor)
    file

Windows系统运行Linux

  1. 运行Linux虚拟机
    • VMwareStation/VirtualBox
    • Centos 7
  2. 运行WSL(WindowSubLinux)
    • Win10

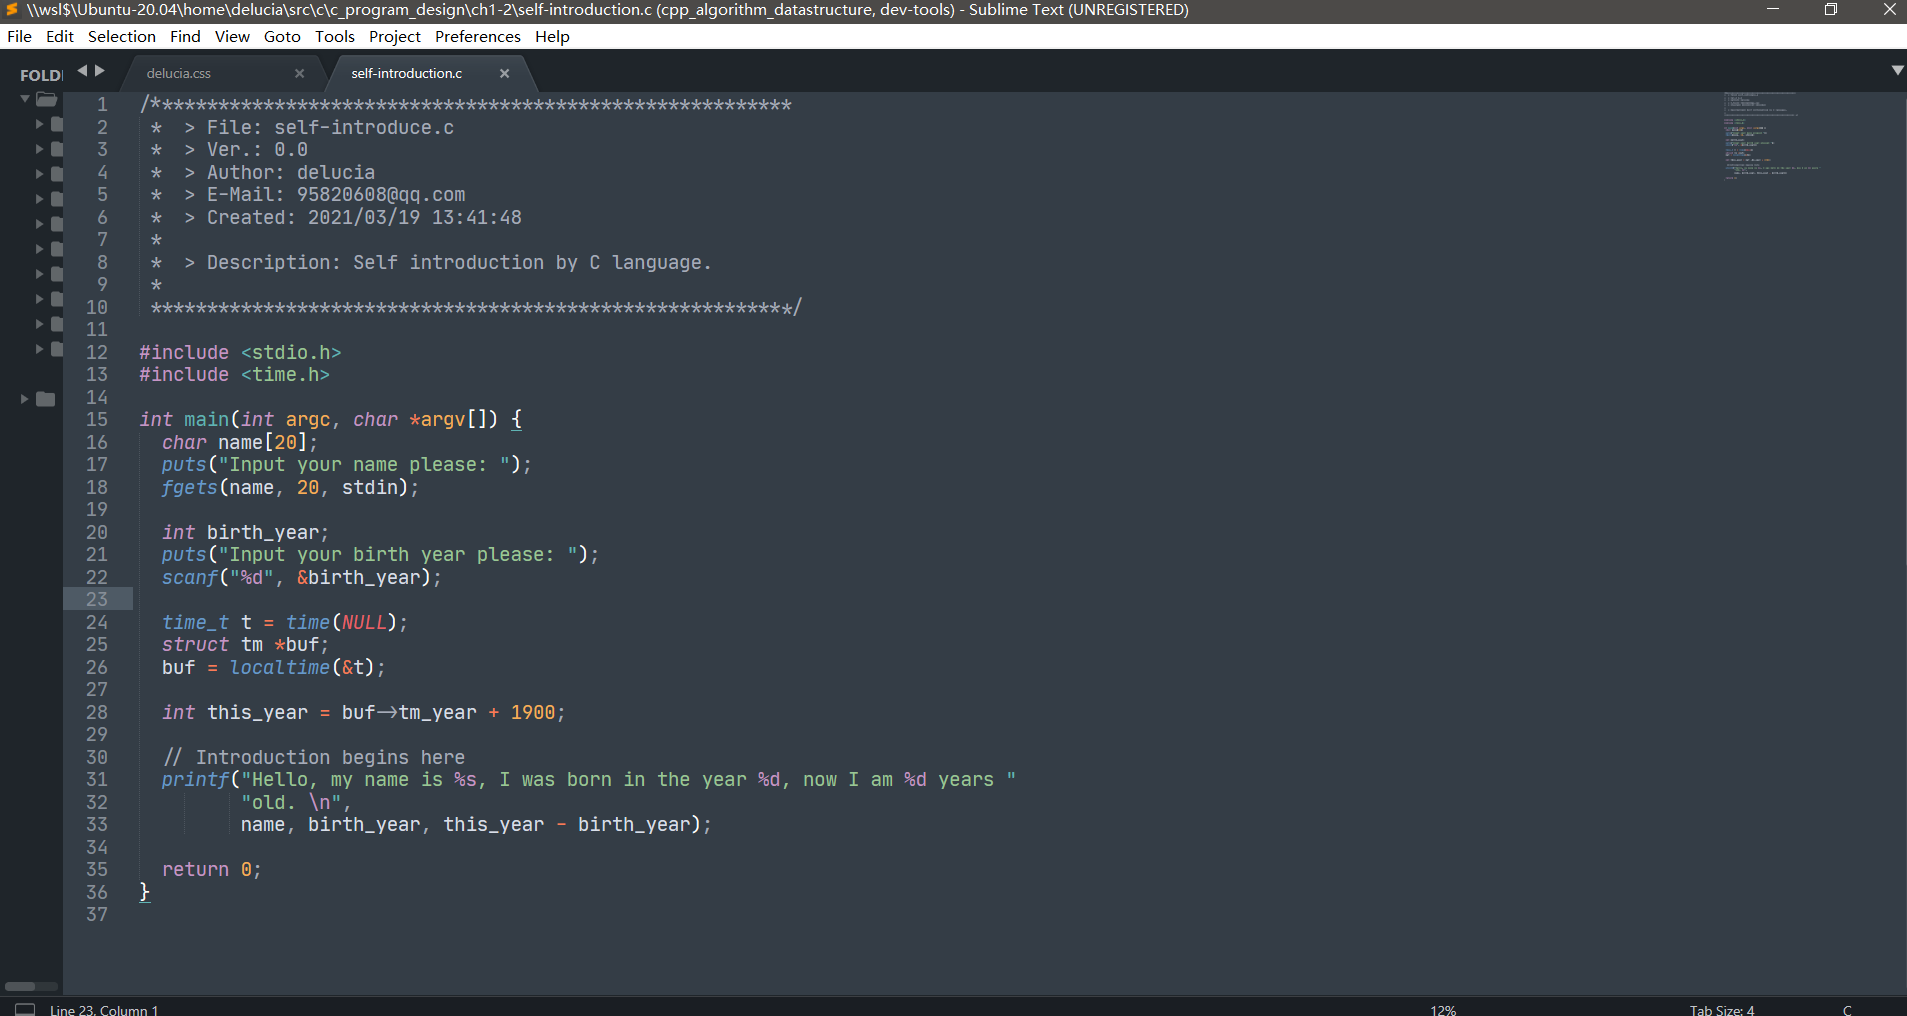
Hello World 程序代码及说明

C语言版本

#include <stdio.h>
int main()
{
    printf("hello, world!\n");
    return 0;
}
  • #编译预处理行
  • #include文件预处理命令 - 包含文件
  • #include<stdio.h>让C语言负责标准输入输出流库的头文件包含到此处
  • main()主函数,代表程序的执行入口, 主函数有一个整数返回值
  • printf()格式化输出函数, 声明自stdio.h头文件
  • return 0;退出main()函数,向调用线程返回执行结果(返回0代表程序正常退出, 返回非0代表异常退出).

C++语言版本

C++介绍
从C++(读作 C Plus Plus)的名字看, 就知道它比标准C多出太多东西了, C几乎是C语言的超集, 但也有少量特性是C所不支持的。C++ 比 C 多了 classes、templates、exceptions 这些部分,而每个部分也有很多新增的东西。这还只是语言部分,还未谈及标准库。C 有 29 个标准库头文件,C++ 有 87 个,除了量,C++ 标准库的功能要复杂得多。是目前最难掌握也是最为复杂的语言。

我们课程学习所使用的C++只用到C++特性中最简单的部分,并且不涉及面向对象、模板、异常等复杂的部分。

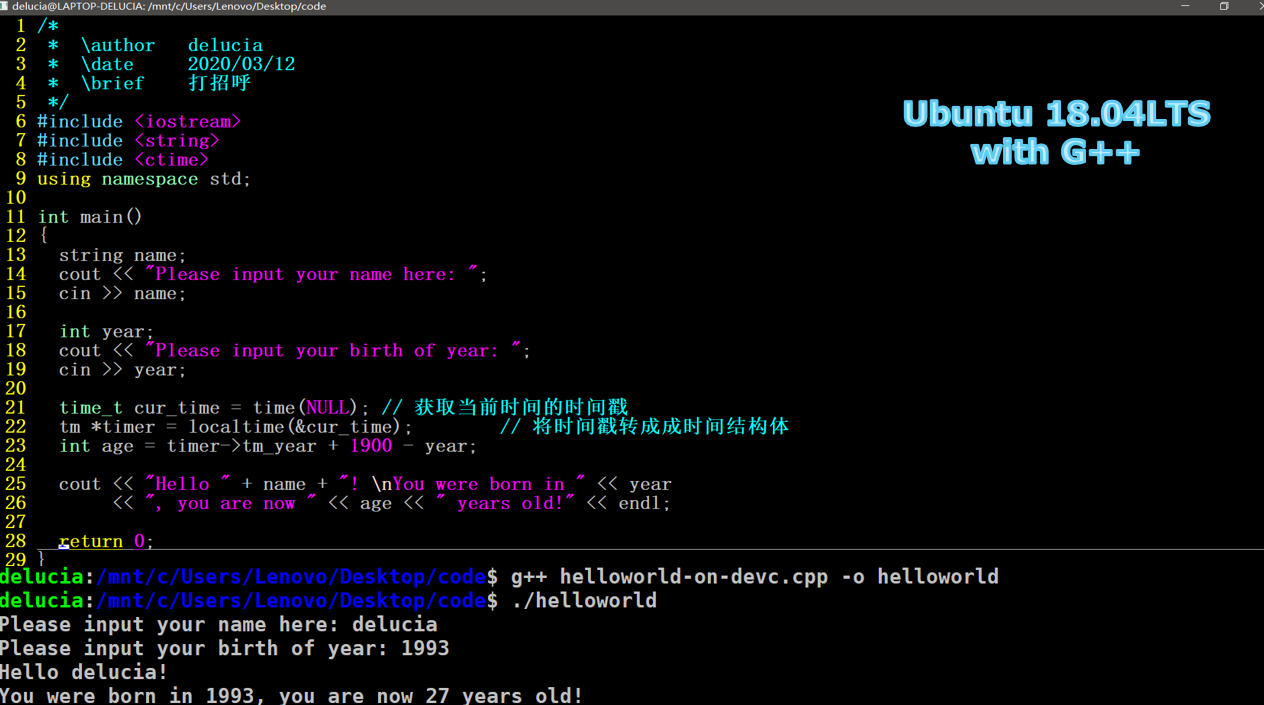
编写C++的hello world程序很简单, 注意后缀使用cpp或者cc, 表示这是C++的源代码文件.

#include <iostream>
using namespace std;

int main()
{
  cout << "hello world" << endl;
  return 0;
}
  • iostream C++定义的输入输出流库, 定义了输入流对象cin和输出流对象cout对象
  • using namespace std;使用std命名空间, 命名空间用于避免命名冲突问题, std是C++自带的名称空间, 其种cout,cin和endl都位于这个名称空间下.
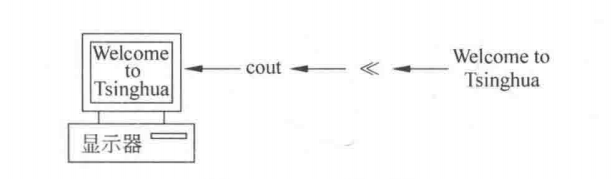
  • cout是iosteam库中ostream类型对象,用于将<<右侧的内容输出到显示屏
  • endl是iostream库中定义的IO操纵符,表示换行并刷新流

GCC

GCC:GNU Compiler Collection(GUN 编译器集合),它可以编译C、C++、Java、Fortran、Pascal、Object-C、Ada等语言。

  • gcc是GCC中的GUN C Compiler(C 编译器)
  • g++是GCC中的GUN C++ Compiler(C++编译器)

gcc和g++的主要区别

  1. 对于 .c和.cpp文件,gcc分别当做c和cpp文件编译(c和cpp的语法是不一样的)
  2. 对于 .c和.cpp文件,g++则统一当做cpp文件编译
  3. 使用g++编译文件时,g++会自动链接标准库STL,而gcc不会自动链接STL

主要参数

-g - turn on debugging (so GDB gives morefriendly output)
-Wall - turns on most warnings
-O or -O2 or -O3 - turn on optimizations level 1~3
-o - name of the output file
-c - output an object file (.o)
-I - specify an includedirectory
-L - specify a libdirectory
-l - link with librarylib.a

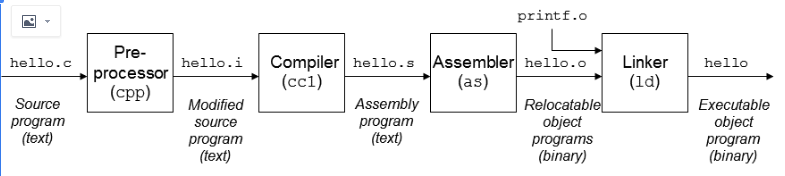
GCC编译的4个阶段

file

  1. 预处理阶段:预处理器(cpp)

    $ gcc -E hello.c -o hello.i
    # 加上-P可以生成内容弄个更精简的文件
    $ gcc -E -P hello.c -o hello.i

    预处理阶段主要做的事情是:

    • 删注释
    • 替换宏定义
    • 替换#inlcude文件
  2. 编译阶段:编译器(ccl)

    $ gcc -S hello.i -o hello.s

    编译器将预处理的文件编译成汇编指令。

  3. 汇编阶段:汇编器(as)

    $ gcc -c hello.s -o hello.o

    汇编器将汇编指令转换为二进制目标文件。
    也可以把汇编和链接阶段合称为编译阶段,生成的.o目标文件可以使用nm命令列出所有符号,其中U表示的是未定义的符号。

    
    ➜ nm hello.o
                  U _GLOBAL_OFFSET_TABLE_
    0000000000000000  T main
                  U puts
  4. 链接阶段:链接器(ld)

    $ gcc hello.o -o hello

    也可以使用-save-tmps选项保存中间生成的临时文件,如:

    ➜ gcc -Wall -save-temps hello.c -o hello
    ➜ ls
    hello hello.c  hello.i  hello.o  hello.out  hello.s
    • -Wall 显示所有编译警告信息

如果编译成功,我们在同一个目录下可以得到一个编译后的可以执行的hello文件,可以在同一目录下使用./hello命令运行。

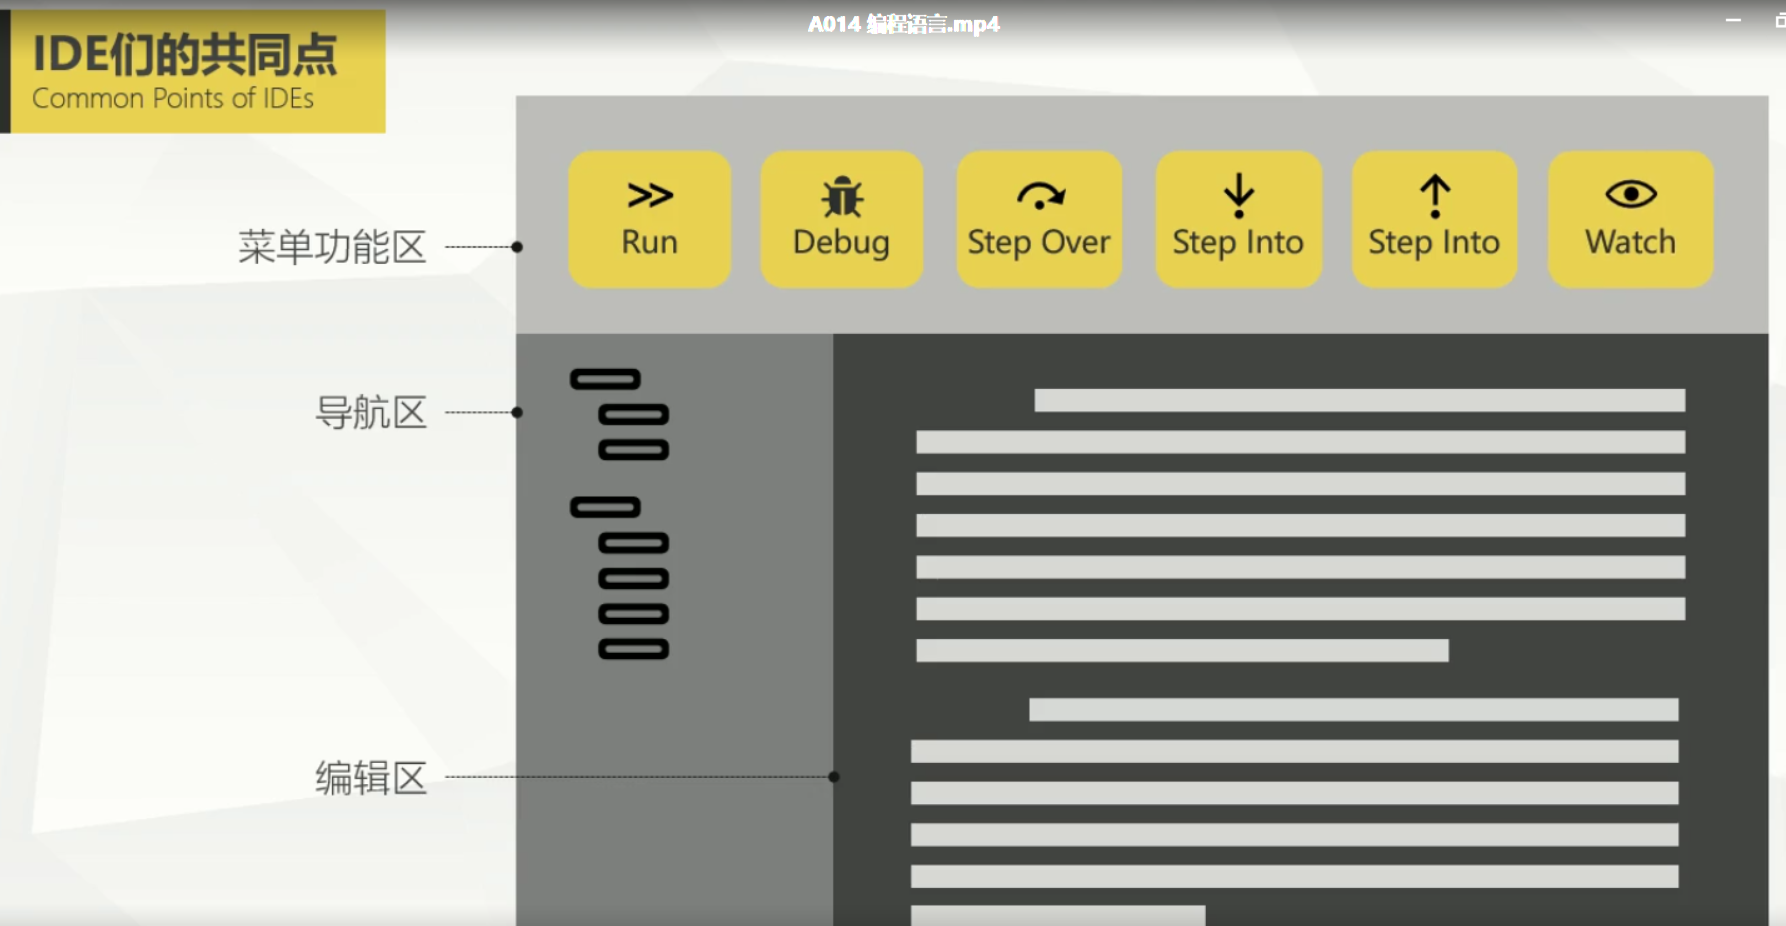
如果你选择了使用 IDE,你需要了解一下自己的 IDE 的编译和运行功能被设计成了什么样的菜单选项或按钮。每次先编译,确认编译通过后再运行。

file

输出流对象cout

cout 是C++中 ostream 类型的对象,该类被封装在 <iostream> 库中,该库定义的名字都在命名空间 std 中,所以 cout 全称是 std::cout 。

cout使用方式

  • std::cout
    std::cout << "Welcome to Tsinghua" << std::endl;
  • 使用 std 命名空间后,简写成 cout
    use namespace std;
    ......
    cout << "Welcome to Tsinghua" << endl;

file

算术运算符

C/C++支持5种常见的算术运算符(operator),分别是:

  • + 加
  • - 减
  • * 乘
  • / 除
  • % 取余(取模)

除了取余运算符要求两边的操作数(operand)是整数外,其余加、减、乘、除运算要求两边操作数是实数即可。

数学函数

/*
计算 sin(20°) + cos(20°) - cos(20°) / tan(20°)
需要引入cmath库的三角函数, 参数单位为弧度
弧度与角度之间的转换公式:
弧度=角度 /180 × π
*/
#include <iostream>       // 预编译 - io流库 - 输入输出
#include <cmath>          // 预编译 - cmath库 - 三角函数
using namespace std;      // 使用命名空间

int main() {    // 主函数
    const float PI = 3.14159;
    printf("%f \n", sin(30.0 / 180 * PI));
    cout << sin(20.0 / 180 * PI) +
        cos(20.0 / 180 * PI) -
        cos(20.0 / 180 * PI) /
        tan(20.0 / 180 * PI)
        << endl;
    return 0;       // 返回0 代表程序正常结束
}

注意,上面程序30.0/180如果改成30/180则结果为0,这时因为计算时发生了隐式类型转换

其他常用数学函数

****************************************
Author: Delucia
Ver.:   0.0
Date:   2020年1月5日01:06:14
Description:
附录B - 库函数  B.1数学函数
弧度转角度 2π = 360°
正弦函数, 参数x为弧度值 - double sin (double x)
*****************************************/

#include <iostream>
#include <cmath>
#include <cstdlib>

using namespace std;

int main()
{
  // 对不同类型的 n, 计算 |n|
  cout << abs(-4294967295) << endl;
  cout << labs(-4294967296L) << endl;
  cout << fabs(-3.1415926535) << endl;

  // sin 90 = 1
  cout << sin(3.1415926/2.0) << endl;
  cout << asin(1) << endl;

  cout << cos(3.1415926535/2.0) << endl;
  cout << acos(4.48966e-011) << endl;
  cout << tan(45.0*3.1415926535/180.0) << endl;
  cout << atan(1) << endl;

  cout << exp(1) << endl;
  cout << exp(2.302585093) << endl;

  cout << log(exp(1)) << endl;
  cout << log10(10) << endl;

  cout << pow(2.0, 3.0) << endl;
  cout << sqrt(25.0) << endl;

  cout << floor(4.8) << endl;
  cout << floor(-4.8) << endl;

  return 0;
}

注释

文件头注释

//***************************************
// FileName: 2-4-1comments.cpp          *
// Author: Delucia                      *
// Date: 2020年1月4日20:13:03           *
// Description: How to use Comments     *
//***************************************

int main()
{
    return 0;
}

单行注释

// 被注释的行

多行注释

/*
被注释的行
被注释的行
/*
  • 编程初学者尽量多写注释
  • 有经验的程序员会尽量让代码达到自解释效果,只对必要的地方写上注释
  • 建议养成写注释的习惯(难)

作业

file

将上面练习改写为C++的版本,并手动编译运行.

学习资源参考

  • NIIT云课堂
  • 慕课网(imooc)
  • 网易云课堂

学习文档资源参考

  • Google/Baidu
  • StackOverFlow
  • GitHub
  • CSDN
  • 菜鸟教程
  • Cpp Reference

Views: 56

CH-01 绪论

学科介绍

软件工程

  • 2012年升级为教育部一级专业
  • 软件工程是指大型复杂计算机软件系统设计、开发、测试、维护的工程学科。

培养全栈工程师

  • 掌握软件开发过程的全链路技术
  • 注重实操
  • 不局限一门语言,重点学会编程思维
  • 使用编程解决生活中的一些问题
  • 对算法和数据结构有简单了解

教材

《程序设计基础(第四版)》 - 清华大学出版

主要章节

  1. 绪论
  2. 编程准备
  3. 代数思维与计算机解题
  4. 逻辑思维与计算机解题
  5. 函数思维与模块化设计
  6. 数据的组织与处理(1)- 数组
  7. 数据的组织与处理(2)- 结构
  8. 数据的组织与处理(3)- 文件
  9. 递归思想和相应算法

次要章节(有时间就讲的内容)

  1. 多步决策问题
  2. 宽度优先搜索
  3. 深度优先搜索
  4. 贪心法
  5. 动态规划
  6. 蒙特卡罗法

附录

A. 程序调试
B. 库函数
C. ASCII码表
D. 输入输出的格式控制

要求

  • 经过这门课程的学习,对于简单的程序,应可以做到纸笔编程, 学会快速构思程序结构, 积累经验避开常见的“坑”
  • 对于稍微复杂的程序使用IDE编程, 需要掌握一般调试手段。

考核

本门课程为理论课程,另外有实验课安排。

  • 平时成绩 40% - 考勤、答疑、测试、作业
  • 期末考试 60% - 机考 或者 试卷 (试题为标准C语言)

行业分析

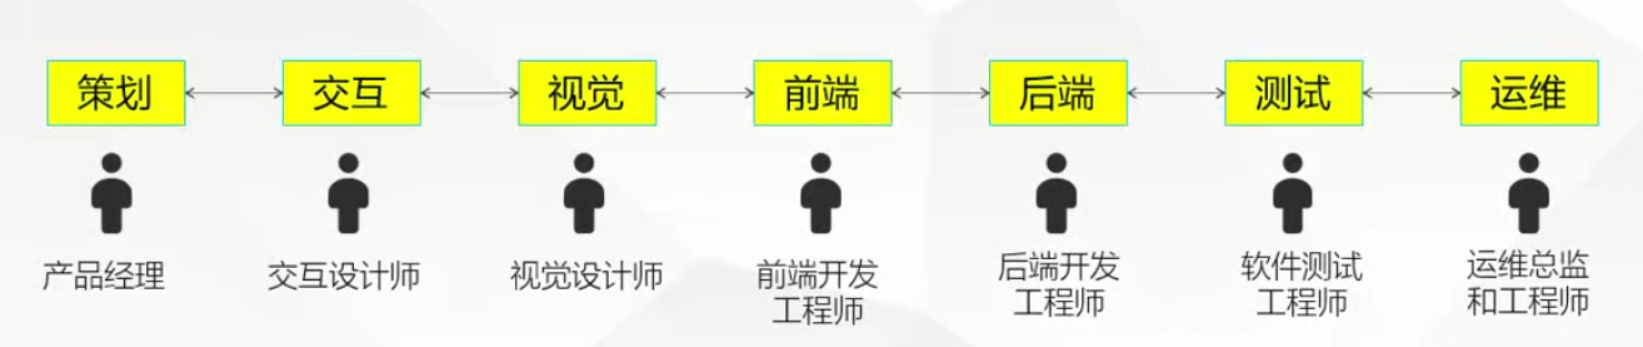
IT行业岗位主要分为研发岗、市场岗、管理岗、技术支持岗。

研发岗位

对于软件开发的研发岗来说,又可细分为:

  • RD
    Research and Development engineer,研发工程师,对某种不存在的事物进行系统的研究和开发并具有一定经验的专业工作者,或者对已经存在的事物进行改进以达到优化目的的专业工作者。
  • PM
    Product Manager,产品经理,又称品牌经理。举凡产品从创意到上市,所有相关的研发、调研、生产、编预算、广告、促销活动等等,都由产品经理掌控。
  • QA
    Quality Assurance,品质保证。QA的主要职责就是质量保证工作。
  • OP
    Operator,运维操作员,服务器、数据库管理员。

file

其中由于产品经理与设计、开发工程师之间的恩恩怨怨,被编成了很多段子在网络上流传。
file

编程语言分类

最早的编程语言以Fortran为主,主要是辅助科学计算。随着技术更迭至今已经产生了上千种编程语言,
file
编程语言分为三类:

机器语言

  • 机器语言由很多0和1构成的指令组成,无需解释或编译计算机就可以直接执行
  • 编写难度大、效率低
  • 华为、Intel、高通、三星等研发芯片部门

汇编语言

  • 汇编语言的实质和机器语言是相同的,都是直接对硬件操作,只不过指令采用了英文缩写的标识符,更容易识别和记忆。下面是汇编版hello world程序,是不是十分复杂呢。
    ; hello.asm 
    section .data            ; 数据段声明
        msg db "Hello, world!", 0xA     ; 要输出的字符串
        len equ $ - msg                 ; 字串长度
    section .text            ; 代码段声明
    global _start            ; 指定入口函数
    _start:                  ; 在屏幕上显示一个字符串
        mov edx, len     ; 参数三:字符串长度
        mov ecx, msg     ; 参数二:要显示的字符串
        mov ebx, 1       ; 参数一:文件描述符(stdout) 
        mov eax, 4       ; 系统调用号(sys_write) 
        int 0x80         ; 调用内核功能
                         ; 退出程序
        mov ebx, 0       ; 参数一:退出代码
        mov eax, 1       ; 系统调用号(sys_exit) 
        int 0x80         ; 调用内核功能
  • 编写难度仍然很大,难理解和复用
  • 优点是汇编生成的可执行文件小、执行速度快
  • 芯片公司或硬件厂商

高级语言

高级语言是大多数编程者的选择。和汇编语言相比,它不但将许多相关的机器指令合成为单条指令,并且去掉了与具体操作有关但与完成工作无关的细节,例如使用堆栈、寄存器等,这样就大大简化了程序中的指令。同时,由于省略了很多细节,编程者也就不需要有太多的专业知识。

但是高级语言所编制的程序不能直接被计算机识别,必须经过转换才能被执行,按转换方式可将它们分为两类:

  1. 编译类

    是指在应用源程序执行之前,就将程序源代码“翻译”成目标代码(机器语言),因此其目标程序可以脱离其语言环境独立执行(编译后生成的可执行文件,是cpu可以理解的2进制的机器码组成的),使用比较方便、效率较高。但应用程序一旦需要修改,必须先修改源代码,再重新编译生成新的目标文件(* .obj,也就是OBJ文件)才能执行,只有目标文件而没有源代码,修改很不方便。
    编译后程序运行时不需要重新翻译,直接使用编译的结果就行了。程序执行效率高,依赖编译器,跨平台性差些。如C、C++、Delphi等

  2. 解释类

    执行方式类似于我们日常生活中的“同声翻译”,应用程序源代码一边由相应语言的解释器“翻译”成目标代码(机器语言),一边执行,因此效率比较低,而且不能生成可独立执行的可执行文件,应用程序不能脱离其解释器(想运行,必须先装上解释器,就像跟老外说话,必须有翻译在场),但这种方式比较灵活,可以动态地调整、修改应用程序。如Python、Javascript、PHP、Ruby等语言。

现在很多高级语言同时兼顾编译和解释型语言的特点。比如Java为了兼顾跨平台和运行速度,Java 源代码首先会被编译为字节码文件(.class),但并非是机器语言,而是需要在 JVM 上运行,而 .class 文件在 JVM 上是解释执行的。所以 Java 兼具编译型语言和解释型语言的特点,为了更高的效率,JVM 还引入了 JIT(just-in-time,即时编译)编译器,在 Java 程序运行时进一步编译,转换成高度优化的机器代码。由于Java更接近编译型语言的特征,个人更愿意称Java为编译型语言.

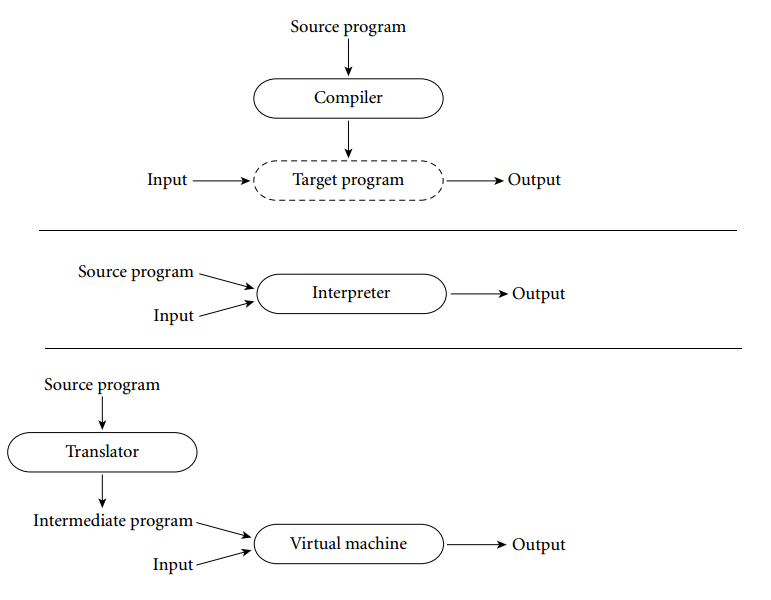
下图分别是编译型语言、解释型语言、以及基于虚拟机的语言。

file

面向过程 VS 面向对象

高级语言还可以分为面向过程和面向对象两种.

面向过程的语言

  • C / Fortran / Pascal / SQL
  • 把重复逻辑封装成函数
  • 控制结构构造: 顺序,选择,循环
  • 对于简单的程序, 流程明确, 简单粗暴高效, 但不利于编写复杂系统
  • 代码重用性低,扩展能力差,后期维护难度比较大

面向对象的语言

  • C++ / C# / Java / Python / Scala
  • 抽象共同属性和行为封装成类, 万物皆对象
  • 类与类之间关系更符合真实世界特征, 符合人类思维习惯
  • 使用类组织代码, 结构化, 模块化
  • 易扩展,代码重用率高,可继承,可覆盖,可以设计出低耦合的系统;
  • 易维护,系统低耦合的特点有利于减少程序的后期维护工作量。
  • 执行效率通常没有面向过程的语言高。

很多语言比如Javascript和PHP一开始是面向过程的, 后面也逐渐支持面向对象了.

这里所说的某个语言是面向过程或者是面向对象的, 这是通常情况下使用这个语言编写出来的代码是面向过程或者是面向对象的. 面向过程和面向对象更多是编程思想的差异, 并不是使用支持面向对象的语言比如Java写出来的就一定是面向对象的代码, 反过来使用纯C语言也不见得只能写出面向过程的代码, 只不过使用C语言编写面向过程的代码相对容易, 而使用Java语言编写面向对象代码相对容易, 因为Java是天生支持面向对象的语言.

国产编程语言

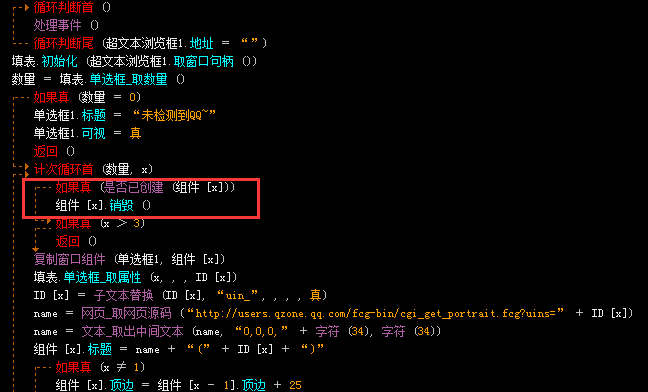
  • 易语言(中文写代码)
    file
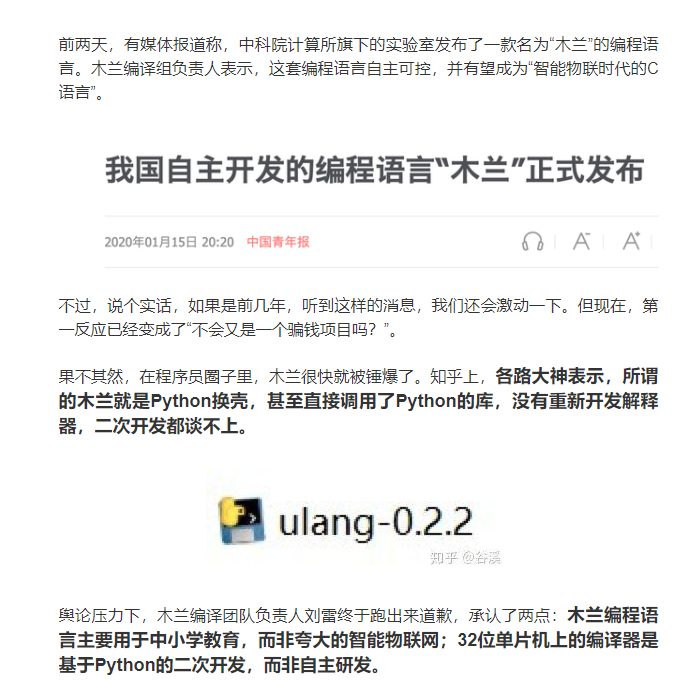
  • 木兰(假)
    file

搞笑篇

下面这些并不算真正的编程语言, 只是好玩:

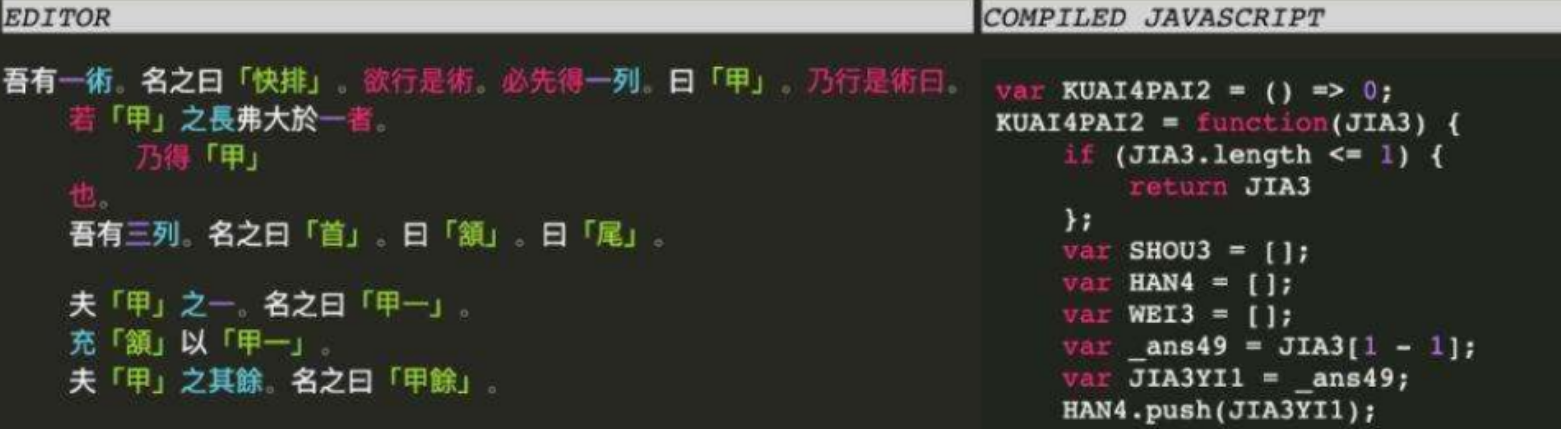
  • 文言文编程
    file w:30cm

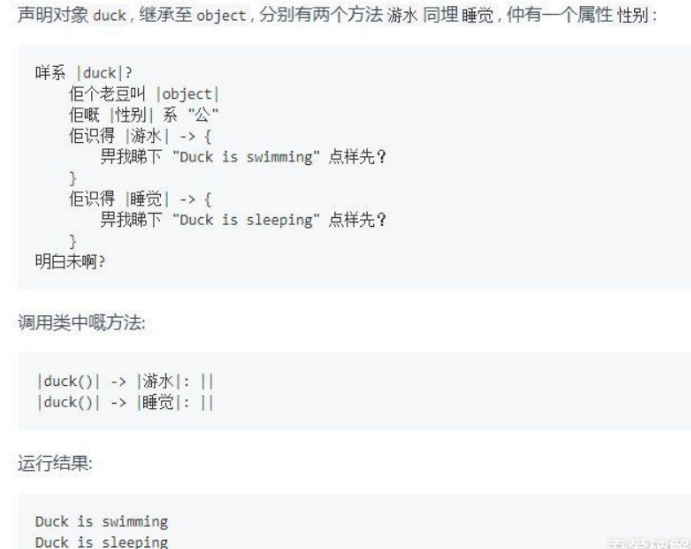
  • 粤语编程
    w

面向交互的高级语言

  • HTML
  • Javascript
  • XML
  • ASP
  • PHP

编程语言排行榜

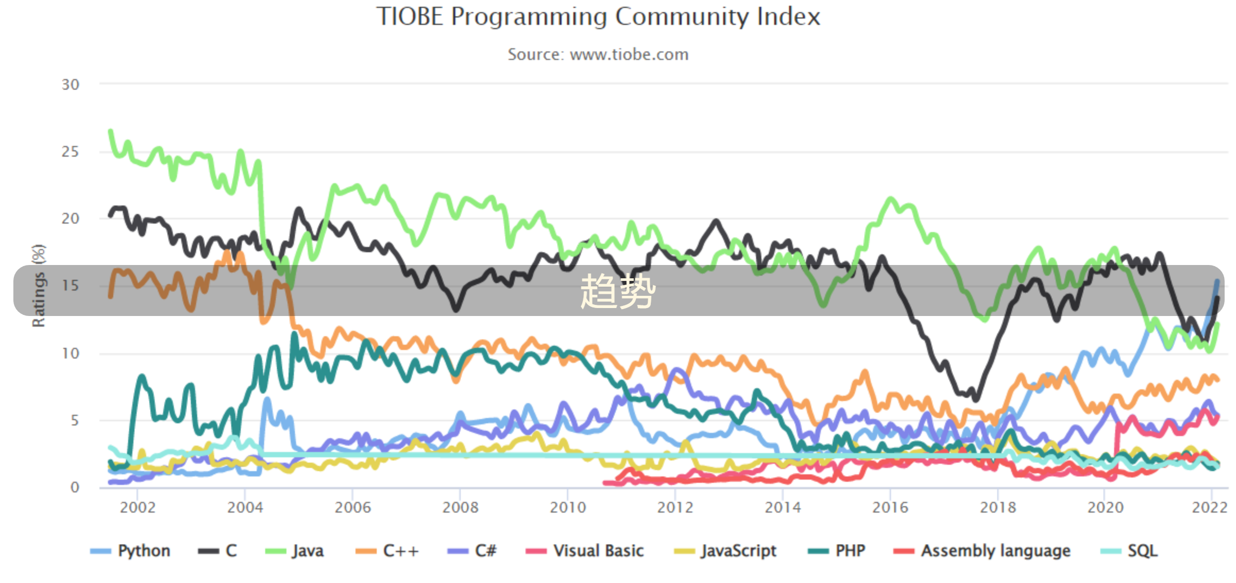
TIOBE编程语言排行榜是编程语言流行趋势的一个指标,每月更新,这份排行榜排名基于互联网有经验的程序员、课程和第三方厂商的数量。排名使用著名的搜索引擎(诸如Google、MSN、Yahoo!、Wikipedia、YouTube以及Baidu等)进行计算。请注意这个排行榜只是反映某个编程语言的热门程度,并不能说明一门编程语言好不好,或者一门语言所编写的代码数量多少。

这个排行榜可以用来考查你的编程技能是否与时俱进,也可以在开发新系统时作为一个语言选择依据。

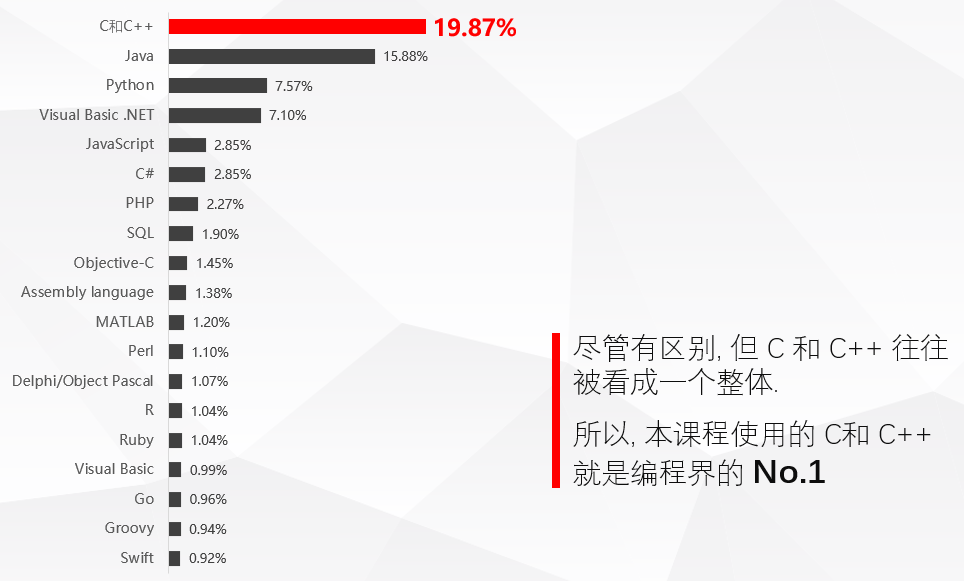
C/C++如果联合起来毫无疑问会排到第一名. 只要计算机还是冯诺依曼体系, C语言将会一直永存.可以说C语言是最接近底层的高级语言, 执行效率最高.

反过来C/C++由于其复杂性不利于编写大型企业级网站项目, 因为内存必须程序员手动管理, 指针用起来也比较容易出错. 而Java语言没有指针类型, 又支持垃圾回收(GC)机制, 更容易编写出健壮的程序.

如何成为大神

  • 多敲多练多想 大神如何敲代码
  • 云笔记多总结
    • 推荐有道云笔记
    • 及时偿还技术债
  • 善用搜索引擎
    • 谷歌/百度
  • 学会提出问题
    • 切忌无脑问
    • 说明前因后果
    • 总结经验

Views: 59

程序设计基础总复习

程序设计基础总复习

时间地点:

以教务系统为准.

课程得分:

平时: 40%, 考试: 60%

考核方式:

闭卷.

不允许电子设备和纸质材料.

选择题 30个
填空题 10个
判断题 10个
分析题 1个
编程题 2个

使用语言:

标准C语言

编程基础

image-20200629230244144

编程语言分类

  • 机器语言 0101
  • 汇编语言 指令: ADD MOV
  • 高级语言 C/C++, Python, Java

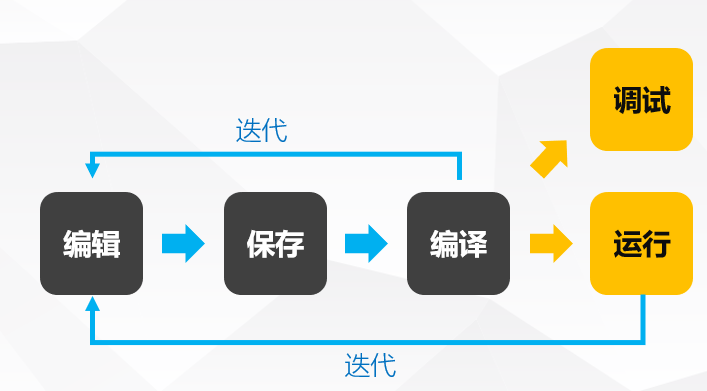
高级语言代码的旅程

image-20200629232948722

常用关键字

image-20200629233218677

sizeof关键字

sizeof是C语言中保留关键字,也是单目运算符。常见的使用方式:

int a=10;
int arr[] = {1, 2, 3};
char str[] = "hello";
int len_a = sizeof(a);
int len_arr = sizeof(arr);
int len_str = sizeof(str)

二进制计算

二进制整数最终都是以补码形式出现的.

•正数的补码与原码、反码是一样的.

•负数的补码是反码加 1 的结果.

这种设计, 使得符号位也可以参与运算, 使加法器也能实现减法运算. 在计算机里的任何计算最终都可以变成加法运算, 加法运算是高频率运算, 使用同一个运算器(加法器), 可以减少中间变量存储的开销, 降低CPU内部的设计复杂度, 使计算机内部结构更精简, 计算更高效.

举例使用二进制计算 2 - 3

为了方便演示, 假设存储单元长度为8位

有符号的情况下, 第一位为符号位, 正数符号位为0, 负数符号位为1

计算 2 - 3, 其实就是计算 (+2) + (-3)

+2 原码 (0)000 0010, 
+2 补码 (0)000 0010

-3 原码 (1)000 0011, 
-3 补码 (1)111 1101

因此当计算机处理 2 - 3的时候, 其实是将 +2 和 -3 的二进制补码相加

   0000 0010
 + 1111 1101 
 -----------
   1111 1111

最终结果为 1111 1111(补码), 对应的数值是 -1

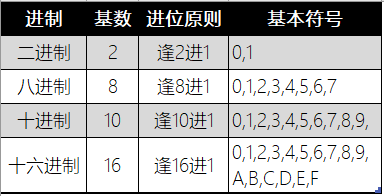
不同进制的比较

image-20200629233813798

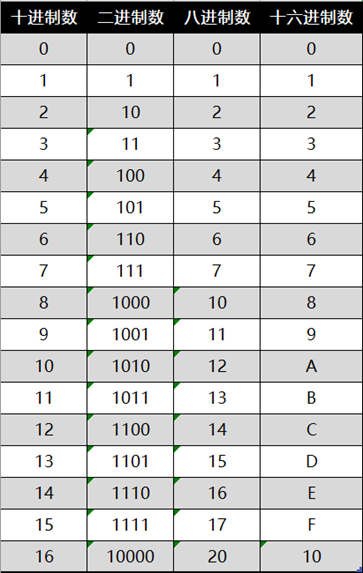
非负数在不同进制下的表示

image-20200629233819885

变量定义

不被初始化的局部变量,其值为随机数

变量作用域

#include <stdio.h>

int a = 1;
int main (){
    {
        printf("%d", a); // ?
        int a = 2;
        printf("%d", a); // ?
    }
    printf("%d", a);     // ?
}

合法标识符

C语言标识符是指用来标识某个实体的一个符号,在不同的应用环境下有不同的含义,标识符由字母(A-Z,a-z)、数字(0-9)、下划线“_”组成,并且首字符不能是数字,但可以是字母或者下划线($符号也可以)。例如,正确的标识符:abc,a1,prog_to。

另外标识符不可以是关键字.

基本数据类型

  • int

    整数,在目前绝大多数机器上占4个字节

  • float

    单精度浮点数,4个字节

  • double

    双精度浮点数,8个字节

  • char

    字符,1个字节

    表示256个ASCII字符,或0~255的整数

1 == sizeof(char) <= sizeof(short) <= sizeof(int) <= sizeof(long) <= sizeof(long long).

取值范围

Data Type Min Value Max Value
short int 2^15 2^1
unsigned short int 0 2^15-1
unsigned char 0 2^8-1

数据类型修饰符

  • short

    short int,简写为short

    短整数,2 个字节

  • long

    • long int,简写为long

    长整数,至少4个字节

    • long double,长双精度(高精度)

    浮点数,至少8字节

  • unsigned | signed

    用来修饰char | int | short | long

    unsigned表示无符号整数(包括正整数和0)

    signed表示有符号, 因为是默认情况一般省略

字符类型

通过关键字 char 来定义, 如

char c;

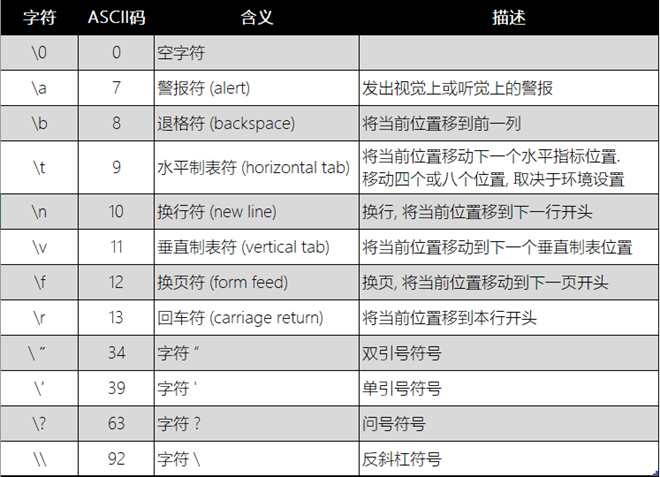
常用转义字符表

image-20200629234803070

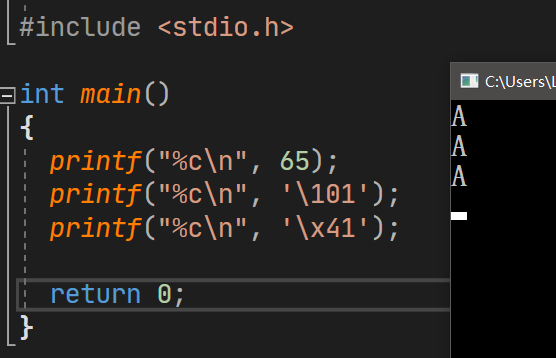
  • 8进制转义字符

    - octal escape sequence

    8进制数字字符需在前面使用\进行转义

  • 16进制转义字符

    - hexadecimal escape sequence

    16进制数字字符需在前面使用\x进行转义

image-20200701010132169

编程思维

  • 变量的定义和初始化
  • 变量及其作用域
  • 基本数据类型
    • 前缀[unsigned/signed]
    • char 固定1字节
    • short [int] 一般2字节
    • int 一般4字节
    • long [int] 一般4字节
    • long long [int] 一般8字节
    • float 一般4字节
    • double 一般8字节
    • long double 一般16字节
  • 各类运算符和表达式:
    • 算术 + - * / %
    • 显示类型转换
    • 隐式类型转换
    • 赋值
    • 自增自减
    • 位操作
    • 关系运算
  • 结构化程序设计
  • 逻辑运算符和表达式: && || !
  • 运算符的优先级
  • 分支结构
    • if, switch的使用
  • 循环结构 for, while, do while的使用

变量

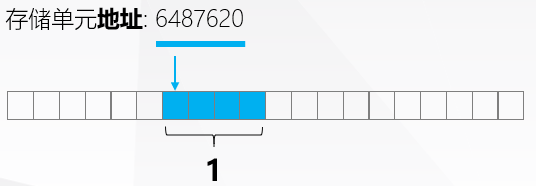
变量的四个属性

int a = 1;
  • 变量名字: a

  • 变量类型: int (4字节)

  • 变量值: 1

  • 存储单元地址: 6487620

image-20200630011538138

注: 每一个变量要有一个与其它变量不相同的合法名字.

该名字的第一个字符必须是字母或下划线, 其后的字符只能是字母、数字和下划线, 且不得与 C 语言系统所保留的关键字相同.

常量

常量(Constant) 在程序中不能改变其值的量

包括:

  • 整型常量

    如: 0, 67, -2, 123L, 123u, 022, 0x12

    默认为int

    85         /* 十进制 */
    0213       /* 八进制 */
    0x4b       /* 十六进制 */
    30         /* 整数 */
    30u        /* 无符号整数 */
    30l        /* 长整数 */
    30ul       /* 无符号长整数 */
    212         /* 合法的 */
    215u        /* 合法的 */
    0xFeeL      /* 合法的 */
    078         /* 非法的八进制没有8*/
  • 实型常量

    2.3, 1.2e-5, 2.73F, 2.73L

    默认为double

    3.14159    /* 合法的 */
    314159E-5L /* 合法的 */
    510E       /* 非法:不完整指数 */
    210f       /* 非法:没小数或指数 */
    .e55       /* 非法:缺基数(整数或分数) */
  • 字符型常量

    'z', '3', '$', '\n', '\x41'

    用'\'开头的字符为转义字符, 连同之后的字符一起代表1个字符

    '\\'      \
    '\''      '
    '\"'      "
    '\?'      ?
    '\a'      警报铃声
    '\b'      退格键
    '\f'      换页符
    '\n'      换行符
    '\r'      回车
    '\t'      水平制表符
    '\v'      垂直制表符
    '\ooo'      ooo 代表八进制数
    '\xhh'      hh 代表十六进制数
  • 字符串常量

    "123", "UKM", "1", "5a"

    // 3种写法相同
    char c1[] = "hello, dear";
    char c2[] = "hello, \
    dear";
    char c3[] = "hello, " "d" "ear";
  • 枚举型常量 enum

    枚举是 C 语言中的一种基本数据类型,它可以让数据更简洁,更易读。

    如果不指定, 第一个枚举成员的默认值为整型的 0,后续枚举成员的值在前一个成员上加 1

    enum DAY{
    MON=1, TUE, WED, THU, FRI, SAT, SUN};

定义常量

在 C 中,有两种简单的定义常量的方式:

  1. 使用 #define 预处理器

    #define LENGTH 10
    #define WIDTH  5
    #define NEWLINE
  2. 使用 const 关键字。

      const int  LENGTH = 10;
      const int  WIDTH  = 5;
      const char NEWLINE = '\n';

运算符优先级

表达式有多个运算符时, 需保证计算过程无二义性.

  • 通过规定运算符的 “优先级” 和 “结合性” 来保证运算结果的唯一性.
  • 对表达式求值, 应先按运算符优先级的高低次序执行.
  • 运算符优先级规律:! > 算术运算符 > 关系运算符 > && > || > 赋值运算符
  • 如果操作数两侧的运算符优先级相同, 则按运算符的结合性处理(运算次序由结合方向所决定).
  • 对于复杂的运算, 建议使用括号明确表示优先级关系
#include <stdio.h>

int main()
{
    int a = 1, b = 2, c = 3;
    a + b * c;  // 1
    a + b - c;  // 2
}
优先级 运算符 名称或含义 使用形式 结合方向 说明
1 [] 数组下标 数组名[常量表达式] 左到右 --
1 () 圆括号 (表达式)/函数名(形参表) 左到右 --
1 . 成员选择(对象) 对象.成员名 左到右 --
1 -> 成员选择(指针) 对象指针->成员名 左到右 --
2 - 负号运算符 -表达式 右到左 单目运算符
2 ~ 按位取反运算符 ~表达式 右到左 单目运算符
2 ++ 自增运算符 ++变量名/变量名++ 右到左 单目运算符
2 -- 自减运算符 --变量名/变量名-- 右到左 单目运算符
2 ***** 取值运算符 *指针变量 右到左 单目运算符
2 & 取地址运算符 &变量名 右到左 单目运算符
2 ! 逻辑非运算符 !表达式 右到左 单目运算符
2 (类型) 强制类型转换 (数据类型)表达式 右到左 --
2 sizeof 长度运算符 sizeof(表达式) 右到左 --
3 / 除 表达式/表达式 左到右 双目运算符
3 ***** 乘 表达式*表达式 左到右 双目运算符
3 % 余数(取模) 整型表达式%整型表达式 左到右 双目运算符
4 + 加 表达式+表达式 左到右 双目运算符
4 - 减 表达式-表达式 左到右 双目运算符
5 << 左移 变量<<表达式 左到右 双目运算符
5 >> 右移 变量>>表达式 左到右 双目运算符
6 > 大于 表达式>表达式 左到右 双目运算符
6 >= 大于等于 表达式>=表达式 左到右 双目运算符
6 < 小于 表达式<表达式 左到右 双目运算符
6 <= 小于等于 表达式<=表达式 左到右 双目运算符
7 == 等于 表达式==表达式 左到右 双目运算符
7 != 不等于 表达式!= 表达式 左到右 双目运算符
8 & 按位与 表达式&表达式 左到右 双目运算符
9 ^ 按位异或 表达式^表达式 左到右 双目运算符
10 | 按位或 表达式|表达式 左到右 双目运算符
11 && 逻辑与 表达式&&表达式 左到右 双目运算符
12 || 逻辑或 表达式||表达式 左到右 双目运算符
13 ? : 条件运算符 表达式1?表达式2: 表达式3 右到左 三目运算符
14 = 赋值运算符 变量=表达式 右到左 --
14 /= 除后赋值 变量/=表达式 右到左 --
14 *= 乘后赋值 变量*=表达式 右到左 --
14 %= 取模后赋值 变量%=表达式 右到左 --
14 += 加后赋值 变量+=表达式 右到左 --
14 -= 减后赋值 变量-=表达式 右到左 --
14 <<= 左移后赋值 变量<<=表达式 右到左 --
14 >>= 右移后赋值 变量>>=表达式 右到左 --
14 &= 按位与后赋值 变量&=表达式 右到左 --
14 ^= 按位异或后赋值 变量^=表达式 右到左 --
14 |= 按位或后赋值 变量|=表达式 右到左 --
15 , 逗号运算符 表达式,表达式,… 左到右 --

表达式

C语言的表达式由运算符、常量、变量所组成, 以分号结尾.

#include <stdio.h>

int main()
{
    int a = 0;
    1;
    a;
    -a + 1;
    -a + 2.5 * 3;

    return 0;
}

表达式的最基本形式就是一个数据, 也称为操作数, 可以是任意类型的常量或变量.

将操作数与运算符结合, 可以构建一个新的表达式, 继而使用多个运算符连接多个操作数可以形成更为复杂的表达式.

条件表达式

条件操作符(? :)中的第一个操作数,逻辑非(!)、逻辑与(&&)、逻辑或(||)的操作数都是条件表达式。if、while、do while、以及for的第2个表达式都是条件表达式。

在C语言里, 条件表达式返回0时表示为假(0), 返回非0时表示为真(1).

printf("%d\n", 2 == 1 + 1);  // 1

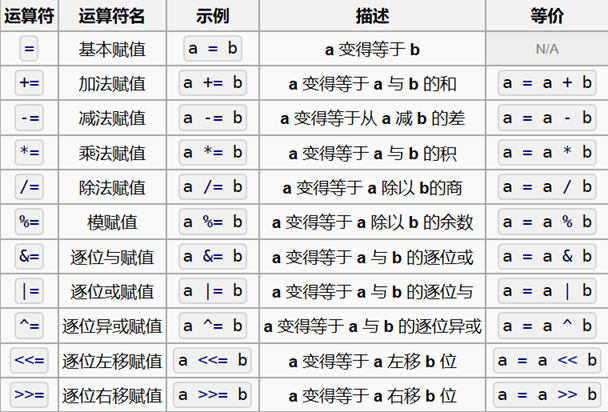
复合赋值

image-20200702222837881

隐式类型转换

隐式类型转换可以发生在:运算、赋值、函数参数、函数返回值时, 具体是在

  • 运算时操作数之间类型不同时
  • 赋值时表达式返回类型和接受变量类型不同时
  • 实参类型和形参类型不同时
  • 函数实际返回类型和定义返回类型不同时

转换后的类型范围更大, 精度更高.

image-20200702223036993

1 / 5;     // int
1 / 5.0;   // double 0.2

举例

int ival; double dval;
ival >= dval; // int -> double

整形提升

  • 算术转换通常的是做整型提升

    - integral promotion

int ival = 3.14; // 3.14  -> int 
int *ip = 0;     // 0 -> NULL ptr

流程控制

C语言的流程控制结构主要分为:顺序结构,选择(分支)结构,循环结构.

其中选择结构和循环结构可以互相任意嵌套

img

分支

if语句

// 语句可以是单独的一条语句
// 也可以是{}包围的一条复合语句
if (条件表达式) 
    语句;

// else 总是向上匹配距离最近的 if
if (条件表达式) 
    语句1;
else
    语句2;

// 三元运算符可以替换简单的 if else
int a = 3, b = 5, max;
if (a > b) max = a; else max = b;
// 等同于
max = a > b ? a : b;

// 多分支, else if 可以多个
if (条件表达式) 
    语句;
else if (条件表达式)
    语句;
else if (条件表达式)
    语句;
else 
    语句;

注意条件判断是有顺序的, 如果命中了一个判断条件, 则会跳过其他的判断.

举例: foo bar baz 问题

这是一个国外非常常见的编程面试题: 遍历打印数字1至数字50, 遇到能被3整除的打印'foo'、遇到能被5整除的打印'bar'、遇到即能被3整除也能被5整除的打印'baz'。

#include <stdio.h>

int main()
{
  int i;
  for (i = 1; i <= 50; i++)
  {
    if (i % 3 == 0 && i % 5 == 0)
      puts("baz");
    else if (i % 3 == 0)
      puts("foo");
    else if (i % 5 == 0)
      puts("bar");
    else
      printf("%d\n", i);
  }
  return 0;
}

输出

1
2
foo
4
bar
foo
7
8
foo
bar
11
foo
13
14
baz
16

switch语句

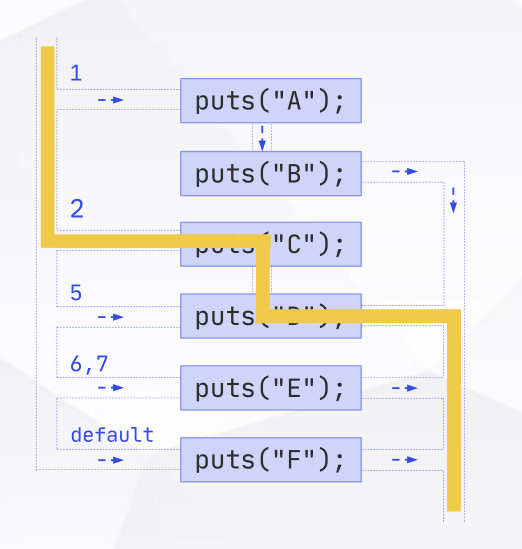
switch语句 只能对 返回整形(枚举返回的也是整形)的条件表达式 进行 相等判断

image-20200703105638017
image-20200703105702606

为了避免出错, 除了一些特殊情况外, 每一个case都应该用break结束

循环

for循环语句

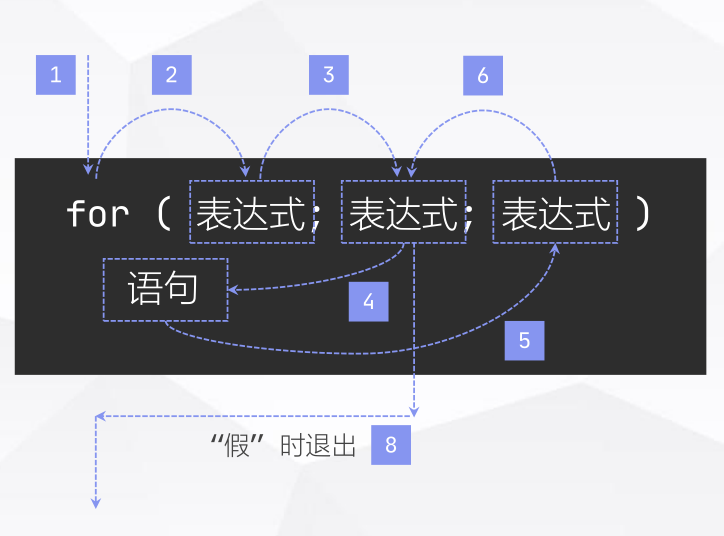
image-20200703110329639

break VS continue

  • 都在循环体内出现

  • break: 无条件退出该层循环,循环控制变量不再起作用

  • continue: 并不退出该层循环,只是不再执行循环体中位于其后的语句,循环控制变量仍然起作用。

while 当循环

先检测 表达式 的值, 如果为 非0 则执行循环体中的 语句,如果为 0 则跳出循环过程

语法:

while (表达式)
{
    语句
};

do while 直到循环

先执行do里面的语句, 然后检查条件表达式的结果, 如果为 非0 继续循环,如果为 0 则跳出循环过程, 直到型循环可以保证至少执行语句一次.

语法:

do
{
    语句
} while (表达式);

最后的分号别忘了添加.

枚举算法

有序地去尝试每一种可能

所有的可能都一一验证.

把重复的工作交给计算机去完成.

// 伪代码
for (ans in allCandidates)
{
    if (ans is answer)
    {
        output ans;
    }
}

等式填数

在两个□内填入相同的数字, 使得以下等式成立:

_3 X 6528 = 3_ X 8256

如果有多个答案, 要求从小到大列出所有满足条件的等式. 例如:

43 X 6528 = 34 X 8256

过滤法(筛法)

在循环里面添加判断, 例如找出1-100之间的所有合数, 就可以通过筛去所有素数得到

#include <stdio.h>
#include <math.h>

int main()
{
  int nums[101] = {0};

  for (int i = 2; i < 101; i++)
  {
    int divisor = 2;
    while (divisor <= sqrt(i))
    {
      if (i % divisor == 0)
      {
        nums[i] = 1;
        break;
      }
      divisor++;
    }
  }

  for (int i = 2; i < 101; i++)
    printf("%d\t是%s\n", i, (nums[i] ? "合数" : "质数"));

  return 0;
}

函数和递归

  • 函数的定义: 名字, 形参列表, 返回值类型
  • 形参与实参概念和使用
  • 值传递和引用传递
  • 递归函数的特点
  • 熟记经典问题及其递归解法
    • 斐波那契序列, 汉诺塔, 8皇后…

求和函数定义示例

int sum (int x, int y)
{
    int z;
    z = x + y;
    return z;
}

函数首部 即"{}"以上的一行说明, 包括: 返回值类型、函数名、形式参数列表;

函数体 则是从"{"开始, 到"}"结束的代码块, 函数体又分为声明部分和语句部分

函数参数传递

  • 声明和定义时: 形参
  • 调用时: 实参
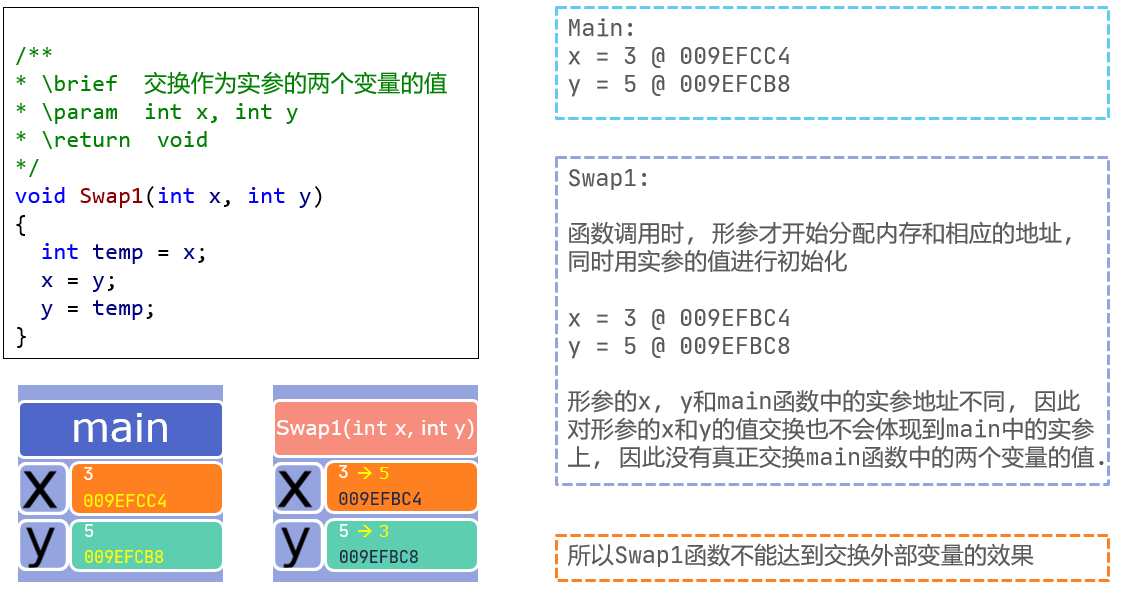
  • 形参是在函数被调用时才分配形参的存储单元.
  • 实参可以是常量、变量或表达式.
  • 实参类型必须与形参相符.
#include <stdio.h>

void AddOne(int a)  // a 形参
{
    a++;
    printf("a=%d", a);
}

int main()
{
    int x = 1;
    AddOne(x);     // x 实参
    printf("x=%d", x);
}

image-20200703111715423

数组作为参数

数组作为函数参数时,在函数内对数组名进行sizeof运算的结果总为4(目标编译平台是32位时)
这是因为,函数中的指针传递本质上也是属于值传递(指针变量的地址), 编译器并不会检查数组的长度. – 导致在函数内部数组退化成指针.

对编译器来说下面的三个定义并没有什么区别:

void Test( char array[20]);
void Test( char array[]);
void Test( char* const array);

这也是为什么C语言的很多函数在需要数组作为参数时需要同时传入数组名和数组大小作为形参.

void putValues(int arr[], int size);

函数返回值

在绝大多数情况下,函数定义的返回值类型与 return 语句中返回值的数据类型必须是一致的.

函数定义的返回值类型, 与return语句中返回值的数据类型不一致时, 以函数定义的返回值类型为准.

编译器先尝试将return语句中的返回值隐式转换为函数定义的返回值类型, 然后再返回给主调对象, 如果不能完成转换, 编译器将会报错.

#include <stdio.h>

int AddTwo(short a, short b)
{
    return a + b;   // short -> int
}

int main()
{
    short a = 2, b = 3;
    printf("x=%d", AddTwo(a, b));
}

void类型

void 被翻译为"无类型",相应的void * 为"无类型指针"。常用在程序编写中对定义函数的参数类型、返回值、函数中指针类型进行声明。

void的作用

  1. 当函数不需要返回值值时,必须使用void限定,这就是我们所说的第一种情况。例如:void func(int a,char *b)

  2. 当函数不允许接受参数时,必须使用void限定,这就是我们所说的第二种情况。例如:int func(void)

  3. 当没有定义函数返回值时, C语言默认返回值类型是int, 而C++是void

递归调用

  • 递归就是函数直接或者间接调用自身
  • 递归利用了函数调用栈, 如果调用层级过深会导致堆栈溢出错误 - Stack Overflow
  • 递归必须有出口, 如果没有出口就会出现无限循环调用, 同样会导致堆栈溢出.
  • 递归函数必须带有形参, 递归过程中的每一次调用必须调整函数的参数使问题范围越缩越小, 小到可以直接解决为止(到达出口).
  • 递归函数根据情况可以有返回值, 也可以没有返回值
// 返回n的阶乘 - 递归的方式
// n > 1 
long double f(const int n)
{
  if (n == 1)
    return 1;
  return f(n - 1) * n;
}

递归过程

image-20200426102528279

递归是自顶向下解决问题, 将大问题化解成小问题, 小问题解决了, 反过来大问题就解决了, 和迭代相比递归的代码量一般会更少, 逻辑更清晰, 符合人类思维方式, 可读性更好.

数组

  • 数组的定义和初始化
  • 数组下标的使用(从0开始)
  • 一维数组、二维数组
  • 数组作为函数形参
  • 常用数组元素的排序方法及其代码
  • 已排序数组元素的折半查找
  • 指针, 地址

何为数组

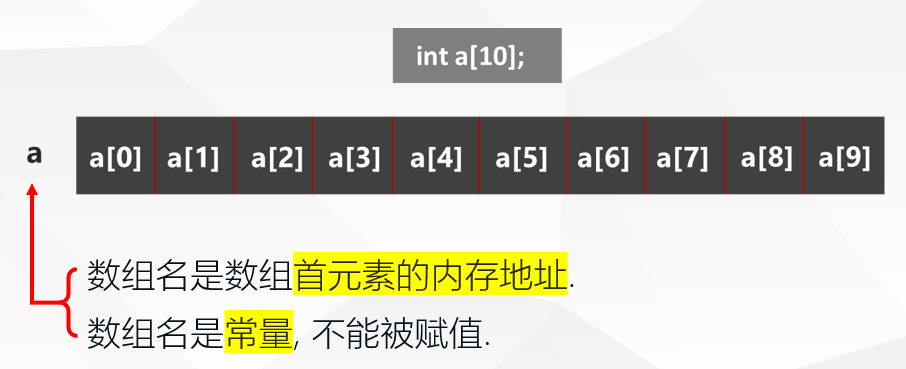
数组 (array) 是一种数据格式, 能够存储多个同类型的值, 数组在定义时就要确定空间大小, 里面的元素在内存上是连续的.

  1. 可以将数组中的每个元素看做一个简单的变量.
  2. 数组是具有一定顺序关系的若干相同类型变量的集合体, 组成数组的变量称为该数组的元素.
  3. 数组还被称为复合类型, 时因为它是使用其他类型来创建的.
  4. 数组的元素在逻辑上是连续, 在物理上也是连续的, 通过下标即可快速计算出指定元素的位置.

一维数组的顺序存储

数组元素在内存中顺次存放, 它们的地址时连续的:

image-20200630145804219

下标越界检查?

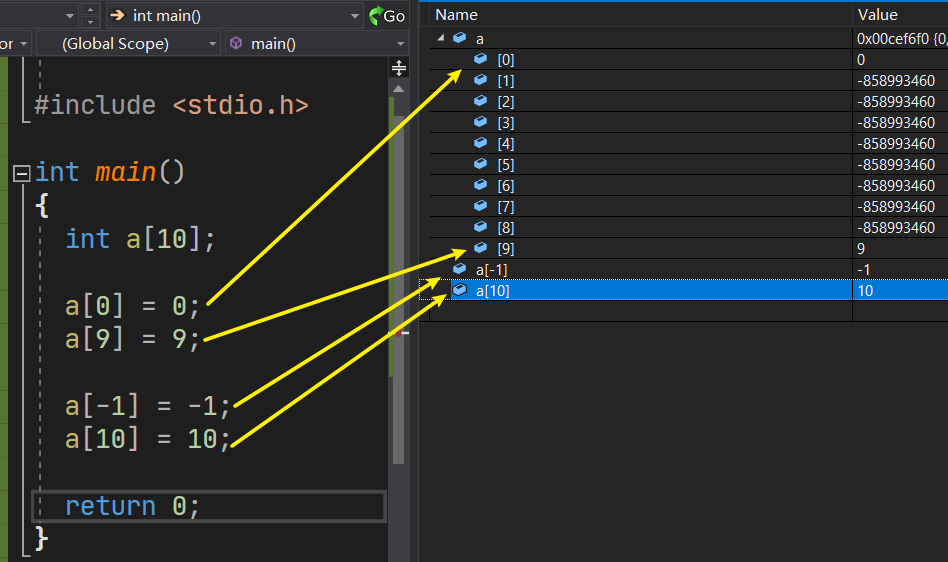
不存在的. C语言编译器不会帮你检查使用的下标是否有效.

例如, 如果将一个值赋给不存在的元素 a[10], 编译器并不会指出错误. 但是程序运行后, 这种赋值可能会引发问题, 它可能破坏数据或代码, 也可能导致程序异常终止.

所以必须确保程序只使用有效的下标.

image-20200630150500138

数组初始化

  • 在声明数组时对数组元素赋以初值. 例如:

    int a[10]={1, 2, 3, 4, 5, 6, 7, 8, 9,10};
  • 可以只给一部分元素赋初值.

    int a[10]={1, 3, 5, 7}; 
    int a[10]={0}; 
  • 在对全部数组元素赋初值时, 可以不指定数组长度.

    int a[]={1, 2, 3, 4, 5, 6, 7, 8, 9, 10}

    使用memset函数对数组初始化
    使用 memset 函数, 调用此库函数需要加入头文件 <memory.h>

用法: memset(数组名,初始化值,sizeof(数组名))

int arr[];
// 初始化成 0
memset(arr, 0, sizeof( arr ));
// 初始化成 -1
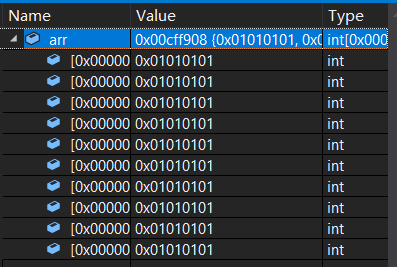
memset(arr, -1, sizeof( arr ));
// 注意, 这样不能初始化成 1
// 实际初始化成了 16843009
memset(arr, 1, sizeof( arr ));

image-20200703114215963

数组下标使用

&a[x] = a + x * sizeof(a[0]);

二维数组

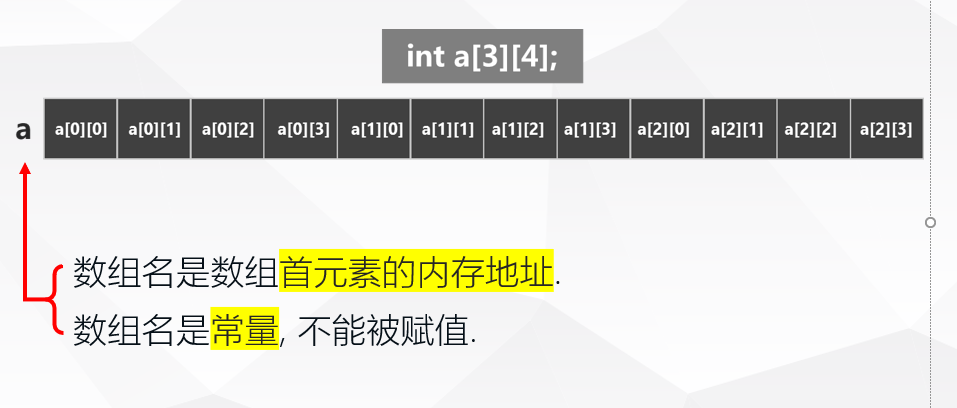
二维数组本质上也是一维数组, 数组元素在内存中顺次存放, 它们的地址是连续的. 例如:

image-20200702001952774

二维数组初始化

二维数组的初始化: 在定义数组的同时赋给初值.

// 将所有数据写在一个{}内, 按顺序赋值
int a[3][4]={1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12};

// 分行给二维数组赋初值, 例如:
int a[3][4] ={
    {1,  2,  3,  4},
    {5,  6,  7,  8},
    {9, 10, 11, 12}
};

// 可以对部分元素赋初值, 例如:
int a[3][4]={
    {1}, 
    {0, 6}, 
    {0, 0, 11}
}; 

// 以上写法等同于
int a[3][4]={
    {1, 0,  0, 0}, 
    {0, 6,  0, 0}, 
    {0, 0, 11, 0}
};

// 列出全部初始值时, 第1维下标个数可以省略, 例如:
int a[][4]={1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12};
// 再如:
int a[][4] ={
    {1, 2, 3, 4}, 
    {5, 6, 7, 8}, 
    {9, 10, 11, 12}
}; 

// 但是这样是错误的
int a[3][] ={
    {1, 2, 3, 4},
    {5, 6, 7, 8},
    {9, 10, 11, 12}
}; 
  • 数组定义的时候必须指定数据类型, 好确定每个元素需要开辟多少空间.
  • 数组空间大小定义时就已经确定, 不能更改.
  • 多维数组可以视为特殊的一维数组, 只不过其元素也是数组.
  • 因为多维数组的其余维是用来确定每次开辟多少空间, 而第一维是用来确定开辟空间的倍数.
  • 如果定义时不指定其余维的长度将导致二义性, 即编译器无法确定给每次开辟多少空间, 造成编译错误.
  • 所以多维数组定义时, 除了第一维长度可以省略, 其余维度必须给出具体长度.

二维数组下标

// 二维数组下标与元素寻址
&a[x][y] == a + x*sizeof(a[0]) + y*sizeof(a[0][0])

冒泡排序

  for (int i = 0;i < SIZE-1;i++)
  {
    for (int j = 0;j < SIZE-i-1;j++)
    {
      if (arr[j] > arr[j + 1])
      {
        int temp = arr[j];
        arr[j] = arr[j + 1];
        arr[j + 1] = temp;
      }
    }
  }

基于数组的排序方法非常多, 例如:

  • 冒泡排序
  • 快速排序
  • 堆排序
  • 桶排序

字符数组

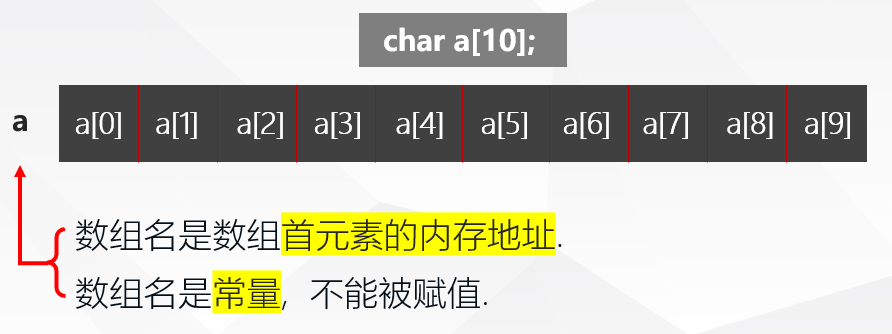
数组元素在内存中顺次存放, 它们的地址是连续的.字符数组中的每个元素在内存中占用一个字节的存储单元, 用于存取一个字符.

image-20200702010455008

空终止字符串

  • 也叫 NTBS - NULL Terminated Byte String
  • C语言中没有字符串数据类型, 于是将字符串中的字符逐个存放到数组元素中.
  • 字符串是一个独立的概念, 其以 '\0' 字符结尾, 字符串的本质还是字符数组.
  • 字符串常量用"xxx"表示

比如字符数组 {'\x63', '\x61', '\x74', '\0'} 是 ASCII 编码的字符串 "cat" 的 NTBS 。

用字符串来初始化字符数组

// 数组大小要考虑字符串末尾的空字符'\0'
char c[12] = {"hello world"};
// 花括号可以省略
char c[12] = "hello world";
// 数组大小可以省略
char c[] = "hello world";
// 虽然可以通过编译, 但避免这样使用
char *c = "hello world";

image-20200702011032282

字符表示ASCII

*注意, ASCII是American Standard Code for Information Interchange缩写, 而不是ASCⅡ(罗马数字2), 有很多人在这个地方产生误解.

ASCII (美国信息交换标准代码) 是基于拉丁字母的一套电脑编码系统, 主要用于显示现代英语和其他西欧语言.

ASCII包含三个部分内容:

img

  • "控制码“ 0~32: 规定了特殊的用途, 一旦终端、打印机遇上这些字符, 就要做一些约定的动作.

  • "标准字符" 33~127: 空格、标点符号、数字、大小写字母.

  • "扩展字符“ 128~255: 表示新的字母、符号, 还有画表格用到的横线、竖线、交叉等形状.

但是ASCII的扩展十分有限, 然而想要表示譬如中文这样的文字显然是不太够用的。于是,计算机工程师们给自己国家的语言创建了对应的字符集(Charset)和字符编码(Character Encoding)。

如果要表示汉字, 可以使用 GB编码(GB2312,GBK等可以表示简体中文),BIG5编码(表示繁体中文), UNICODE编码(也叫万国码, 包含了 150 种语言的 14 万个不同的字符).

以GB2312为例, 即《信息交换用汉字编码字符集》

两个大于 127 的字符(unsigned char)连在一起, 表示一个汉字. 这样, 双字节可以组合出约 7000 多个简体汉字 (常用的汉字都在这里面了).

image-20200702012054920

我们常常会看到乱码, 乱码是怎么产生的呢?

`手持两把锟斤拷,

口中疾呼烫烫烫。

脚踏千朵屯屯屯,

笑看万物锘锘锘`

锟斤拷:

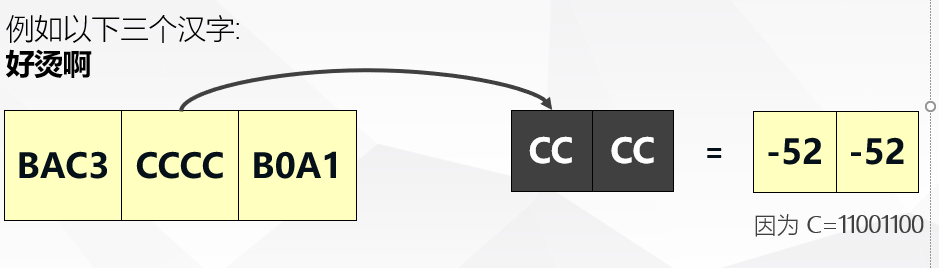
UTF8编码的文本用<code>GBK格式解码时一些无法被字符集识别的字符会变成"\xef\xbf\xbd\xef\xbf\xbd", 由于GBK编码是2个字符表示一个汉字, 结果就成了"锟斤拷"

烫烫烫:

Visual Studio 的Debug模式用'0xCC'表示未初始化的内存, 其中'0xCC'在MBCS字符集中表示为"烫"

常用字符处理函数

Defined in header <string.h>

  • strlen

    returns the length of a given string

    strlen("HELLO WORLD");  //11
  • strcpy

    char src[] = "cpycpy";
    char des[strlen(src) + 1];
    strcpy(des, src);
  • strcmp

    // 使用字典序比较两个字符串
    strcmp("abc", "def"); // -1
    strcmp("aaa", "aaa"); // 0
    strcmp("acb", "abc"); // 1
  • strstr

    strstr("Hi, delucia, bye~", "delucia"); // delucia, bye~

结构体

结构体类型 struct

C语言允许使用结构体, 建立由不同数据类型组成的构造类型, 这种数据类型被称为结构体类型.

通过结构体类型, 我们可以将分散的信息集中起来表示一个实体类型.

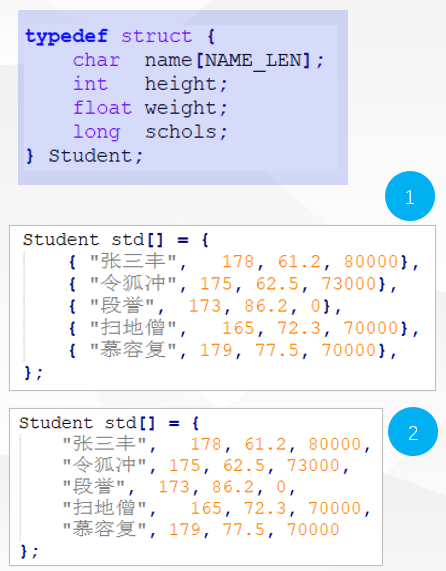
如将学号、姓名、年龄、成绩等各项属性组织在一起, 用来表示某个学生.

image-20200702020753901

struct类型和C++的class类型基本用法相同. 主要区别是struct类型的成员默认可见性是public, 而class类型是private.

初始化

结构体类型可使用{}括起来的初值列表进行初始化

image-20200702021446810

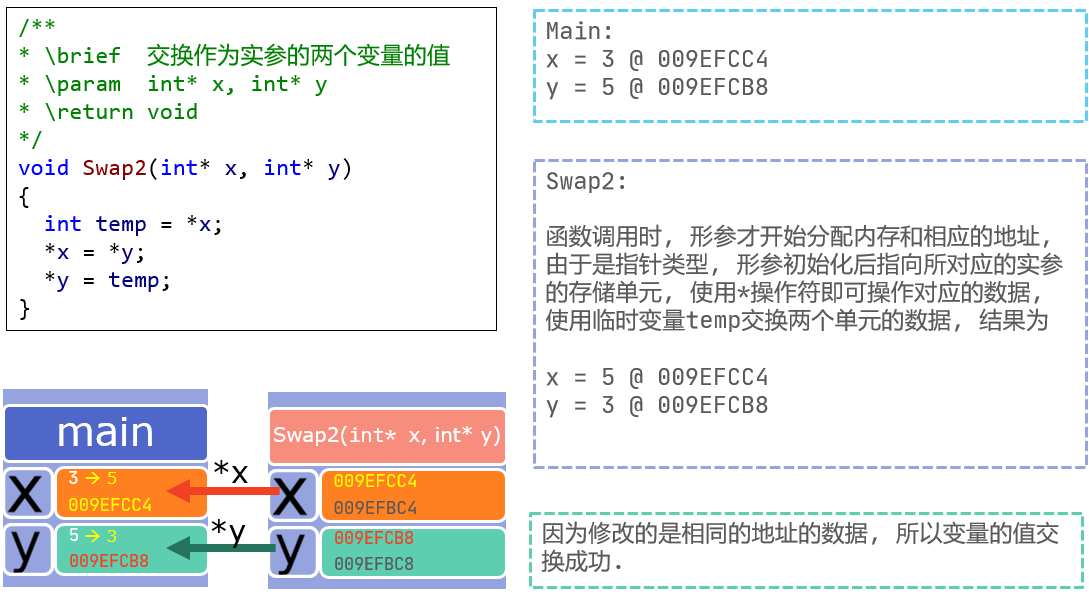
结构体类型变量可以作为函数参数以及返回值使用.

但是要注意, 结构体类型做参数时, 如果需要永久改变实参变量的成员的值, 则需要传递指针

image-20200703100033468

typedef

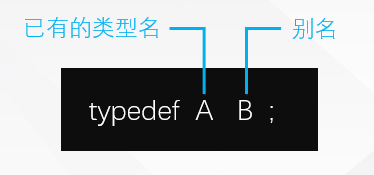
typedef 声明, 可以给原有的数据类型定义 “别名”, 它的作用等同于数据类型名称, 通过合适的命名可以让数据类型表示的更直观.

image-20200702022618068

typedef unsigned long ULONG;
ULONG number = 1L;

字节对齐

结构体在内存中是连续存储的 为了让操作系统可以快速读取到每个成员的 数据, 需要进行字节对齐 目的是将不同的成员分段存储, 保证任何成 员的地址偏移都是2或4或8的倍数.

  • 在没指定对齐方式时, 按照最大成员类型的字节长度的倍数对齐
  • 如果指定对齐方式, 则按照指定的对齐值和最大成员类型的字节长度之间取最小值对齐

下面我们分别使用不同的编排方式定义结构体类型.

编排方式 1

struct test
{
    int a;      // 4 pad 4
    double b;   // 8
    char c;     // 1 pad 7
}

// 内存分成连续三段, 每段8字节
// |XXXX____|XXXXXXXX|X______|
// 一共24字节, 浪费11字节

编排方式 2

struct test 
{
    int a;      // 4
    char c;     // 1 pad 3
    double b;   // 8
}

// 内存分成连续三段, 每段8字节
// |XXXXX___|XXXXXXXX|
// 一共16字节, 浪费3字节

引用成员

struct NorthEastF4
{
  char name[20];
  char sex;
  unsigned long birthday;
  float height;
  float weight;
};

struct NorthEastF4 boys[4] =
{
  {"莱昂纳多·小沈阳", 'M', 19810507, 1.74, 60},
  {"约翰尼·刘小宝", 'M',   19810105, 1.62, 50},
  {"克里斯蒂安·刘能",'M',  19690226, 1.72, 75},
  {"尼古拉斯·赵四",'M',    19740320, 1.71, 65}
};

NorthEastF4 bao = boys[1]; //拷贝
NorthEastF4 *p_bao = &boys[1];//指向

// 赋值时字符串长度不匹配报出异常
// boys[1].name = "约翰尼·宋小宝";

strcpy(bao.name, "约翰尼·宋小宝"); 

// 访问结构体成员
bao.name;
p_bao->height;
(*p_bao).weight;

指针

image-20200703111805657

image-20200703111614526

文件

了解文件的

  • 打开
  • 关闭
  • 写入
  • 读出

文件与流

程序的处理结果或计算结果会随着程序运行结束而消失.

因此要将程序运行结束后仍需保存的数值和字符等数据, 保存在文件 (file) 上.

针对文件、键盘、显示器、打印机等外部设备的数据读写操作都是通过流 (stream) 进行的, 我们可以想象成流淌着字符的水管.

C语言中的文件读写步骤

  1. 打开文件

    无论对文件进行读还是写操作, 都需要先打开文件, 打开文件用 fopen 函数.

  2. 读写文件

    写就是将内存中的数据存到文件中去. 主要是 fscanf 和 fprintf 函数.

  3. 关闭文件

    当文件不再使用时, 需将其关闭. 关闭文件用 fclose 函数.

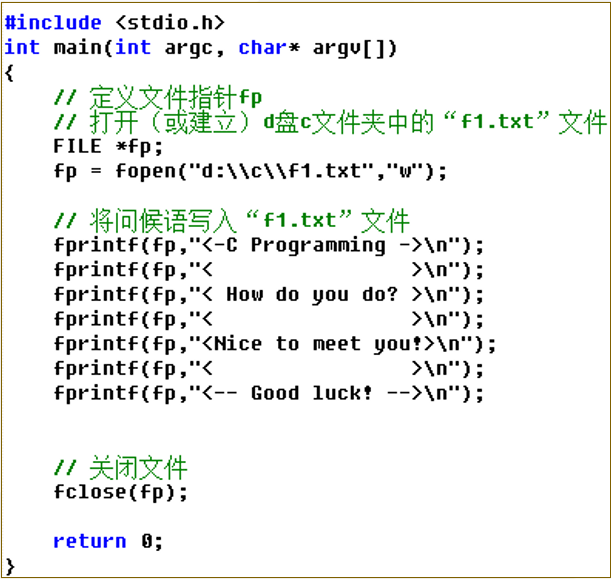
举例, 向 D:\c\f1.txt 中写入内容

image-20200702023113140

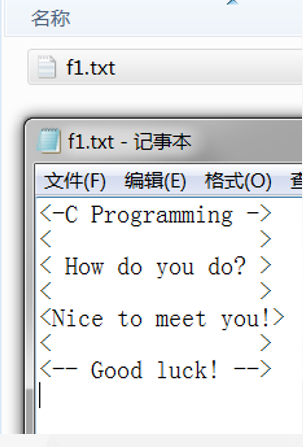
执行后, 打开f1.txt, 结果如下:

image-20200702023148607

格式输入输出

考试内容不涉及C++的写法

  • printf
  • scanf
  • gets
  • puts
  • getchar
  • getch

调试

给出一段代码, 可以很快指出代码存在的问题

常见编程问题

  • 判断质数: 1 3 5 7 9 11 13 17 19

  • 判断水仙花数: 153 370 371 401

  • 判断回文数: 101 111 121

  • foo-bar-baz

  • 猜大小游戏

  • 穷举法: 打印99乘法表

  • 穷举 + 过滤: 跳水成绩预测, 等式填数

  • 冒泡排序

  • 二分查找

  • 阶乘, 累加, 斐波那契序列等

其他注意事项

  • 考试都是C语言题目, 答题也使用C语言
  • 考试内容集中在3 - 9章
  • 这次不考或者很少涉及的内容有
    • 链表的具体实现
    • 使用指针动态分配和释放内存
    • 函数指针
    • 复杂递归算法实现
    • IO流和文件处理
  • 编程题需要手写编程
    • 唯手熟尔

Views: 323

← Index