大厂的 Git 代码管理规范

大厂的 Git 代码管理规范是怎样的?

​

以下文章来源于码农参上 ,作者Dr Hydra

分支命名

master 分支

master 为主分支,也是用于部署生产环境的分支,需要确保 master 分支稳定性。master 分支一般由 release 以及 hotfix 分支合并,任何时间都不能直接修改代码。

develop 分支

develop 为开发环境分支,始终保持最新完成以及 bug 修复后的代码,用于前后端联调。一般开发新功能时,feature 分支都是基于 develop 分支创建的。

feature 分支

开发新功能时,以 develop 为基础创建 feature 分支。

分支命名时以 feature/ 开头,后面可以加上开发的功能模块, 命名示例:feature/user_module、feature/cart_module。

test 分支

test 为测试环境分支,外部用户无法访问,专门给测试人员使用,版本相对稳定。

release 分支

release 为预上线分支(预发布分支),UAT 测试阶段使用。一般由 test 或 hotfix 分支合并,不建议直接在 release 分支上直接修改代码。

hotfix 分支

线上出现紧急问题时,需要及时修复,以 master 分支为基线,创建 hotfix 分支。修复完成后,需要合并到 master 分支和 develop 分支。

分支命名以hotfix/ 开头的为修复分支,它的命名规则与 feature 分支类似。

分支与环境对应关系

在系统开发过程中常用的环境:

  • DEV 环境(Development environment):用于开发者调试使用。
  • FAT 环境(Feature Acceptance Test environment):功能验收测试环境,用于测试环境下的软件测试者测试使用。
  • UAT 环境 (User Acceptance Test environment):用户验收测试环境,用于生产环境下的软件测试者测试使用。
  • PRO 环境(Production environment):生产环境。

对应关系:

分支 功能 环境 可访问
master 主分支,稳定版本 PRO 是
develop 开发分支,最新版本 DEV 是
feature 开发分支,实现新特性 否
test 测试分支,功能测试 FAT 是
release 预上线分支,发布新版本 UAT 是
hotfix 紧急修复分支,修复线上bug 否

分支合并流程规范

业界常见的两大主分支(master、develop)、三个辅助分支(feature、release、hotfix)的生命周期:

图片

以上生命周期仅作参考,不同开发团队可能有不同的规范,可自行灵活定义。

例如我们团队在开发时,至少需要保证以下流程:

  • develop 分支和 hotfix 分支,必须从 master 分支检出。
  • 由 develop 分支合并到 test 分支。
  • 功能测试无误后,由 test 分支合并到 release 分支。
  • UAT 测试通过后,由 release 分支合并到 master 分支。
  • 对于工作量小的功能开发(工时小于 1 天),可以直接在 devolop 分支进行开发,否则由 develop 分支检出 feature 分支进行开发,开发完后合并到develop 分支。

Git Commit Message 规范

Git Commit Message 规范指提交代码时编写的规范注释,编写良好的 Commit Message 可以达到 3 个重要的目的:

  • 加快代码 review 的流程。
  • 帮助我们编写良好的版本发布日志。
  • 让之后的维护者了解代码里出现特定变化和 feature 被添加的原因。

Angular Git Commit Guidelines

业界应用的比较广泛的是 Angular Git Commit Guidelines:

[type]([scope]): [subject]
[BLANK LINE]
[body]
[BLANK LINE]
[footer]
  • type:提交类型。
  • scope:可选项,本次 commit 波及的范围。
  • subject:简明扼要地阐述下本次 commit 的主旨,在Angular Git Commit Guidelines中强调了三点。使用祈使句,首字母不要大写,结尾无需添加标点。
  • body:同样使用祈使句,在主体内容中我们需要把本次 commit 详细地描述一下,比如此次变更的动机。
  • footer:描述下与之关联的 issue 或 break change。

简易版

项目中实际可以采用简易版规范:

[type]([scope]):[subject]

type 规范

Angular Git Commit Guidelines中推荐的 type 类型如下:

  • feat:新增功能。
  • fix:修复 bug。
  • docs:仅文档更改。
  • style:不影响代码含义的更改(空白、格式设置、缺失分号等)。
  • refactor:既不修复 bug 也不添加特性的代码更改。
  • perf:改进性能的代码更改。
  • test:添加缺少的测试或更正现有测试。
  • chore:对构建过程或辅助工具和库(如文档)的更改。

除此之外,还有一些常用的类型:

  • delete:删除功能或文件。
  • modify:修改功能。
  • build:改变构建流程,新增依赖库、工具等(例如 webpack、gulp、npm 修改)。
  • test:测试用例的新增、修改。
  • ci:自动化流程配置修改。
  • revert:回滚到上一个版本。

单次提交注意事项

  • 提交问题必须为同一类别。
  • 提交问题不要超过 3 个。
  • 提交的 commit 发现不符合规范,git commit --amend -m "新的提交信息"或 git reset --hard HEAD 重新提交一次。

配置 .gitignore 文件

.gitignore是一份用于忽略不必提交的文件的列表,项目中可以根据实际需求统一.gitignore文件,减少不必要的文件提交和冲突,净化代码库环境。

通用文件示例:

target/
!.mvn/wrapper/maven-wrapper.jar
!**/src/main/**/target/
!**/src/test/**/target/
### STS ###
.apt_generated
.classpath
.factorypath
.project
.settings
.springBeans
.sts4-cache
### IntelliJ IDEA ###
.idea
*.iws
*.iml
*.ipr
### NetBeans ###
/nbproject/private/
/nbbuild/
/dist/
/nbdist/
/.nb-gradle/
build/
!**/src/main/**/build/
!**/src/test/**/build/
### VS Code ###
.vscode/
# Log file
*.log
/logs*
# BlueJ files
*.ctxt
# Mobile Tools for Java (J2ME)
.mtj.tmp/
# Package Files #
*.jar
*.war
*.ear
*.zip
*.tar.gz
*.rar
*.cmd

其他

此外,还有一些其他建议:

  • master 分支的每一次更新,都建议打 tag 添加标签,通常为对应版本号,便于管理。
  • feature 分支、hotfix 分支在合并后可以删除,避免分支过多,管理混乱。
  • 每次 pull 代码前,提交本地代码到本地库中,否则可能会出现合并代码出错,导致代码丢失。

Views: 43

使用chrony完成集群时间同步

在RHEL 8+中,你可以使用Chrony来在集群中进行时间同步。

集群时间同步配置步骤

已知集群的ip和主机映射配置文件/etc/hosts的内容如下所示:

192.168.10.102 niit01
192.168.10.103 niit02
192.168.10.104 niit03

以下是步骤:

安装chrony到集群中

确保所有服务器上都已经安装了chrony。如果没有安装,可以使用以下命令进行安装(三台机器都需要):

sudo yum install -y chrony

在niit01服务器上

编辑Chrony配置文件。使用文本编辑器打开/etc/chrony.conf文件:

sudo vi /etc/chrony.conf

在配置文件中找到pool部分,并注释掉原有的服务器地址(如果有的话)。因为我们将使用niit01作为时间同步服务器,所以不需要从外部服务器获取时间同步。

pool niit01 iburst

在配置文件中添加以下行,以允许其他服务器从niit01同步时间:

allow 192.168.0.0/16

这将允许子网中的所有服务器从niit01同步时间。根据你的网络设置,可能需要修改子网地址。

保存并关闭配置文件/etc/chrony.conf。

启动chronyd服务,并确保其在系统启动时自动启动:

sudo systemctl enable --now chronyd

在niit02和niit03服务器上

编辑chrony配置文件/etc/chrony.conf:

sudo vi /etc/chrony.conf

在配置文件中找到pool部分,并注释掉原有的服务器地址(如果有的话)。这是因为我们将使用niit01作为时间同步服务器。

在配置文件中添加以下行,以指定从niit01同步时间:

pool niit01 iburst

这将指定niit01作为时间同步服务器,并使用iburst选项以更快地同步时间。

保存并关闭配置文件。

启动chronyd服务,并确保其在系统启动时自动启动:

sudo systemctl enable --now chronyd

现在,niit02和niit03服务器将开始从niit01服务器同步时间。你可以使用以下命令来检查时间同步状态:

image-20230918133709762

这将显示时间同步状态,包括偏差、延迟等信息。如果一切正常,你应该看到niit02和niit03服务器的时间与niit01服务器同步。

如果要查看不同的授时服务器的详情, 也可以使用这个命令

image-20230918134014631

集群时间同步测试步骤

首先,在niit01服务器上修改时间。你可以使用以下命令来更改时间:

sudo timedatectl set-time 'YYYY-MM-DD HH:MM:SS'

将 'YYYY-MM-DD HH:MM:SS' 替换为你想要设置的时间。例如,要将时间设置为2023年7月19日下午3点30分,你可以使用以下命令:

sudo timedatectl set-time '2023-07-19 15:30:00'

确保niit01服务器上的Chrony服务正在运行。如果服务未运行,请使用以下命令启动它:

sudo systemctl start chronyd

在niit02和niit03服务器上执行以下命令,以检查它们是否能够与niit01服务器同步时间:

chronyc tracking

这将显示时间同步状态。你应该能够看到niit02和niit03服务器的时间与niit01服务器同步。

如果时间同步状态正常,你可以使用以下命令检查服务器上的当前时间:

date

确保niit02和niit03服务器上的时间与niit01服务器上的时间相同。

这样,你就可以测试niit02和niit03服务器是否能够与niit01服务器同步时间了。

集群时间同步脚本编写

由于我们接下来的项目中需要生成从指定日期开始, 例如2023年6月30日开始的连续7日数据. 需要使用一个集群时间同步脚本来更改并同步时间, 文件名为:

#!/bin/bash

# 检查参数是否为空
if [ -z "$1" ]; then
        echo "Usage:  <code>basename $0 yyyy-MM-dd HH:mm:ss"
  exit 1
fi

# 使用date命令将时间字符串转换为日期和时间
# 如果转换失败,则说明时间字符串不合法
if ! date -d "$*" >/dev/null 2>&1; then
        echo "Wrong argument for $*"
        echo "Usage:  basename $0 \"yyyy-MM-dd HH:mm:ss\""
  exit 1
fi

echo ">>>>>>>>>>>> SYNC TIME START >>>>>>>>>>>>"
sum=-1

while [ $sum -ne 0 ]; do
  echo set time for niit01 to $1 '>>>'
  ssh niit01 "sudo date -s \"$*\""
  ok1=$?
  echo sync time from niie02 to niit01 '>>>'
  ssh niit02 "(sudo timedatectl set-ntp false && sudo timedatectl set-ntp true)"
  ok2=$?
  echo sync time from niit03 to niit01 '>>>'
  ssh niit03 "(sudo timedatectl set-ntp false && sudo timedatectl set-ntp true)"
  ok3=$?
  sum=expr $ok1 + $ok2 + $ok3

  if [ $sum -eq 0 ]; then
    echo "<<<<<<<<<<<<< SYNC TIME END <<<<<<<<<<<<<"
    sleep 5
    xRun.sh date
  else
    echo "sync time failed, will try 10 senconds later"
    sleep 10
  fi
done

由于ntp同步只能用于微小的时间调整, 大幅度的时间调整前需要先关闭ntp时间同步, 调整后再开启. 开启后大约需要1秒的时间完成同步过程.

用法: 比如需要将集群的时间同步至2023-06-30 06:00:00, 可以这样

[niit@niit01 bin]$ xSyncTime.sh 2023-06-30 06:00:00
>>>>>>>>>>>> SYNC TIME START >>>>>>>>>>>>
set time for niit01 to 2023-06-30 >>>
Fri Jun 30 06:00:00 CST 2023
sync time from niie02 to niit01 >>>
sync time from niit03 to niit01 >>>
<<<<<<<<<<<<< SYNC TIME END <<<<<<<<<<<<<
===========niit01 ===========
ssh niit01 date
Fri Jun 30 06:00:06 CST 2023
===========niit02 ===========
ssh niit02 date
Fri Jun 30 06:00:06 CST 2023
===========niit03 ===========
ssh niit03 date
Fri Jun 30 06:00:06 CST 2023

Views: 215

[ZooKeeper] 3- 伪分布式集群搭建 以及 ZooKeeper 的事务和选举机制

伪分布式集群搭建

  • Q: 为什么要搭建伪分布式集群?
  • A: 为了更好的理解 ZooKeeper 的工作原理, 以及更好的理解 ZooKeeper 的应用场景.

ZooKeeper 伪分布式集群(单机多进程)搭建步骤

  1. 下载和安装

下载,解压,配置环境变量就不多说了,和其他框架都大致一样

版本选择 3.4.14


  1. 单机多服务配置

在 conf 目录下创建三个配置文件


zoo-1.cfg

tickTime=2000
initLimit=10
syncLimit=5
dataDir=/opt/tmp/zk-1
dataLogDir=/opt/tmp/zk-log-1
clientPort=2181

4lw.commands.whitelist=*
server.1=localhost:2891:3891
server.2=localhost:2892:3892
server.3=localhost:2893:3893

zoo-2.cfg

tickTime=2000
initLimit=10
syncLimit=5
dataDir=/opt/tmp/zk-2
dataLogDir=/opt/tmp/zk-log-2
clientPort=2182

4lw.commands.whitelist=*
server.1=localhost:2891:3891
server.2=localhost:2892:3892
server.3=localhost:2893:3893

zoo-3.cfg

tickTime=2000
initLimit=10
syncLimit=5
dataDir=/opt/tmp/zk-3
dataLogDir=/opt/tmp/zk-log-3
clientPort=2183

4lw.commands.whitelist=*
server.1=localhost:2891:3891
server.2=localhost:2892:3892
server.3=localhost:2893:3893

  • 4lw: 4 letter word 的缩写,代表着 ZooKeeper 服务器的内部命令,这里是为了方便我们查看 ZooKeeper 服务器的运行状态,所以将这个命令列入白名单,允许我们通过客户端来执行这个命令(关于 4lw 的使用后续的章节再进行讲解)。

  • server.x=ip:port:port: 这个配置项是用来配置集群中的每个服务器的,x 代表服务器的编号,ip 代表服务器的 IP 地址,port 代表服务器的端口号,这里的端口号是用来和集群中的其他服务器进行通信的端口号,也就是说,这个端口号是用来和集群中的其他服务器进行通信的 (而不是用来和客户端进行通信的,客户端和服务器通信的端口号是由 clientPort 配置项来指定的)

    • 28xx 是 Leader 暴露的端口, 用于处理写请求和数据同步
    • 38xx 端口是用于 Leader 选举时使用的端口,

接下来在三个配置文件中dataDir所指向的目录里面分别建立一个 myid 文件, 里面分别保存数字 1, 2, 3,假设数字为 x 对应配置文件中的 server.x=...,这个 x 代表 ZooKeeper 的服务器 ID 编号, 集群中的每个服务器的 ID 编号都应该是唯一的正整数。

mkdir -p /opt/tmp/zk-1
mkdir -p /opt/tmp/zk-2
mkdir -p /opt/tmp/zk-3

echo 1 > /opt/tmp/zk-1/myid
echo 2 > /opt/tmp/zk-2/myid
echo 3 > /opt/tmp/zk-3/myid

4、zk 服务相关命令

# 启动 zoo-1.cfg 所配置的 ZooKeeper 服务器
zkServer.sh start conf/zoo-1.cfg
# 检查 zoo-1.cfg 所配置的 ZooKeeper 服务器运行状态
zkServer.sh status conf/zoo-1.cfg
# 停止 zoo-1.cfg 所配置的 ZooKeeper 服务器
zkServer.sh stop conf/zoo-1.cfg

观察 Leader 选举过程

  1. 启动三个 ZooKeeper 服务器

    zkServer.sh start conf/zoo-1.cfg
    zkServer.sh start conf/zoo-2.cfg
    zkServer.sh start conf/zoo-3.cfg
  2. 查看三个 ZooKeeper 服务器的运行状态

    zkServer.sh status conf/zoo-1.cfg
    zkServer.sh status conf/zoo-2.cfg
    zkServer.sh status conf/zoo-3.cfg

    可以看到服务器 2 为 Leader.


观察崩溃恢复过程

  1. 停止 id 为 2 的 ZooKeeper 服务器

    zkServer.sh stop conf/zoo-2.cfg
  2. 查看三个 ZooKeeper 服务器的运行状态

    zkServer.sh status zoo-1.cfg
    zkServer.sh status zoo-2.cfg
    zkServer.sh status zoo-3.cfg

    可以看到服务器 3 为 Leader.


  1. 如果此时停止 id 为 3 的服务器会怎样?

    前面已经停止了服务器 2, 如果再停止服务器 3, 则只有一台服务器 1 在运行, 少于等于集群中总服务器数量的一半, 此时集群将无法正常工作, 服务器 1 将自杀, 无法提供服务.


  1. 查看服务器日志文件
tail -F zookeeper.out

默认日志文件会在执行启动服务命令时的当前目录下生成, 默认日志文件名为 zookeeper.out
如果想要指定日志文件生成的位置:

  1. 可以在启动服务时, 指定日志文件生成的位置:添加一个系统属性: -Dzookeeper.log.dir=${ZOOKEEPER_HOME}/logs}
  2. 或者导出环境变量: export ZOO_LOG_DIR=${ZOOKEEPER_HOME}/logs

ZooKeeper 的事务和选举功能

在 ZooKeeper 服务器集群中,一个服务器被选为领导者,其余所有服务器被选为追随者。leader 负责处理所有向 ZooKeeper 服务的写请求(事务性请求)。追随者接收领导者提出的写操作,并通过多数共识机制(majority consensus mechanism)实现数据的一致性。


Zookeeper 服务器角色

Zookeeper 集群中,有 Leader、Follower 和 Observer 三种角色


  • Leader: Leader 服务器是整个 ZooKeeper 集群工作机制中的核心,其主要工作:

    • 事务请求的唯一调度和处理者,保证集群事务处理的顺序性
    • 集群内部各服务的调度者
  • Follower: Follower 服务器是 ZooKeeper 集群状态的跟随者,其主要工作:

    • 处理客户端非事务请求,转发事务请求给 Leader 服务器
    • 参与事务请求 Proposal(提案)的投票
    • 参与 Leader 选举投票
  • Observer: Observer 是 3.3.0 版本开始引入的一个服务器角色,它充当一个观察者角色——观察 ZooKeeper 集群的最新状态变化并将这些状态变更同步过来。其工作:

    • 处理客户端的非事务请求,转发事务请求给 Leader 服务器
    • 不参与任何形式的投票

ZooKeeper 启动过程的 Leader 选举机制

在 ZooKeeper 集群启动时,需要在集群中的服务器之间确定一台 Leader 服务器。当 ZooKeeper 集群中的三台服务器启动之后,首先会进行通信检查,如果集群中的服务器之间能够进行通信。集群中的三台机器开始尝试寻找集群中的 Leader 服务器并进行数据同步等操作。


如何这时没有搜索到 Leader 服务器,说明集群中不存在 Leader 服务器。这时 ZooKeeper 集群开始发起 Leader 服务器选举。


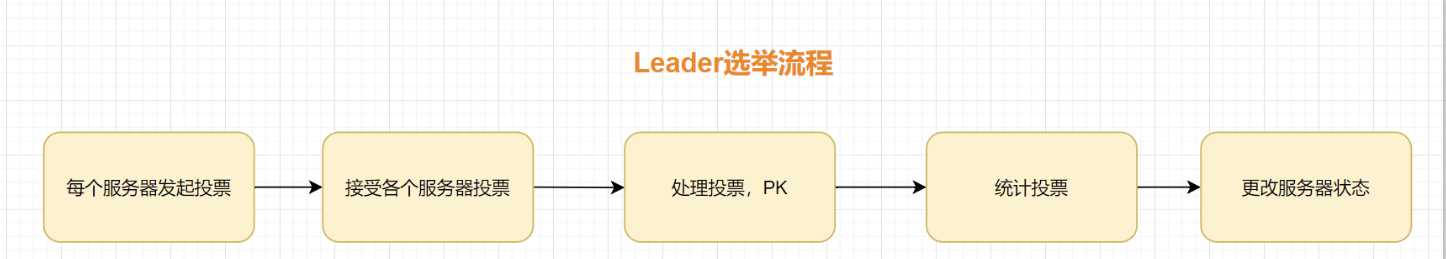
在整个 ZooKeeper 集群中 Leader 选举主要可以分为三大步骤分别是:
发起投票、接收投票、统计投票。

w:36em


  • 发起投票
    我们先来看一下发起投票的流程,在 ZooKeeper 服务器集群初始化启动的时候,集群中的每一台服务器都会将自己作为 Leader 服务器进行投票。也就是每次投票时,发送的服务器的 myid(服务器标识符)和 ZXID (集群投票信息标识符)等选票信息字段都指向本机服务器。 而一个投票信息就是通过这两个字段组成的。以集群中三个服务器 Serverhost1、Serverhost2、Serverhost3 为例,三个服务器的投票内容分别是:Severhost1 的投票是(1,0)、Serverhost2 服务器的投票是(2,0)、Serverhost3 服务器的投票是(3,0)。

  • 接收投票
    集群中各个服务器在发起投票的同时,也通过网络接收来自集群中其他服务器的投票信息。

    在接收到网络中的投票信息后,服务器内部首先会判断该条投票信息的有效性。检查该条投票信息的时效性,是否是本轮最新的投票,并检查该条投票信息是否是处于 LOOKING 状态的服务器发出的。


服务器有四种状态:

  1. LOOKING:寻找 Leader 状态。当服务器处于该状态时,它会认为当前集群中没有 Leader,因此需要进入 Leader 选举状态。
  2. FOLLOWING:跟随者状态。表明当前服务器角色是 Follower。
  3. LEADING:领导者状态。表明当前服务器角色是 Leader。
  4. OBSERVING:观察者状态。表明当前服务器角色是 Observer。

  • 统计投票
    在接收到投票后,ZooKeeper 集群就该处理和统计投票结果了。对于每条接收到的投票信息,集群中的每一台服务器都会将自己的投票信息与其接收到的 ZooKeeper 集群中的其他投票信息进行对比。主要进行对比的内容是(myid, ZXID),ZXID 数值比较大的投票信息优先作为 Leader 服务器。如果每个投票信息中的 ZXID 相同,就会接着比对投票信息中的 myid 信息字段,选举出 myid 较大的服务器作为 Leader 服务器。

    注释:
    事务 ID,即 zxid。ZooKeeper 的在选举时通过比较各结点的 zxid 和机器 ID 选出新的主结点的。zxid 由 Leader 节点生成,有新写入事件时,Leader 生成新 zxid 并随提案一起广播,每个结点本地都保存了当前最近一次事务的 zxid,zxid 是递增的,所以谁的 zxid 越大,就表示谁的数据是最新的。


集群初始化时的选举过程

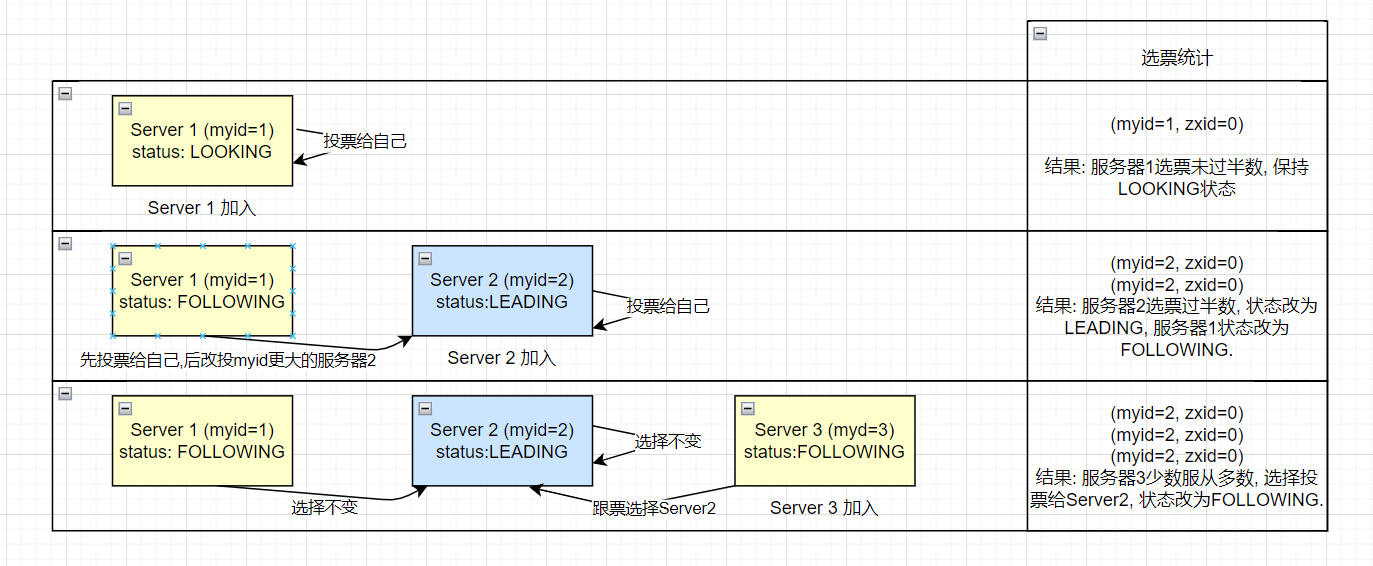
zookeeper 集群初始化阶段,服务器(myid=1-3)依次启动,开始选举 Leader:

  • 服务器 1(myid=1)启动,当前只有一台服务器,无法完成 Leader 选举, 服务器状态为 LOOKING.
  • 服务器 2(myid=2)启动,此时两台服务器能够相互通讯,开始进入 Leader 选举阶段

Leader 选举阶段
  1. 每个服务器发出一个投票: 服务器 1 和 服务器 2 都将自己作为 Leader 服务器进行投票,然后各自将这个投票发给集群中的其他所有机器。

    投票的基本元素包括:服务器的 myid 和 ZXID,我们以(myid,ZXID)形式表示。初始阶段,服务器 1 和服务器 2 都会投给自己,即服务器 1 的投票为(1,0),服务器 2 的投票为(2,0).

  2. 接受来自各个服务器的投票: 每个服务器都会接受来自其他服务器的投票。同时,服务器会校验投票的有效性,是否本轮投票、是否来自 LOOKING 状态的服务器。

  1. 处理投票: 收到其他服务器的投票,会将别人的投票跟自己的投票 PK,PK 规则如下优先检查 ZXID。ZXID 比较大的服务器优先作为 leader。如果 ZXID 相同的话,就比较 myid,由 myid 比较大的服务器作为 leader。

    服务器 1 的投票是(1,0),它收到投票是(2,0),两者 zxid 都是 0,因为收到的 myid=2,大于自己的 myid=1,所以它更新自己的投票为(2,0),然后重新将投票发出去。

    对于服务器 2 呢,即不再需要更新自己的投票,把上一次的投票信息发出即可。


  1. 统计投票: 每次投票后,服务器会统计所有投票,判断是否有过半的机器接受到相同的投票信息。服务器 2 收到两票,因为已经过半,所以它进入 LEADING 状态,成为 Leader 服务器, 服务器 1 则成为 Follower 服务器。

    如果选票统计时发现某一服务器获得的选票数大于等于(n/2+1,n 为总服务器)则进入 LEADING 状态,成为 Leader 服务器。
    反之如果少于(n/2+1,n 为总服务器)则继续保持 LOOKING 状态, 进行下一轮投票, 直到选出 Leader。


Q: 当服务器 1 和服务器 2 进行选票统计时, 如何得知半数选票是多少?

A:

通过服务器配置文件可知。


  1. 由于此时 Leader 服务器已经确定是服务器 2, 启动服务器 3 加入了集群, 此时服务器 1 和 2 的角色已经不是 LOOKING, 不会更改选票信息和交换投票信息, 服务器 3 服从多数, 更改选票信息为服务器 2, 更改状态为 FOLOWER, 成为服务器 2 的 FOLLOWER.

bg fit


思考: 推演拥有 5 个节点的 ZooKeeper 集群的 Leader 选举过程


Leader 崩溃后的选举过程

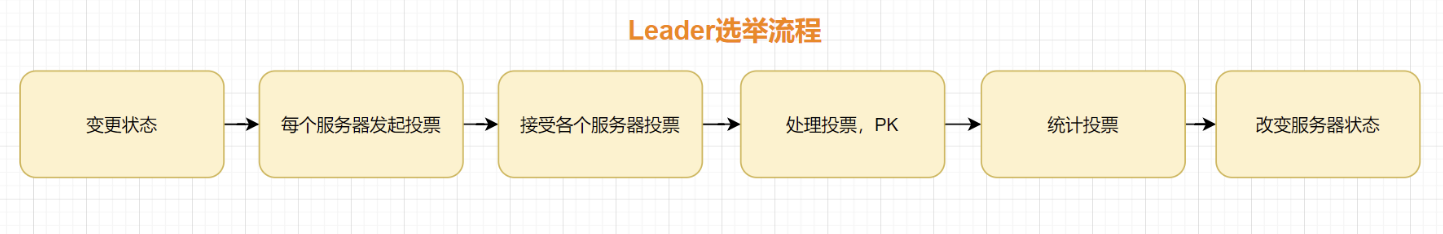
假设 Leader 服务器 2(myid=2)宕机,由于集群中没有了 Leader 节点, 此时会触发以下选举流程。

w:36em


  1. 变更状态: Leader 服务器挂了之后,余下的非 Observer 服务器都会把自己的服务器状态更改为 LOOKING,然后开始进入 Leader 选举流程。

  2. 每个服务器发起投票,每个服务器都把票投给自己

    因为是运行期间,所以每台服务器的 ZXID 可能不相同。假设服务 1,3 的 zxid 分别为 333,666,则分别产生投票(1,333),(3,666),然后各自将这个投票发给集群中的其他所有机器。

  3. 接受来自各个服务器的投票

  4. 处理投票

    投票规则是优先检查 ZXID,大的优先作为 Leader,所以显然服务器 zxid=666 具有优先权。

  5. 统计投票

  6. 改变服务器状态


需要注意的是, 在 Leader 选举过程中, ZooKeeper 不能对外提供服务。
源码学习: org.apache.zookeeper.server.quorum.FastLeaderElection


为什么需要 Leader 服务器

Zookeeper 中主要依赖 Zab 协议来实现数据一致性,基于该协议,zk 实现了一种主备模型(即 Leader 和 Follower 模型)的系统架构来保证集群中各个副本之间数据的一致性。
这里的主备系统架构模型,就是指只有一台客户端(Leader)负责处理外部的写事务请求,然后 Leader 客户端将数据同步到其他 Follower 节点。


什么是 ZAB 协议?

Zab 协议 的全称是 Zookeeper Atomic Broadcast (Zookeeper 原子广播)。Zab 协议是为分布式协调服务 Zookeeper 专门设计的一种 支持崩溃恢复 的 原子广播协议 ,是 Zookeeper 保证分布式事务的最终一致性的核心算法。

  • ZAB 协议是一个基于消息广播的一致性协议,它可以保证在任何情况下,ZooKeeper 集群中的每个服务器上的数据最终都是一致的。
  • ZAB 协议是一个两阶段提交协议,它包括两个阶段: 崩溃恢复(新 leader 选举)和原子广播。

协议过程

当整个集群启动过程中,或者当 Leader 服务器出现网络中断、崩溃退出或重启等异常时,Zab 协议就会 进入崩溃恢复模式,选举产生新的 Leader。

当选举产生了新的 Leader,同时集群中有过半的机器与该 Leader 服务器完成了状态同步(即数据同步)之后,Zab 协议就会退出崩溃恢复模式,进入消息广播模式。

这时,如果有一台遵守 Zab 协议的服务器加入集群,因为此时集群中已经存在一个 Leader 服务器在广播消息,那么该新加入的服务器自动进入恢复模式:找到 Leader 服务器,并且完成数据同步。同步完成后,作为新的 Follower 一起参与到消息广播流程中。


协议状态切换

当 Leader 出现崩溃退出或者机器重启,亦或是集群中不存在超过半数的服务器与 Leader 保存正常通信,Zab 就会再一次进入崩溃恢复,发起新一轮 Leader 选举并实现数据同步。同步完成后又会进入消息广播模式,接收事务请求。


保证消息有序

在整个消息广播中,Leader 会将每一个事务请求转换成对应的 proposal 来进行广播,并且在广播 事务 Proposal 之前,Leader 服务器会首先为这个事务 Proposal 分配一个全局单递增的唯一 ID,称之为事务 ID(即 zxid),由于 Zab 协议需要保证每一个消息的严格的顺序关系,因此必须将每一个 proposal 按照其 zxid 的先后顺序进行排序和处理。


Zab 协议实现的作用

  1. 使用一个单一的主进程(Leader)来接收并处理客户端的事务请求(也就是写请求),并采用了 Zab 的原子广播协议,将服务器数据的状态变更以 事务 proposal (事务提议)的形式广播到所有的副本(Follower)进程上去。

  2. 保证一个全局的变更序列被顺序引用。
    Zookeeper 是一个树形结构,很多操作都要先检查才能确定是否可以执行,比如 P1 的事务 t1 可能是创建节点"/a",t2 可能是创建节点"/a/bb",只有先创建了父节点"/a",才能创建子节点"/a/b"。

    为了保证这一点,Zab 要保证同一个 Leader 发起的事务要按顺序被 apply,同时还要保证只有先前 Leader 的事务被 apply 之后,新选举出来的 Leader 才能再次发起事务。

  3. 当主进程出现异常的时候,整个 zk 集群依旧能正常工作。


使用 ZooKeeper 实现 Leader 选举

假设一个集群中有 N 个节点。下面是一个通过 ZooKeeper 来实现 Leader 选举的简单流程:

  • 所有节点都创建了一个有序临时 znode,它们路径相同,
    /app/leader_election/guid_。
  • ZooKeeper 集成会将 10 位序列号附加到路径上,创建的 znode 将是
    /app/leader_election/guid_0000000001,
    /app/leader_election/guid_0000000002...。

  • 让 znode 最小的节点成为 leader,其他节点都是 follower。
  • 每个 follower 节点都监视序号小于它的前一个 znode。例如:
    创建 znode /app/leader_election/guid_0000000008 的节点将监视 znode /app/leader_election/guid_0000000007;
    创建 znode /app/leader_election/guid_0000000007 的节点将监视 znode /app/leader_election/guid_0000000006。

  • 如果 leader 下线,那么它对应的 znode /app/leader_election/guid_000000000N 被删除。
  • 下一个 follower 节点将通过 watcher 获得关于 leader 移除的通知。
  • 下一个 follower 节点将检查是否有其他最小的 znode。如果没有,那么它将承担领导者的角色。否则,它将查找创建 znode 中序列数字最小的节点作为 leader。
  • 类似地,所有其他跟随节点选择创建 znode 中序列数字最小的节点作为 leader。

领导选举的最后一步是领导激活。新当选的领导者提出一个 NEW_LEADER 提议,只有在 NEW_LEADER 提议被集合中的大多数服务器(法定人数)认可之后,领导者才会被激活。在提交 NEW_LEADER 提案之前,新的领导者不会接受新的提案。因此, 集群中存活的服务器数必须过半数,否则领导者将永远不会被激活。


原子广播(Atomic Broadcast)

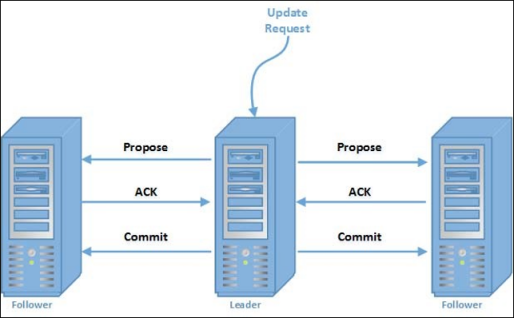
ZooKeeper 中所有写请求都会被转发给 leader。领导者向集合中的追随者广播更新。只有在大多数追随者承认他们坚持了更改之后,领导者才会提交更新。ZooKeeper 使用 ZAB 协议来达成共识,它被设计成原子的。因此,更新要么成功,要么失败。在 leader 故障时,集合中的其他服务器输入 leader 选举算法,在它们之间选举一个新的 leader。


ZooKeeper 中的事务实现

w:22em

ZAB 保证了事务交付和事务提交中的严格顺序。


练习问题


  1. ZooKeeper 中的数据寄存器称为___。
    a.ZooKeeper Ensemble
    b.ZNODES
    c.Watcher
    d.Leader

    答案

    b


  1. 在显式删除之前,哪种类型的 znode 在 ZooKeeper 的命名空间中具有生命周期?
    a.Ephemeral Sequential
    b.Persistent
    c.Persistent Sequential

    答案

    b & c


  1. 下面哪个选项对于触发 ZooKeeper Watch 是正确的?
    a.对 znode 数据的任何更改,例如使用 setData 操作将新数据写入 znode 的数据字段。
    b.对 znode 子节点的任何更改。例如,使用 delete 操作删除 znode 的子节点。
    c.创建或删除 znode,这可能发生在将新的 znode 添加到路径或删除现有 znode 的情况下。
    d.以上所有

    答案

    d


  1. 考虑下面的语句,找到正确的选项:

    A:ZAB 协议确保集群中的本地副本永远不会偏离。

    B: ZAB 协议是原子性的,因此该协议保证更新成功或失败。

    A. 只有 A 是正确的
    B. 只有 B 是正确的
    c. A 和 B 都是真的
    d. A 和 B 都是假的

    答案

    c


小结

在本章中,你学习了:

  • 客户端可以通过连接到集成的任何成员来连接到 ZooKeeper 服务。
  • ZooKeeper 允许分布式进程通过数据寄存器的共享分层命名空间相互协调。
  • ZooKeeper 数据模型中的每个 znode 都维护一个 stat 结构,该结构简单地提供 znode 的元数据。
  • Stat 结构有 4 个不同的信息:
  • 版本号
  • 动作控制列表
  • 时间戳
  • 数据长度

  • ZooKeeper 主要有两种类型的 znode: persistent 和 ephemeral。还有第三种类型称为 sequential znode,它是另外两种类型的一种限定符。
    • watch 是一种简单的机制,让客户端获得关于 ZooKeeper 集合变化的通知。
    • watch 只触发一次。如果客户端希望再次收到通知,则必须仓鞥捏 in 设置监听(比如通过 Get 操作)。
    • ZooKeeper 确保 watch 始终按照先进先出(FIFO)的方式进行排序,通知始终按照顺序发送。

  • ZooKeeper 中的所有读操作——getData()、getChildren()和 exists() - 都可以设置一个通知客户端的监视(对应四个 ZkCli 命令: get、ls、ls2 和 stat)。
  • 在服务器集合中,一个服务器被选为 leader,其余的服务器被选为 follower。leader 负责处理所有更改 ZooKeeper 服务的事务请求。追随者收到领导者的广播后更新数据。
  • ZAB (ZooKeeper Atomic Broadcast)是一种原子消息传递协议,它确保集成中的本地副本的数据一致性。

Views: 524