数据集介绍与划分
学习目标
目标知道数据集的分为训练集和测试集 知道sklearn的分类、回归数据集 拿到的数据是否全部都用来训练一个模型?
数据集的划分
机器学习一般的数据集会划分为两个部分:
训练数据:用于训练,构建模型 测试数据:在模型检验时使用,用于评估模型是否有效 划分比例:
训练集:70% 80% 75% 测试集:30% 20% 30% API
sklearn.model_selection.train_test_split(arrays, * options)x 数据集的特征值 y 数据集的标签值 test_size 测试集的大小,一般为float random_state 随机数种子,不同的种子会造成不同的随机采样结果。相同的种子采样结果相同。 return ,测试集特征训练集特征值值,训练标签,测试标签(默认随机取) 结合后面的数据集作介绍
sklearn数据集介绍
API
sklearn.datasets加载获取流行数据集 datasets.load_*() datasets.fetch_*(data_home=None)获取大规模数据集,需要从网络上下载,函数的第一个参数是data_home,表示数据集下载的目录,默认是 ~/scikit_learn_data/ 分类和回归数据集
sklearn.datasets.fetch_20newsgroups(data_home=None,subset=‘train’)subset: 'train'或者'test','all',可选,选择要加载的数据集.训练集的“训练”,测试集的“测试”,两者的“全部” 回归数据集 返回类型
load和fetch 返回的数据类型datasets.base.Bunch(字典格式)data:特征数据数组,是 [n_samples * n_features] 的二维 numpy.ndarray 数组 target:标签数组,是 n_samples 的一维 numpy.ndarray 数组 DESCR:数据描述 feature_names:特征名,新闻数据,手写数字、回归数据集没有 target_names:标签名 sklearn转换器和估计器
学习目标
转换器和估计器
转换器
想一下之前做的特征工程的步骤?
1、实例化 (实例化的是一个转换器类(Transformer)) 2、调用fit_transform(对于文档建立分类词频矩阵,不能同时调用) 我们把特征工程的接口称之为转换器,其中转换器调用有这么几种形式
fit_transform fit transform 这几个方法之间的区别是什么呢?我们看以下代码就清楚了
In [1]: from sklearn.preprocessing import StandardScaler

In [2]: std1 = StandardScaler()

In [3]: a = [[1,2,3], [4,5,6]]

In [4]: std1.fit_transform(a)
Out[4]:
array([[-1., -1., -1.],
       [ 1.,  1.,  1.]])

In [5]: std2 = StandardScaler()

In [6]: std2.fit(a)
Out[6]: StandardScaler(copy=True, with_mean=True, with_std=True)

In [7]: std2.transform(a)
Out[7]:
array([[-1., -1., -1.],
       [ 1.,  1.,  1.]])
从中可以看出,fit_transform的作用相当于transform加上fit。但是为什么还要提供单独的fit呢, 我们还是使用原来的std2来进行标准化看看
In [8]: b = [[7,8,9], [10, 11, 12]]

In [9]: std2.transform(b)
Out[9]:
array([[3., 3., 3.],
       [5., 5., 5.]])

In [10]: std2.fit_transform(b)
Out[10]:
array([[-1., -1., -1.],
       [ 1.,  1.,  1.]])
估计器(sklearn机器学习算法的实现)
在sklearn中,估计器(estimator)是一个重要的角色,是一类实现了算法的API
1、用于分类的估计器:
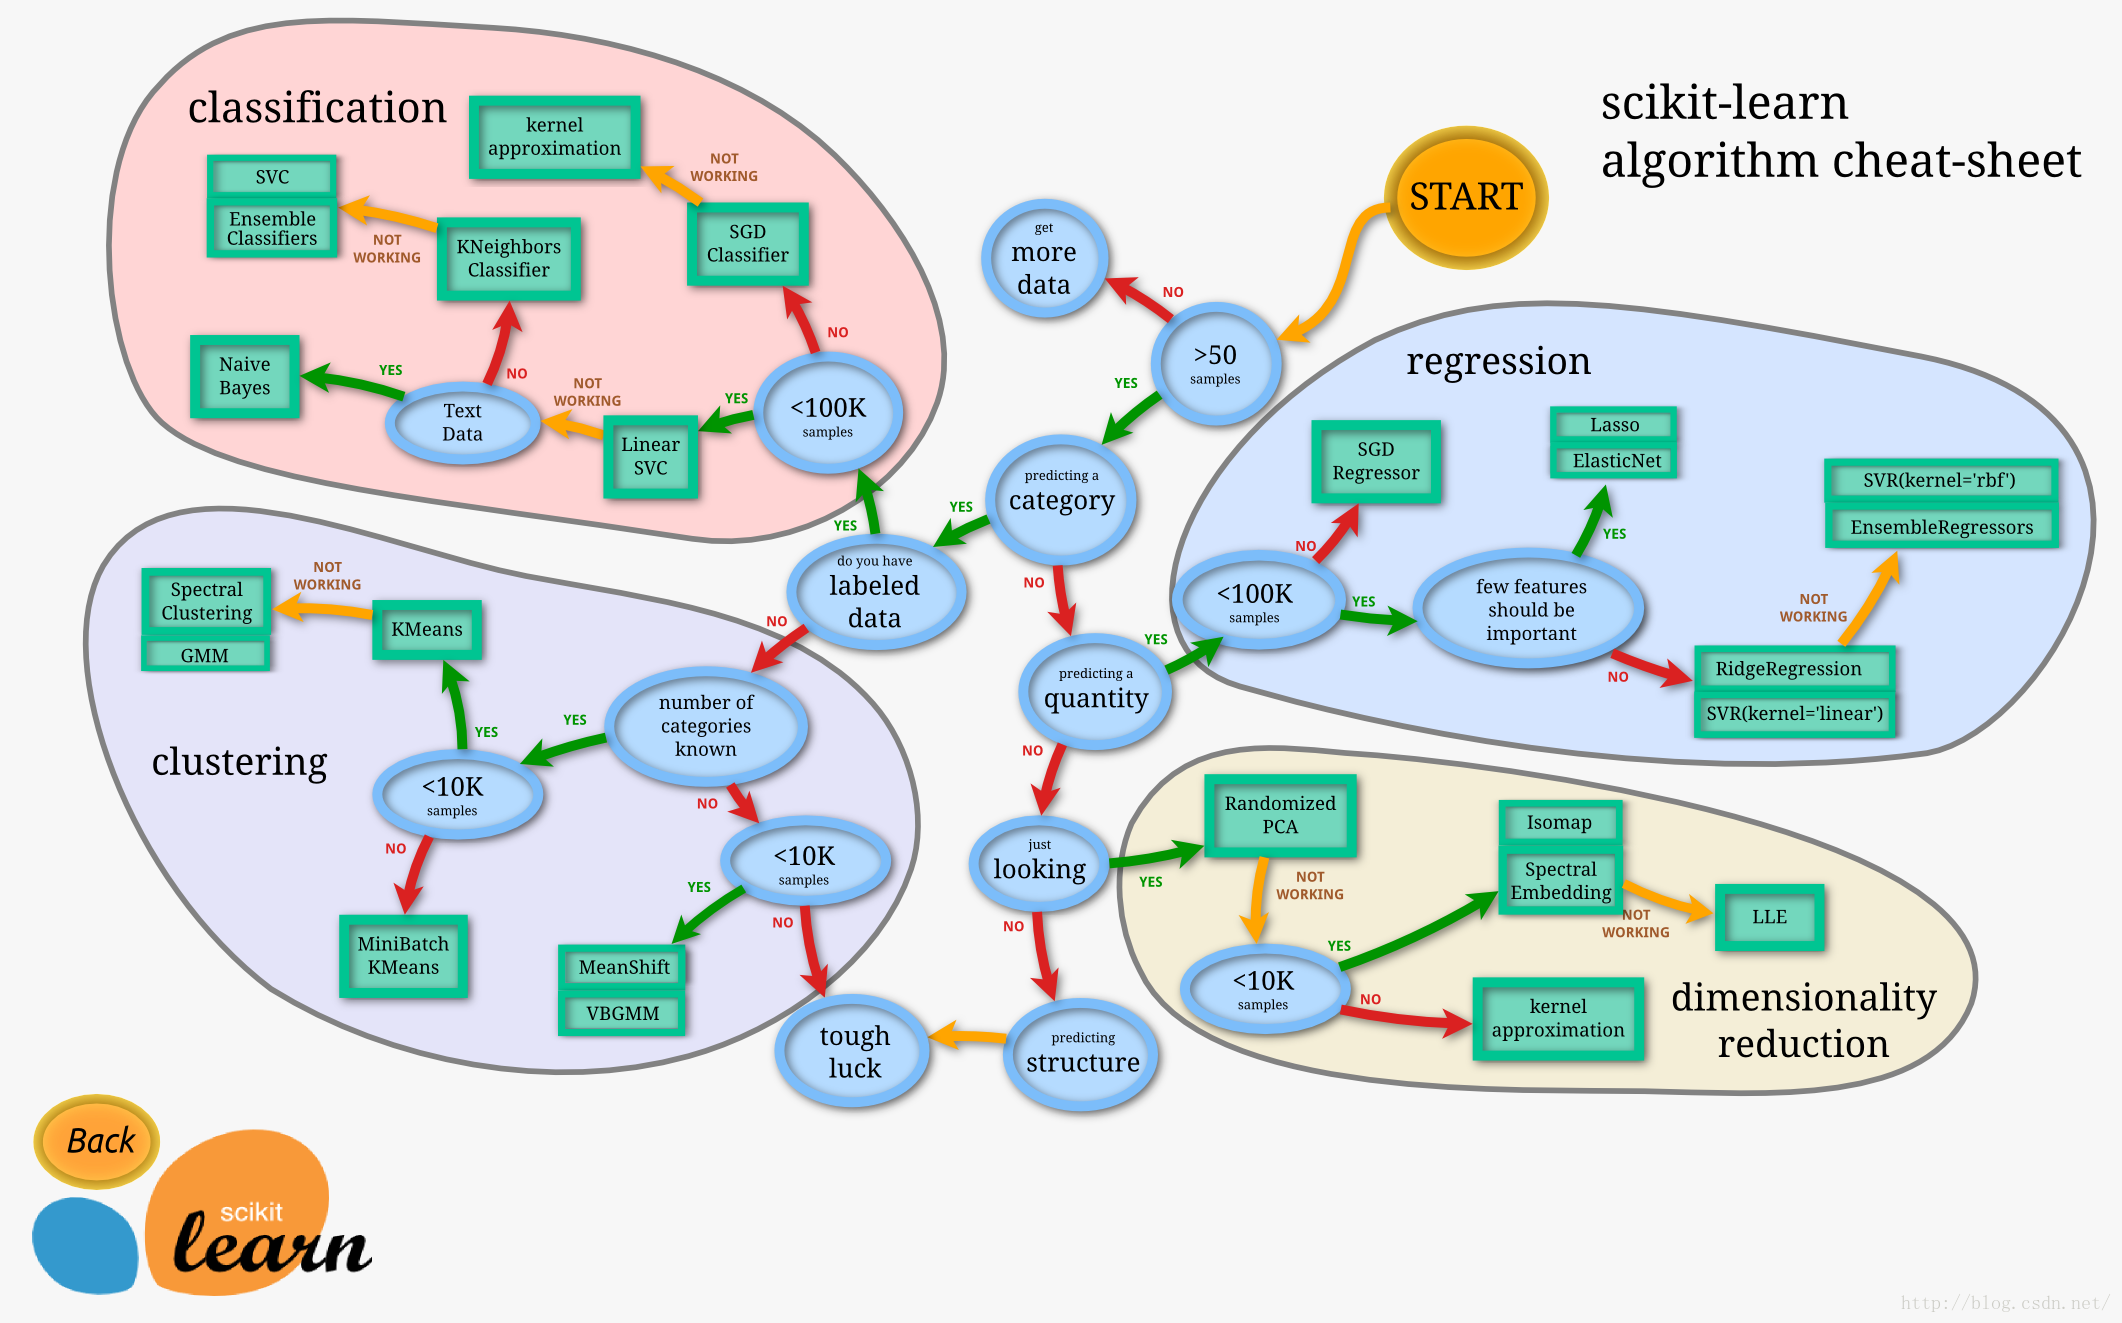
sklearn.neighbors k-近邻算法 sklearn.naive_bayes 贝叶斯 sklearn.linear_model.LogisticRegression 逻辑回归 sklearn.tree 决策树与随机森林 2、用于回归的估计器:
sklearn.linear_model.LinearRegression 线性回归 sklearn.linear_model.Ridge 岭回归 3、用于无监督学习的估计器
sklearn.cluster.KMeans 聚类 1.3 估计器工作流程
K-近邻算法
学习目标
说明K-近邻算法的距离公式 说明K-近邻算法的超参数K值以及取值问题 说明K-近邻算法的优缺点 应用KNeighborsClassifier实现分类 了解分类算法的评估标准准确率 应用
问题:回忆分类问题的判定方法
什么是K-近邻算法?
K-Nearest-Neighbors, 即选举出K个最临近的邻居的算法
地图K近邻算法 K-近邻算法(KNN)
定义
如果一个样本在特征空间中的k个最相似(即特征空间中最邻近)的样本中的大多数属于某一个类别 ,则该样本也属于这个类别。
来源:KNN算法最早是由Cover和Hart提出的一种分类算法
距离公式
两个样本的距离可以通过如下公式计算,又叫欧式距离
(也有其他距离的定义方式)
2、电影类型分析
假设我们有现在几部电影
其中? 号电影不知道类别,如何去预测?我们可以利用K近邻算法的思想
问题
K-近邻算法数据的特征工程处理
结合前面的约会对象数据,分析K-近邻算法需要做什么样的处理 K-近邻算法API
sklearn.neighbors.KNeighborsClassifier(n_neighbors=5,algorithm='auto')n_neighbors:int,可选(默认= 5),k_neighbors查询默认使用的邻居数 algorithm:{‘auto’,‘ball_tree’,‘kd_tree’,‘brute’},可选用于计算最近邻居的算法:‘ball_tree’将会使用 BallTree ‘kd_tree’将使用 KDTree ‘auto’将尝试根据传递给fit方法的值来决定最合适的算法。 (不同实现方式影响效率) 案例:鸢尾花分类预测
数据集介绍
使用sklearn的iris小数据集
# 模型调用
from sklearn.neighbors import KNeighborsClassifier
import sklearn.datasets
导入数据集:
data = sklearn.datasets.load_iris()
查看数据集描述:
data.DESCR
输出略
特征X:
X = data.data
打印X的形状:
X.shape
150行样本数据, 每行4列特征:
(150, 4)
标签y:
y = data.target
打印输出:
array([0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0,
       0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0,
       0, 0, 0, 0, 0, 0, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1,
       1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1,
       1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 2, 2, 2, 2, 2, 2, 2, 2, 2, 2,
       2, 2, 2, 2, 2, 2, 2, 2, 2, 2, 2, 2, 2, 2, 2, 2, 2, 2, 2, 2, 2, 2,
       2, 2, 2, 2, 2, 2, 2, 2, 2, 2, 2, 2, 2, 2, 2, 2, 2, 2])
创建KNN分类器实例(k = 1)
# 创建实例
knn = KNeighborsClassifier(n_neighbors=1)
打印模型
knn
输出:
KNeighborsClassifier(algorithm='auto', leaf_size=30, metric='minkowski',
                     metric_params=None, n_jobs=None, n_neighbors=1, p=2,
                     weights='uniform')
创建KNN分类器实例(k = 5)
# 创建另一个实例
knn_5 = KNeighborsClassifier()
确认模型
# 确认模型结构 n_neighbors默认是5
print(knn_5)
输出:
KNeighborsClassifier(algorithm='auto', leaf_size=30, metric='minkowski',
                     metric_params=None, n_jobs=None, n_neighbors=5, p=2,
                     weights='uniform')
我们已经创建了两种模型(k=1, k=5), 下一步确定模型评估的策略
使用整个数据集进行模型训练使用相同数据集测试 将整个数据集拆分为训练数据集和测试数据集, 进行交叉验证 然后对比预测结果和实际结果(准确率)来评估模型表现
准确率
导入计算准确率的方法
from sklearn.metrics import accuracy_score
对全数据集进行训练和预测(k=1):
knn.fit(X, y)
y_pred = knn.predict(X)
print(accuracy_score(y, y_pred))
准确率为:
1.0
也可以这样比对每个元素:
y_pred == y
输出:
array([ True,  True,  True,  True,  True,  True,  True,  True,  True,
        True,  True,  True,  True,  True,  True,  True,  True,  True,
        True,  True,  True,  True,  True,  True,  True,  True,  True,
        True,  True,  True,  True,  True,  True,  True,  True,  True,
        True,  True,  True,  True,  True,  True,  True,  True,  True,
        True,  True,  True,  True,  True,  True,  True,  True,  True,
        True,  True,  True,  True,  True,  True,  True,  True,  True,
        True,  True,  True,  True,  True,  True,  True,  True,  True,
        True,  True,  True,  True,  True,  True,  True,  True,  True,
        True,  True,  True,  True,  True,  True,  True,  True,  True,
        True,  True,  True,  True,  True,  True,  True,  True,  True,
        True,  True,  True,  True,  True,  True,  True,  True,  True,
        True,  True,  True,  True,  True,  True,  True,  True,  True,
        True,  True,  True,  True,  True,  True,  True,  True,  True,
        True,  True,  True,  True,  True,  True,  True,  True,  True,
        True,  True,  True,  True,  True,  True,  True,  True,  True,
        True,  True,  True,  True,  True,  True])
再次训练和预测(当k=5时):
knn_5.fit(X, y)
predct_y = knn_5.predict(X)
打印结果:
print(accuracy_score(y, y_pred))
仍然百分百正确:
1.0
这100%的准确率并不能说明当前的模型是最佳模型, 因为测试的都是训练过的数据.
k值取值过低会导致模型过于复杂, 会因为过拟合导致正确率反降.
为了解决这个问题, 我们一般要先将完全数据集分割成训练集和测试集两部分.
训练集用于训练 (fit) 测试集用于评估 (predict) 导入 train_test_split 用于分割数据集
from sklearn.model_selection import train_test_split
将数据集分割成训练集和测试集:
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.4)
打印训练集和测试集的样本数量做对比:
print("train:test = {}:{}".format(X_train.shape[0], X_test.shape[0]))
train:test = 90:60
对分离后 训练集和测试集的预测
# 训练集和测试集分离后的预测
knn_5_s = KNeighborsClassifier()
knn_5_s.fit(X_train, y_train)
y_train_pred = knn_5_s.predict(X_train)
y_test_pred = knn_5_s.predict(X_test)
打印训练集预测准确率 :
print("训练集预测准确率(knn5): ", accuracy_score(y_train, y_train_pred))
训练集预测准确率(knn5): 0.9777777777777777
I打印测试集预测准确率 :
print("测试集预测准确率(knn5): ", accuracy_score(y_test, y_test_pred))
测试集预测准确率(knn5): 0.9666666666666667
在测试k=1的情况
# 测试 k=1 的情况
knn_1_s = KNeighborsClassifier(n_neighbors=1)
knn_1_s.fit(X_train, y_train)
y_train_pred = knn_1_s.predict(X_train)
y_test_pred = knn_1_s.predict(X_test)
打印结果:
print("训练集预测准确率(knn1): ", accuracy_score(y_train, y_train_pred))
print("测试集预测准确率(knn1): ", accuracy_score(y_test, y_test_pred))
训练集预测准确率(knn1):  1.0
测试集预测准确率(knn1):  0.9333333333333333
那么到底k的取值为何时准确率最好呢?
可以让k的取值从1到25分别进行测试, 取准确率最高时的k值即可:
score_train = []
score_test = []
for  k in range(1, 26):
    knn_s = KNeighborsClassifier(n_neighbors=k)
    knn_s.fit(X_train, y_train)
    y_train_pred = knn_s.predict(X_train)
    y_test_pred = knn_s.predict(X_test)
    score_train.append(accuracy_score(y_train, y_train_pred))
    score_test.append(accuracy_score(y_test, y_test_pred))

for k in range(0, len(score_train) ):
    print("训练集预测准确率(k={}): {}".format(k + 1, score_train[k]))

print("===========")

for k in range(0, len(score_test) ):
    print("测试集预测准确率(k={}): {}".format(k + 1, score_test[k]))
训练集预测准确率(k=1): 1.0
训练集预测准确率(k=2): 1.0
训练集预测准确率(k=3): 0.9777777777777777
训练集预测准确率(k=4): 0.9777777777777777
训练集预测准确率(k=5): 0.9777777777777777
训练集预测准确率(k=6): 0.9777777777777777
训练集预测准确率(k=7): 0.9777777777777777
训练集预测准确率(k=8): 0.9666666666666667
训练集预测准确率(k=9): 0.9666666666666667
训练集预测准确率(k=10): 0.9666666666666667
训练集预测准确率(k=11): 0.9777777777777777
训练集预测准确率(k=12): 0.9666666666666667
训练集预测准确率(k=13): 0.9777777777777777
训练集预测准确率(k=14): 0.9666666666666667
训练集预测准确率(k=15): 0.9555555555555556
训练集预测准确率(k=16): 0.9666666666666667
训练集预测准确率(k=17): 0.9666666666666667
训练集预测准确率(k=18): 0.9666666666666667
训练集预测准确率(k=19): 0.9666666666666667
训练集预测准确率(k=20): 0.9666666666666667
训练集预测准确率(k=21): 0.9666666666666667
训练集预测准确率(k=22): 0.9666666666666667
训练集预测准确率(k=23): 0.9666666666666667
训练集预测准确率(k=24): 0.9666666666666667
训练集预测准确率(k=25): 0.9666666666666667
===========
测试集预测准确率(k=1): 0.9333333333333333
测试集预测准确率(k=2): 0.9166666666666666
测试集预测准确率(k=3): 0.9666666666666667
测试集预测准确率(k=4): 0.9666666666666667
测试集预测准确率(k=5): 0.9666666666666667
测试集预测准确率(k=6): 0.9666666666666667
测试集预测准确率(k=7): 0.9666666666666667
测试集预测准确率(k=8): 0.9666666666666667
测试集预测准确率(k=9): 0.9833333333333333
测试集预测准确率(k=10): 0.9666666666666667
测试集预测准确率(k=11): 0.9666666666666667
测试集预测准确率(k=12): 0.95
测试集预测准确率(k=13): 0.9333333333333333
测试集预测准确率(k=14): 0.9
测试集预测准确率(k=15): 0.9166666666666666
测试集预测准确率(k=16): 0.9
测试集预测准确率(k=17): 0.9
测试集预测准确率(k=18): 0.9
测试集预测准确率(k=19): 0.9
测试集预测准确率(k=20): 0.9
测试集预测准确率(k=21): 0.9
测试集预测准确率(k=22): 0.8833333333333333
测试集预测准确率(k=23): 0.8833333333333333
测试集预测准确率(k=24): 0.8833333333333333
测试集预测准确率(k=25): 0.8666666666666667
对于训练集的评估, 由于是训练集训练得来的模型, 因此当k=1时可以达到100%准确率, 但是随着k值的增加准确率开始略有下降 对测试集的评估, 由于测试集评估相当于是对未知数据进行评估,因此测试集评估的准确率更加重要, 根据经验合理的k值一般略低于训练样本数的平方根, 其准确率容易受数据的干扰, import math
ideal_k = int(math.sqrt(X.shape[0]))
print("当k取值{}时, 测试集的评估准确率为{}".format(ideal_k, score_test[ideal_k - 1]))
当k取值12时, 测试集的评估准确率为0.95
为了找出最合适的k值可以对数据集进行多轮交叉验证, 选出综合准确率更高时的k值
也可以使用pyplot绘图实现可视化, 帮助你更直观找到合适的k值取值区间:
import matplotlib.pyplot as plt
绘 Training Accuracy折线图:
plt.plot(range(1, 26), score_train)
plt.xlabel('K(KNN Model)')
plt.ylabel('Training Accuracy')
输出:
Text(0,0.5,'Training Accuracy')
绘 Testing Accuracy折线图:
plt.plot(range(1, 26), score_test)
plt.xlabel('K(KNN Model)')
plt.ylabel('Testing Accuracy')
输出:
Text(0,0.5,'Testing Accuracy')
注意:
K 越小 模型越复杂 容易过拟合 对训练集训练准确率越高 K 越大 模型越简单 容易欠拟合 案例:签到位置预测(FaceBook)
FBLocation介绍 数据介绍:将根据用户的坐标位置,定位准确性和时间戳预测用户签到的地点ID。
train.csv,test.csv
row_id:登记事件的ID
xy:坐标
准确性:定位准确性
时间:时间戳
place_id:业务的ID,这是您预测的目标
官网:https://www.kaggle.com/navoshta/grid-knn/data
(Kaggle官网手机认证时需要梯子, 输入手机号前面加上+860)
FBlocation-飞桨AI Studio - 人工智能学习实训社区 (baidu.com)
(Baidu飞浆AI Studio里面有公开数据集可以下载, 无需登录)
分析
对于数据做一些基本处理(这里所做的一些处理不一定达到很好的效果,我们只是简单尝试,有些特征我们可以根据一些特征选择的方式去做处理)缩小数据集范围 DataFrame.query() 删除没用的日期数据 DataFrame.drop(可以选择保留) 将签到位置少于n个用户的删除place_count = data.groupby('place_id').count()tf = place_count[place_count.row_id > 3].reset_index()data = data[data['place_id'].isin(tf.place_id)] 分割数据集 标准化处理 k-近邻预测 代码
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.neighbors import KNeighborsClassifier

def knncls():
    """
    K近邻算法预测入住位置类别
    :return:
    """
    # 一、处理数据以及特征工程
    # 1、读取,缩小数据的范围
    data = pd.read_csv("./data/FBlocation/train.csv")

    # 数据逻辑筛选操作 df.query()
    data = data.query("x > 1.0 & x < 1.25 & y > 2.5 & y < 2.75")

    # 删除time这一列特征
    data = data.drop(['time'], axis=1)

    print(data)

    # 删除签到次数少于三次的位置
    place_count = data.groupby('place_id').count()

    tf = place_count[place_count.row_id > 3].reset_index()

    data = data[data['place_id'].isin(tf.place_id)]

    # 3、取出特征值和目标值
    y = data['place_id']
    # y = data[['place_id']]

    x = data.drop(['place_id', 'accuracy', 'row_id'], axis=1)

    # 4、数据分割与特征工程

    # (1)、数据分割
    x_train, x_test, y_train, y_test = train_test_split(x, y, test_size=0.3)

    # (2)、标准化
    std = StandardScaler()

    # 对训练集进行标准化操作
    x_train = std.fit_transform(x_train)
    print(x_train)

    # 进行测试集的标准化操作
    x_test = std.fit_transform(x_test)

    # 二、算法的输入训练预测
    # K值:算法传入参数不定的值    理论上:k = 根号(样本数)
    # K值:后面会使用参数调优方法,去轮流试出最好的参数[1,3,5,10,20,100,200]
    knn = KNeighborsClassifier(n_neighbors=1)

    # 调用fit()
    knn.fit(x_train, y_train)

    # 预测测试数据集,得出准确率
    y_predict = knn.predict(x_test)

    print("预测测试集类别:", y_predict)

    print("准确率为:", knn.score(x_test, y_test))

    return None
结果分析
准确率: 分类算法的评估之一
k值取很小:容易受到异常点的影响
k值取很大:受到样本均衡的问题
n_neighbors 预测准确率 备注 1 0.3421985815602837 最差 3 0.39972419227738376 5 0.438140267927502 10 0.4676910953506698 20 0.49527186761229314 50 0.5027580772261623 较好 100 0.4923167848699764 200 0.4858156028368794
实验结果(使用飞浆AI Studio) 距离计算上面,时间复杂度高
K-近邻总结
优点: 缺点:懒惰算法,对测试样本分类时的计算量大,内存开销大 必须指定K值,K值选择不当则分类精度不能保证 使用场景:小数据场景,几千~几万样本,具体场景具体业务去测试 在学习KNN后,我们需要考虑以下几个问题,当你把这些问题都解决了,KNN你已经掌握的差不多了。
1,问题描述:
1,KNN的原理是什么?
2,KNN算法的时间复杂度,和空间复杂度怎么样?
3,K值如何选取,取多大合适?
4,计算两个样本之间的距离,采用哪种距离计算方式好?
5,类别如何判定最合适?
6,计算量太大怎么办?
7,假设样本中,类型分布非常不均匀,这又该怎么办?
2,K近邻原理:
kNN原理很简单,通过计算待分类样本与已知类别样本之间的距离,找到距离待分类最近的K个已知类别的样本,然后根据少数“服从多数”的判决原则,统计K个样本中各类样本出现的次数,出现次数最多的样本即为待分类样本的类别。
近邻分类 上图中要确定测试样本绿色属于蓝色还是红色。显然,当K=3时,将以1:2的投票结果分类于红色;而K=5时,将以3:2的投票结果分类于蓝色。
我们不禁会反问,这样的分类准确吗?为什么不同的K值会得到不同的分类结果?你有什么理由说待分类的样本与K个样本中出现次数最多样本是同一类?
我们都听说过这句话“同一类样本之间差异较小,不同类之间差异较大”,这差异通过什么来体现呢?在KNN算法中,样本特征之间差异,主要通过特征之间的“距离”来体现,距离体现了他们之间的相似性,在多维空间中,不同类的样本散布于多维空间之中,同类样本总是聚集在一起,本质是讲就是他们的特征存在相似性,不同类样本之间是彼此分离的。
因此通过计算待分类样本与已分类样本之间的距离来进行分类是可靠的。对于分类决策主要是根据“少数服从多数” 本质上讲就是哪类样本与待分类样本最相似,就分给哪类。(对于这种判决准则,不一定适用于所有情况)
关于为什么K取不同的值,分类结果可能不一致,这主要体现KNN在类边界上,分类结果会随K的取值不同,分类结果不稳定,但对于非类边界分类准确率还是很高的。
K值选取:
关于K的取值是K-最近邻算法中的一大难题,没有特定的经验公式来告诉我们K应该取多大?K值如果选取的太小,模型太复杂,K值选取的太大的话,又会导致分类模糊。K的取值与实际背景有关,与你数据分析的目标……那么K值到底怎么选取呢?既然K值这么麻烦有没有一些常规选取K值的方法,答案是肯定的。
经验规则:k一般低于训练样本数的平方根。
常用方法有Cross Validation,贝叶斯准则, bootstrap……
上面提到了类与类之间的相似性通过距离来体现,下面我们看下有哪些距离:
3,距离定义:
( 1 )欧式距离
欧氏距离是最常见的距离度量,衡量的是多维空间中各个点之间的绝对距离。
因为计算是基于各维度特征的绝对数值,所以欧氏度量需要保证各维度指标在相同的刻度级别,比如对身高(cm)和体重(kg)两个单位不同的指标使用欧式距离可能使结果失效。
( 2 ) 马氏距离:马氏距离能够缓解由于属性的线性组合带来的距离失真,是数据的协方差矩阵。
( 3 )曼哈顿距离:
曼哈顿距离来源于城市区块距离,是将多个维度上的距离进行求和后的结果。
( 4 )切比雪夫距离
切比雪夫距离起源于国际象棋中国王的走法,我们知道国际象棋国王每次只能往周围的8格中走一步,那么如果要从棋盘中A格(x1, y1)走到B格(x2, y2)最少需要走几步?扩展到多维空间,其实切比雪夫距离就是当p趋向于无穷大时的明氏距离。
( 5 )闵氏距离:
闵氏距离是欧氏距离的推广,是对多个距离度量公式的概括性的表述。r取值为2式为曼哈顿距离 ;r取值为1时为欧式距离。
( 6 )平均距离
( 7 )弦距离:
( 8 )测地距离
关于距离选择:
高维度对距离衡量的影响:众所周知当变量数越多,欧式距离的区分能力就越差。
变量值域对距离的影响:值域越大的变量常常会在距离计算中占据主导作用,因此应先对变量进行标准化。
比较常用的是选用欧式距离。可是这个距离真的具有普适性吗?《模式分类》中指出欧式距离对平移是敏感的,这点严重影响了判定的结果。在此必须选用一个对已知的变换(比如平移、旋转、尺度变换等)不敏感的距离度量。书中提出了采用切空间距离(tangent distance)来替代传统的欧氏距离。
最近邻法介绍:
切空间距离定义:
(引自:杨剑. 基于局部切距离的近邻法[A]. 中国自动化学会智能自动化专业委员会、中国科学院自动化研究所.2005年中国智能自动化会议论文集[C].中国自动化学会智能自动化专业委员会、中国科学院自动化研究所:,2005:6.)
4,算法实现步骤:
简单来说,KNN可以看成:有那么一堆你已经知道分类的数据,然后当一个新数据进入的时候,就开始跟训练数据里的每个点求距离,然后挑离这个训练数据最近的K个点看看这几个点属于什么类型,然后用少数服从多数的原则,给新数据归类。
具体步骤如下
step.1---计算未知样本和每个训练样本的距离dist ;
step.2---对dist从小到大排序;
step.3---取出距离从小到大的K个训练样本,作为K-最近邻样本;
step.4---统计K-最近邻样本中每个类标号出现的次数
step.5---选择出现频率最大的类标号作为未知样本的类标号,
5,算法复杂度分析:
KNN算法简单有效,但没有优化的暴力法那样效率容易达到瓶颈。如样本个数为N,特征维度为D的时候,该算法时间复杂度呈O(DN)增长。所以通常KNN的实现会把训练数据构建成K-D Tree(K-dimensional tree),构建过程很快,甚至不用计算D维欧氏距离,而搜索速度高达O(D*log(N))。不过当D维度过高,会产生所谓的”维度灾难“,最终效率会降低到与暴力法一样。因此通常D>20以后,最好使用更高效率的Ball-Tree,其时间复杂度为O(D*log(N))。人们经过长期的实践发现KNN算法虽然简单,但能处理大规模的数据分类,尤其适用于样本分类边界不规则的情况。最重要的是该算法是很多高级机器学习算法的基础。
(KNeighbors Classifier可以设置3种算法:‘brute’,‘kd_tree’,‘ball_tree’。如果不知道用哪个好,设置‘auto’让KNeighborsClassifier自己根据输入去决定。)
(引用:http://blog.csdn.net/lsldd/article/details/41357931)
6,类别如何判定最合理?
投票法没有考虑近邻的距离的远近,距离更近的近邻也许更应该决定最终的分类,所以加权投票法更恰当一些。
模型选择与调优
学习目标说明交叉验证过程 说明超参数搜索过程 应用GridSearchCV实现算法参数的调优 具体应用 为什么需要交叉验证
交叉验证目的:为了让被评估的模型更加准确可信
什么是交叉验证(cross validation)
交叉验证:将拿到的训练数据,分为训练和验证集。以下图为例:将数据分成5份,其中一份作为验证集。然后经过5次(组)的测试,每次都更换不同的验证集。即得到5组模型的结果,取平均值作为最终结果。又称5折交叉验证。
分析
我们之前知道数据分为训练集和测试集,但是为了让从训练得到模型结果更加准确。 做以下处理
问题:那么这个只是对于参数得出更好的结果,那么怎么选择或者调优参数呢?
超参数搜索-网格搜索(Grid Search)
通常情况下,有很多参数是需要手动指定的(如k-近邻算法中的K值),这种叫超参数 。但是手动过程繁杂,所以需要对模型预设几种超参数组合。每组超参数都采用交叉验证来进行评估。最后选出最优参数组合建立模型。
模型选择与调优
sklearn.model_selection.GridSearchCV(estimator, param_grid=None,cv=None)对估计器的指定参数值进行详尽搜索 estimator:估计器对象 param_grid:估计器参数(dict){“n_neighbors”:[1,3,5]} cv:指定几折交叉验证 fit:输入训练数据 score:准确率 结果分析:bestscore :在交叉验证中验证的最好结果_ bestestimator :最好的参数模型 cvresults :每次交叉验证后的验证集准确率结果和训练集准确率结果 Facebook签到位置预测K值调优
使用网格搜索估计器
from sklearn.neighbors import KNeighborsClassifier
from sklearn.model_selection import GridSearchCV

# 使用网格搜索估计器实现参数调优方法
# 从[1,3,5,10,20,100,200]中交叉验证轮流试出最好的参数
k_params = {"n_neighbors": [1,3,5,10,20,100,200]}

knn = KNeighborsClassifier(n_neighbors=50)
gc = GridSearchCV(knn, param_grid=k_params, cv=2)

gc.fit(x_train, y_train)

print("选择了某个模型测试集当中预测的准确率为:", gc.score(x_test, y_test))

# 训练验证集的结果
print("在交叉验证当中验证的最好结果:", gc.best_score_)
print("gc选择了的模型K值是:", gc.best_estimator_)
print("每次交叉验证的结果为:", gc.cv_results_)
输出
选择了某个模型测试集当中预测的准确率为: 0.48877068557919623
在交叉验证当中验证的最好结果: 0.4906265833474075
gc选择了的模型K值是: KNeighborsClassifier(algorithm='auto', leaf_size=30, metric='minkowski',
                     metric_params=None, n_jobs=None, n_neighbors=20, p=2,
                     weights='uniform')
每次交叉验证的结果为: {'mean_fit_time': array([0.00542653, 0.00541699, 0.00546551, 0.00545597, 0.00556421,
       0.0055443 , 0.00544441]), 'std_fit_time': array([6.68764114e-05, 3.20672989e-05, 4.22000885e-05, 8.96453857e-05,
       1.06811523e-04, 1.09553337e-04, 3.01599503e-05]), 'mean_score_time': array([0.15212929, 0.20162416, 0.16866851, 0.17537868, 0.18768466,
       0.28859103, 0.42182934]), 'std_score_time': array([0.00433338, 0.03741288, 0.00232887, 0.00084627, 0.0002321 ,
       0.00352132, 0.0011555 ]), 'param_n_neighbors': masked_array(data=[1, 3, 5, 10, 20, 100, 200],
             mask=[False, False, False, False, False, False, False],
       fill_value='?',
            dtype=object), 'params': [{'n_neighbors': 1}, {'n_neighbors': 3}, {'n_neighbors': 5}, {'n_neighbors': 10}, {'n_neighbors': 20}, {'n_neighbors': 100}, {'n_neighbors': 200}], 'split0_test_score': array([0.35483871, 0.39739909, 0.44958622, 0.48099983, 0.49315994,
       0.48826212, 0.46123966]), 'split1_test_score': array([0.35179868, 0.39976355, 0.43523054, 0.47086641, 0.48809323,
       0.47762202, 0.45938186]), 'mean_test_score': array([0.3533187 , 0.39858132, 0.44240838, 0.47593312, 0.49062658,
       0.48294207, 0.46031076]), 'std_test_score': array([0.00152001, 0.00118223, 0.00717784, 0.00506671, 0.00253336,
       0.00532005, 0.0009289 ]), 'rank_test_score': array([7, 6, 5, 3, 1, 2, 4], dtype=int32)}
可以看出, 当 k=20 时, 最好的预测准确率为 0.49062658
朴素贝叶斯算法
学习目标说明条件概率与联合概率 说明贝叶斯公式、以及特征独立的关系 记忆贝叶斯公式 知道拉普拉斯平滑系数 应用贝叶斯公式实现概率的计算 具体应用 什么是朴素贝叶斯分类方法
概率基础
概率(Probability)定义
概率定义为一件事情发生的可能性 P(X) : 取值在[0, 1] 案例: 预测女神是否喜欢
在讲这两个概率之前我们通过一个例子,来计算一些结果:
问题如下:
女神喜欢一个人的概率 职业是程序员并且体型匀称的概率 被女神喜欢职业又是程序员的概率 被女神喜欢而职业是产品且体重超重的概率 那么这些问题该如何计算呢?
条件概率与联合概率
联合概率:包含多个条件,且所有条件同时成立的概率记作:P(A,B) 特性:P(A, B) = P(A)P(B) 条件概率:就是事件A在另外一个事件B已经发生条件下的发生概率记作:P(A|B) 特性:P(A1,A2|B) = P(A1|B)P(A2|B) 注意:此条件概率成立的前提,是由于A1,A2相互独立 (完全不相关), 这也是为什么称之为朴素贝叶斯的原因. (这个假设在实际应用中往往是不成立的,在属性个数比较多或者属性之间相关性较大时,分类效果不好。 )
而在属性相关性较小时,朴素贝叶斯性能最为良好。对于这一点,有半朴素贝叶斯之类的算法通过考虑部分关联性适度改进。
这样我们计算结果为:
p(程序员, 匀称) =  P(程序员)P(匀称) =3/7*(4/7) = 12/49
P(产品, 超重|喜欢) = P(产品|喜欢)P(超重|喜欢)=1/2 *  1/4 = 1/8
那么,我们知道了这些知识之后,继续回到我们的主题中。朴素贝叶斯如何分类,这个算法经常会用在文本分类,那就来看文章分类是一个什么样的问题?
这个了类似一个条件概率,那么仔细一想,给定文章其实相当于给定什么?结合前面我们将文本特征抽取的时候讲的?所以我们可以理解为:
P(科技|文章1) = P(科技|词1, 词2, 词4, 词4 ... ...)
P(娱乐|文章1) = P(娱乐|词1, 词2, 词4, 词4 ... ...)
但是这个公式怎么求?前面并没有参考例子,其实是相似的,我们可以使用贝叶斯公式去计算
贝叶斯公式
公式
那么这个公式如果应用在文章分类的场景当中,我们可以这样看:
公式分为三个部分:
P(C):每个文档类别的概率(某文档类别数量/总文档数量) P(W│C):给定类别下特征(被预测文档中出现的词)的概率计算方法:P(F1│C)=Ni/N (训练文档中去计算)Ni为该F1词在C类别所有文档中出现的次数 N为所属类别C下的文档所有词出现的次数和 P(F1,F2,…) 预测文档中每个词的概率 如果在一篇文章中计算两个类别概率比较:
P(科技类|文章1) = P(文章1|科技类)P(科技类) /p(文章)
P(娱乐类|文章1) = P(文章1|娱乐类)P(娱乐类) /p(文章)
所以我们只要比较前面的大小就可以,得出谁的概率大
文章分类计算
假设我们从训练数据集 得到如下信息:
训练集中一共90个文档, 其中30个是科技类, 60是娱乐类.第一列为某个在文档中出现的单词, 单词右边的列表示这个单词在某个分类下共有多少个文档中出现过这个单词
则通过贝叶斯公式可以计算:
该文档为科技类别的概率 :
P(科技|影院,支付宝,云计算) = 𝑃(影院,支付宝,云计算|科技)∗P(科技)=(8/100)∗(20/100)∗(63/100)∗(30/90) = 0.00456109 该文档为娱乐类别的概率 :
P(娱乐|影院,支付宝,云计算) = 𝑃(影院,支付宝,云计算|娱乐)∗P(娱乐)=(56/121)∗(15/121)∗(0/121)∗(60/90) = 0思考:我们计算出来某个概率为0,合适吗?
拉普拉斯平滑系数
当每个类别未出现导致概率为0时,可以采用贝叶斯估计的方式来解决。
为了防止计算出的分类概率为0,可以生成一个接近于0的概率代替0,几乎不影响原有的先验概率分布。贝叶斯估计公式中,α称之为拉普拉斯平滑(Laplace smoothing), 为一个大于0的常数, 常取值为1。
P(娱乐|影院,支付宝,云计算)
=P(影院,支付宝,云计算|娱乐)P(娱乐)
=P(影院|娱乐)*P(支付宝|娱乐)*P(云计算|娱乐)P(娱乐)
=(56+1/121+4)(15+1/121+4)(0+1/121+1*4)(60/90)
= 0.00002
API
sklearn.naive_bayes.MultinomialNB(alpha = 1.0) 案例: 从20个新闻组数据集进行分类训练
4.1 分析
4.2 代码
from sklearn.datasets import fetch_20newsgroups
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.model_selection import train_test_split
from sklearn.naive_bayes import MultinomialNB
from sklearn.datasets import fetch_20newsgroups
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.model_selection import train_test_split
from sklearn.naive_bayes import MultinomialNB

"""
朴素贝叶斯对新闻数据集进行预测
:return:
"""

# 获取新闻的数据,20个类别
news = fetch_20newsgroups(subset='all')
# 进行数据集分割
x_train, x_test, y_train, y_test = train_test_split(news.data, news.target, test_size=0.3)

# 对于文本数据,进行特征抽取
tf = TfidfVectorizer()

# 提取tfidf特征
x_train = tf.fit_transform(x_train)
# 这里打印出来的列表是:训练集当中的所有不同词的组成的一个列表
# print(tf.get_feature_names())
# print(x_train.toarray())

print(x_train.shape)
# nnz: number of none zero entries
print(x_train.nnz / float(x_train.shape[0]))
输出:
(13192, 136677)
156.75280473013947
我们从以上输出可以看出,提取的TF-IDF 向量是非常稀疏的,才有150多个非零特征.
# 不能调用fit_transform
x_test = tf.transform(x_test)

# 朴素贝叶斯估计器
mlb = MultinomialNB(alpha=1.0)
mlb.fit(x_train, y_train)

# 进行预测
y_predict = mlb.predict(x_test)

print("预测每篇文章的类别:", y_predict[:100])
print("真实类别为:", y_test[:100])

print("预测准确率为:", mlb.score(x_test, y_test))
注意:
数据预处理中的方法:
Fit(): Method calculates the parameters μ and σ and saves them as internal objects.解释:简单来说,就是求得训练集X的均值啊,方差啊,最大值啊,最小值啊这些训练集X固有的属性。可以理解为一个训练过程, 返回了一个中间结果, 但是数据集不变.
Transform(): Method using these calculated parameters apply the transformation to a particular dataset.解释:在Fit的基础上,进行标准化,降维,归一化等操作(看具体用的是哪个工具,如PCA,StandardScaler等)。
Fit_transform(): joins the fit() and transform() method for transformation of dataset.解释:fit_transform是fit和transform的组合,既包括了训练又包含了转换。
transform()和fit_transform()二者的功能都是对数据进行某种统一处理(比如标准化~N(0,1),将数据缩放(映射)到某个固定区间,归一化,正则化等)
fit_transform(trainData)对部分数据先拟合fit,找到该part的整体指标,如均值、方差、最大值最小值等等(根据具体转换的目的),然后对该trainData进行转换transform,从而实现数据的标准化、归一化等等。
根据对之前部分trainData进行fit的整体指标,对剩余的数据(testData)使用同样的均值、方差、最大最小值等指标进行转换transform(testData),从而保证train、test处理方式相同。 所以,一般都是这么用:
from sklearn.preprocessing import StandardScaler
sc = StandardScaler()
sc.fit_tranform(X_train)
sc.tranform(X_test)
Note:
必须先用fit_transform(trainData),之后再transform(testData) 如果直接transform(testData),程序会报错 如果fit_transfrom(trainData)后,使用fit_transform(testData)而不ransform(testData),虽然也能归一化,但是两个结果不是在同一个“标准”下的,具有明显差异。(一定要避免这种情况 , 这也是为什么开头说不能对x_test使用fit_transform的原因) 输出:
预测每篇文章的类别: [15 13  7 15  8  0  9  7  3 18  7  5 12  2 13  1 18  1 16 12 13  5  4  9
  5 17 14  3 12 13 16  7 15  7 17 14  3 12  5 13 11 12 15 17  6  3  6 18
  6 18 11 15  2 16 13  7  8 14 11  2 17  8 15  2  3 14  3  4  5 15 14 15
 11  5  9 15  7  6 18 13  6 11 16 16 12  1  0 10 11  3 15 17 13  7  8  8
 13 15  2 11]
真实类别为: [15 13  7 15  8  0  9  7  3 18  7  5 12  2 13  1 18  5 11 12 13  5  4  9
  5 17 14  3 12 13 16  7 15  7 17 14  3 12  5 13 11 12 15 17  6  3  6 18
  6 18  6 15  2 16 13  7  8 14 11  2 17  8 15  2  6 12  3  4  5 19 14 15
 11  5  9 15  7  6 18 13  6 11 16 16 12  1  0 10 11  3 15 17 13  7  8  8
 13 19  2 11]
预测准确率为: 0.8514326140785284
总结
优点:朴素贝叶斯模型发源于古典数学理论,有稳定的分类效率。 对缺失数据不太敏感,算法也比较简单,常用于文本分类。 分类准确度高,速度快 缺点:由于使用了样本属性独立性的假设,所以如果特征属性有关联时其效果不好 决策树
学习目标说明信息熵的公式以及作用 说明信息增益的公式作用 应用信息增益实现计算特征的不确定性减少程度 了解决策树的三种算法实现 具体应用 认识决策树
决策树思想的来源非常朴素,程序设计中的条件分支结构就是if-then结构,最早的决策树就是利用这类结构分割数据的一种分类学习方法
怎么理解这句话?通过一个对话例子
想一想这个女生为什么把年龄放在最上面判断!!!!!!!!!
决策树分类原理详解
为了更好理解决策树具体怎么分类的,我们通过一个问题例子?
问题:如何对这些客户进行分类预测?你是如何去划分?
有可能你的划分是这样的
那么我们怎么知道这些特征哪个更好放在最上面,我们可以把最重要的判断放在前面:
为什么要这样做呢?
原理
需要用到信息论的知识, 下面通过例子引入信息熵 :
熵(英语: entropy ):表示随机变量的不确定性, 单位比特(bit)。
条件熵:在一个条件下,随机变量的不确定性。
信息增益: 信息增益 = 熵 - 条件熵。表示在一个条件下,信息不确定性减少的程度。
通俗地讲,X(明天下雨)是一个随机变量,X的熵可以算出来, Y(明天阴天)也是随机变量,在阴天情况下下雨的信息熵我们如果也知道的话(此处需要知道其联合概率分布或是通过数据估计)即是条件熵。
X的熵减去Y条件下X的熵,就是信息增益。具体解释:原本明天下雨的信息熵是2,条件熵是0.01(因为如果知道明天是阴天,那么下雨的概率很大,信息量少),这样相减后为1.99。在获得阴天这个信息后,下雨信息不确定性减少了1.99,不确定减少了很多,所以信息增益大。也就是说,阴天这个信息对明天下午这一推断来说非常重要。
所以在特征选择的时候常常用信息增益,如果信息增益大的话那么这个特征对于分类来说很关键,下面我们要讲到的决策树就是这样来找特征的。
信息熵举例
那来玩个猜测游戏,猜猜这32支球队那个是冠军。并且猜测错误付出代价。每猜错一次给一块钱,告诉我是否猜对了,那么我需要掏多少钱才能知道谁是冠军? (前提是:不知道任意球队的信息、历史比赛记录、实力等)
为了使代价最小,可以使用二分法猜测:
我可以把球编上号,从1到32,然后提问:冠 军在1-16号吗?依次询问,只需要五次,就可以知道结果。
我们来看这个式子:
32支球队,log32=5比特 (log的底为2, 最多5次可以猜中) 64支球队,log64=6比特 (最多6次可以猜中, 数据增加一倍只需要多猜一次) 信息熵的定义
信息熵公式:
H的专业术语称之为信息熵,单位为比特。信息熵H越大证明信息的不确定性越大.
在预测获胜球队的例子中,p为每个球队获胜的概率, 假设概率相等,都为1/32, 那么信息熵的计算 :
假设每个球队获胜概率相同,即 p1=p2=...=p32=1/32
H = -(p1logp1 + p2logp2 + ... + p32logp32)
  = -1 * -1*log32
  = log32
  = 5
当这32支球队夺冠的几率相同时,对应的信息熵等于5比特
只要概率发生任意变化,信息熵都比5比特小, 举个极端的例子, 比如确定其中的一个球队100%能够获胜, 则信息熵为0, 即没有任何不确定性.
总结(重要)
信息和消除不确定性是相联系的
当我们得到的额外信息(球队历史比赛情况等等)越多的话,那么我们猜测的代价越小(猜测的不确定性减小)
问题: 回到我们前面的贷款案例,怎么去划分?可以利用当得知某个特征(比如是否有房子)之后,我们能够减少的不确定性大小。越大我们可以认为这个特征很重要。那怎么去衡量减少的不确定性大小呢?
决策树的划分依据之一 - 信息增益
定义与公式
特征A对训练数据集D的信息增益g(D,A): 定义为集合D的信息熵H(D)与特征A给定条件下D的信息条件熵H(D|A)之差,即公式为:
公式的详细解释:
注:信息增益表示得知特征X的信息, 随着不确定性减少的程度使得特征Y的信息熵减少的程度
贷款特征重要计算
我们以年龄特征来计算:
g(D, 年龄) = H(D) -H(D|年龄) = 0.971-[5/15H(青年)+5/15H(中年)+5/15H(老年] H(D) = -(6/15log(6/15)+9/15log(9/15))=0.971 H(青年) = -(3/5log(3/5) +2/5log(2/5)) 我们以A1、A2、A3、A4代表年龄、有工作、有自己的房子和贷款情况。最终计算的结果
g(D, A1) = 0.313 g(D, A2) = 0.324 g(D, A3) = 0.420 g(D, A4) = 0.363 所以我们选择A3 作为划分的第一个特征。这样我们就可以慢慢建立一棵树
决策树的三种算法实现
当然决策树的原理不止信息增益这一种,还有其他方法。但是原理都类似,我们就不去举例计算。
ID3 C4.5 CART分类树: 基尼(gini)系数最小的准则 在sklearn中可以选择划分的默认原则 优势:划分更加细致(从后面例子的树显示来理解) 决策树API
class sklearn.tree.DecisionTreeClassifier(criterion=’gini’, max_depth=None,random_state=None)决策树分类器 criterion:默认是’gini’系数,也可以选择信息增益的熵’entropy’ max_depth:树的深度大小 random_state:随机数种子 其中会有些超参数:max_depth:树的深度大小 案例:泰坦尼克号乘客生存预测
在泰坦尼克号和titanic2数据帧描述泰坦尼克号上的个别乘客的生存状态。这里使用的数据集是由各种研究人员开始的。其中包括许多研究人员创建的旅客名单,由Michael A. Findlay编辑。我们提取的数据集中的特征是票的类别,存活,乘坐班,年龄,登陆,home.dest,房间,票,船和性别。
1、乘坐班是指乘客班(1,2,3),是社会经济阶层的代表。
2、其中age数据存在缺失。
数据:
泰坦尼克号幸存者数据集(Titanic Dataset)-飞桨AI Studio - 人工智能学习实训社区 (baidu.com)
分析
选择我们认为重要的几个特征 ['pclass', 'age', 'sex'] 填充缺失值 特征中出现类别符号,需要进行one-hot编码处理(DictVectorizer)x.to_dict(orient="records") 需要将数组特征转换成字典数据 数据集划分 决策树分类预测 代码
# Imports
import pandas as pd
from sklearn.tree import DecisionTreeClassifier
from sklearn.feature_extraction import DictVectorizer
from sklearn.model_selection import train_test_split


%matplotlib inline

# 1、获取数据
titan = pd.read_csv('../data/data54777/train.csv')

# 2、数据的处理
X = titan[['Pclass', 'Age', 'Sex']]
y = titan['Survived']

# print(x , y)
# 缺失值需要处理,将特征当中有类别的这些特征进行字典特征抽取
# inplace 替换原始数据
X['Age'].fillna(X['Age'].mean(), inplace=True)

# 对于x转换成字典数据x.to_dict(orient="records")
dict = DictVectorizer(sparse=False)

X = dict.fit_transform(X.to_dict(orient="records"))

# ['Age', 'Pclass', 'Sex=female', 'Sex=male']
print(dict.get_feature_names())
print(X)
['Age', 'Pclass', 'Sex=female', 'Sex=male']
[[22.          3.          0.          1.        ]
 [38.          1.          1.          0.        ]
 [26.          3.          1.          0.        ]
 ...
 [29.69911765  3.          1.          0.        ]
 [26.          1.          0.          1.        ]
 [32.          3.          0.          1.        ]]
# 分割训练集合测试集
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3)
# 进行决策树的建立和预测
dc = DecisionTreeClassifier(max_depth=5)
dc.fit(X_train, y_train)
print("预测的准确率为:", dc.score(X_test, y_test))预测的准确率为: 0.7947761194029851
运行时长:7毫秒结束时间:2021-12-30 22:26:20由于决策树类似一个树的结构,我们可以保存到本地显示
保存树的结构到dot文件
1、sklearn.tree.export_graphviz() 该函数能够导出DOT格式tree.export_graphviz(estimator,out_file='tree.dot’,feature_names=[‘’,’’]) 2、工具:(能够将dot文件转换为pdf、png)安装graphviz ubuntu:sudo apt-get install graphviz Mac:brew install graphviz 3、运行命令然后我们运行这个命令 dot -Tpng tree.dot -o tree.png from sklearn.tree import export_graphviz
export_graphviz(dc, out_file="./tree.dot", feature_names=['Age', 'Pclass', 'Sex=female', 'Sex=male'])./tree.dot
digraph Tree {
node [shape=box] ;
0 [label="Sex=male <= 0.5\ngini = 0.473\nsamples = 623\nvalue = [384, 239]"] ;
1 [label="Pclass <= 2.5\ngini = 0.379\nsamples = 224\nvalue = [57, 167]"] ;
0 -> 1 [labeldistance=2.5, labelangle=45, headlabel="True"] ;
2 [label="Age <= 2.5\ngini = 0.096\nsamples = 119\nvalue = [6, 113]"] ;
1 -> 2 ;
3 [label="gini = 0.0\nsamples = 1\nvalue = [1, 0]"] ;
2 -> 3 ;
4 [label="Age <= 24.5\ngini = 0.081\nsamples = 118\nvalue = [5, 113]"] ;
2 -> 4 ;
5 [label="gini = 0.0\nsamples = 37\nvalue = [0, 37]"] ;
4 -> 5 ;
6 [label="Age <= 27.5\ngini = 0.116\nsamples = 81\nvalue = [5, 76]"] ;
4 -> 6 ;
7 [label="gini = 0.469\nsamples = 8\nvalue = [3, 5]"] ;
6 -> 7 ;
8 [label="gini = 0.053\nsamples = 73\nvalue = [2, 71]"] ;
6 -> 8 ;
9 [label="Age <= 36.0\ngini = 0.5\nsamples = 105\nvalue = [51, 54]"] ;
1 -> 9 ;
10 [label="Age <= 1.5\ngini = 0.496\nsamples = 97\nvalue = [44, 53]"] ;
9 -> 10 ;
11 [label="gini = 0.0\nsamples = 3\nvalue = [0, 3]"] ;
10 -> 11 ;
12 [label="Age <= 3.5\ngini = 0.498\nsamples = 94\nvalue = [44, 50]"] ;
10 -> 12 ;
13 [label="gini = 0.32\nsamples = 5\nvalue = [4, 1]"] ;
12 -> 13 ;
14 [label="gini = 0.495\nsamples = 89\nvalue = [40, 49]"] ;
12 -> 14 ;
15 [label="Age <= 55.5\ngini = 0.219\nsamples = 8\nvalue = [7, 1]"] ;
9 -> 15 ;
16 [label="gini = 0.0\nsamples = 7\nvalue = [7, 0]"] ;
15 -> 16 ;
17 [label="gini = 0.0\nsamples = 1\nvalue = [0, 1]"] ;
15 -> 17 ;
18 [label="Age <= 6.5\ngini = 0.296\nsamples = 399\nvalue = [327, 72]"] ;
0 -> 18 [labeldistance=2.5, labelangle=-45, headlabel="False"] ;
19 [label="Pclass <= 2.5\ngini = 0.391\nsamples = 15\nvalue = [4, 11]"] ;
18 -> 19 ;
20 [label="gini = 0.0\nsamples = 6\nvalue = [0, 6]"] ;
19 -> 20 ;
21 [label="Age <= 2.5\ngini = 0.494\nsamples = 9\nvalue = [4, 5]"] ;
19 -> 21 ;
22 [label="Age <= 1.5\ngini = 0.48\nsamples = 5\nvalue = [3, 2]"] ;
21 -> 22 ;
23 [label="gini = 0.444\nsamples = 3\nvalue = [1, 2]"] ;
22 -> 23 ;
24 [label="gini = 0.0\nsamples = 2\nvalue = [2, 0]"] ;
22 -> 24 ;
25 [label="Age <= 3.5\ngini = 0.375\nsamples = 4\nvalue = [1, 3]"] ;
21 -> 25 ;
26 [label="gini = 0.0\nsamples = 1\nvalue = [0, 1]"] ;
25 -> 26 ;
27 [label="gini = 0.444\nsamples = 3\nvalue = [1, 2]"] ;
25 -> 27 ;
28 [label="Pclass <= 1.5\ngini = 0.267\nsamples = 384\nvalue = [323, 61]"] ;
18 -> 28 ;
29 [label="Age <= 37.5\ngini = 0.444\nsamples = 81\nvalue = [54, 27]"] ;
28 -> 29 ;
30 [label="Age <= 33.5\ngini = 0.494\nsamples = 45\nvalue = [25, 20]"] ;
29 -> 30 ;
31 [label="gini = 0.467\nsamples = 35\nvalue = [22, 13]"] ;
30 -> 31 ;
32 [label="gini = 0.42\nsamples = 10\nvalue = [3, 7]"] ;
30 -> 32 ;
33 [label="Age <= 47.5\ngini = 0.313\nsamples = 36\nvalue = [29, 7]"] ;
29 -> 33 ;
34 [label="gini = 0.0\nsamples = 14\nvalue = [14, 0]"] ;
33 -> 34 ;
35 [label="gini = 0.434\nsamples = 22\nvalue = [15, 7]"] ;
33 -> 35 ;
36 [label="Age <= 32.25\ngini = 0.199\nsamples = 303\nvalue = [269, 34]"] ;
28 -> 36 ;
37 [label="Age <= 30.5\ngini = 0.24\nsamples = 237\nvalue = [204, 33]"] ;
36 -> 37 ;
38 [label="gini = 0.208\nsamples = 221\nvalue = [195, 26]"] ;
37 -> 38 ;
39 [label="gini = 0.492\nsamples = 16\nvalue = [9, 7]"] ;
37 -> 39 ;
40 [label="Age <= 43.5\ngini = 0.03\nsamples = 66\nvalue = [65, 1]"] ;
36 -> 40 ;
41 [label="gini = 0.0\nsamples = 40\nvalue = [40, 0]"] ;
40 -> 41 ;
42 [label="gini = 0.074\nsamples = 26\nvalue = [25, 1]"] ;
40 -> 42 ;
}
文件里描述了决策树, 但这样看不是很直观, 可以安装 graphviz 工具将dot文件转成图片文件:
sudo apt-get install graphviz
dot -Tpng tree.dot -o tree.png
tree.png
决策树总结
优点: 缺点:决策树学习者可以创建不能很好地推广数据的过于复杂的树,这被称为过拟合。 改进:减枝cart算法(决策树API当中已经实现,随机森林参数调优有相关介绍) 随机森林 注:企业重要决策,由于决策树很好的分析能力,在决策过程应用较多, 可以优先选择区分度大的特征.
集成学习方法之随机森林
学习目标说名随机森林每棵决策树的建立过程 知道为什么需要随机有放回(Bootstrap)的抽样 说明随机森林的超参数 具体应用 什么是集成学习方法
集成学习通过建立几个模型组合的来解决单一预测问题。它的工作原理是生成多个分类器/模型 ,各自独立地学习和作出预测。这些预测最后结合成组合预测,因此优于任何一个单分类的做出预测。
什么是随机森林
在机器学习中,随机森林是一个包含多个决策树的分类器 ,并且其输出的类别是由个别树输出的类别的众数 而定。
例如, 如果你训练了5个树, 其中有4个树的结果是True, 1个数的结果是False, 那么最终投票结果就是True
随机森林原理过程
学习算法根据下列算法而建造每棵树:
用N来表示训练用例(样本)的个数,M表示特征数目。一次随机选出一个样本,重复N次, (有可能出现重复的样本) 随机去选出m个特征, m <<M,建立决策树 采取bootstrap抽样 为什么采用BootStrap抽样
为什么要随机抽样训练集? 如果不进行随机抽样,每棵树的训练集都一样,那么最终训练出的树分类结果也是完全一样的 为什么要有放回地抽样?如果不是有放回的抽样,那么每棵树的训练样本都是不同的,都是没有交集的,这样每棵树都是“有偏的”,都是绝对“片面的”(当然这样说可能不对),也就是说每棵树训练出来都是有很大的差异的;而随机森林最后分类取决于多棵树(弱分类器)的投票表决。 API
class sklearn.ensemble.RandomForestClassifier(n_estimators=10, criterion=’gini’, max_depth=None, bootstrap=True, random_state=None, min_samples_split=2)随机森林分类器 n_estimators:integer,optional(default = 10)森林里的树木数量120,200,300,500,800,1200 criteria:string,可选(default =“gini”)分割特征的测量方法 max_depth:integer或None,可选(默认=无)树的最大深度 5,8,15,25,30 max_features="auto”,每个决策树的最大特征数量If "auto", then max_features=sqrt(n_features). If "sqrt", then max_features=sqrt(n_features) (same as "auto"). If "log2", then max_features=log2(n_features). If None, then max_features=n_features. bootstrap:boolean,optional(default = True)是否在构建树时使用放回抽样 min_samples_split:节点划分最少样本数 min_samples_leaf:叶子节点的最小样本数 超参数:n_estimator, max_depth, min_samples_split,min_samples_leaf 代码
import pandas as pd
from sklearn.feature_extraction import DictVectorizer
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import GridSearchCV
from sklearn.model_selection import train_test_split

# 1、获取数据
titan = pd.read_csv('../data/data54777/train.csv')

# 2、数据的处理
X = titan[['Pclass', 'Age', 'Sex']]
y = titan['Survived']

# print(x , y)
# 缺失值需要处理,将特征当中有类别的这些特征进行字典特征抽取
# inplace 替换原始数据
X['Age'].fillna(X['Age'].mean(), inplace=True)

# 对于x转换成字典数据x.to_dict(orient="records")
dict = DictVectorizer(sparse=False)

X = dict.fit_transform(X.to_dict(orient="records"))

# 分割训练集合测试集
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3)

# 随机森林去进行预测
rf = RandomForestClassifier()

param = {"n_estimators": [120,200,300,500,800,1200], "max_depth": [5, 8, 15, 25, 30]}

# 超参数调优
gc = GridSearchCV(rf, param_grid=param, cv=2)

gc.fit(X_train, y_train)

print("随机森林预测的准确率为:", gc.score(X_test, y_test))
随机森林预测的准确率为: 0.7574626865671642
总结
在当前所有算法中,具有极好的准确率 能够有效地运行在大数据集上,处理具有高维特征的输入样本,而且不需要降维 能够评估各个特征在分类问题上的重要性 回顾:
1、估计器的工作流程是什么?
答案:
第一步: 实例化估计器
第二步: 调用估计器的fit函数, 用训练集的特征值和目标值训练
第三步: 调用预测函数predict, 用测试集的特征值预测
2、决策树的划分依据是什么?(课程介绍的主要方法)
答案: 根据更具信息增益的属性来划分.
3、编程: 通过K近邻算法对鸢尾花数据集进行分类预测
Views: 182